读懂 IndexCache:从 DSA 的选词开销到跨层索引复用
发布于
秋染指头 岁月流金
读懂 IndexCache:从 DSA 的选词开销到跨层索引复用
引言:DSA 已经稀疏了,为什么还要优化 Indexer?
长上下文推理中,模型需要反复从大量历史 Token 中寻找与当前 Query 相关的信息。DSA(DeepSeek Sparse Attention)通过“先选择、再计算”减少了主要注意力的计算范围,但选择本身仍然有成本:每一层的 Indexer 都需要对历史位置打分,再找出当前 Query 对应的 Top-k Token。上下文越长,这部分开销就越值得关注。
一张图回顾 DSA,以及它留下的问题
对于某一层中的一个 Query,Lightning Indexer 先对因果范围内的历史位置打分,Top-k 选择得到一组位置索引;随后,Core Attention 使用当前层自己的 Q/K/V,在这些位置上完成稀疏注意力计算。论文实验中使用的 k 为 2048。
原始 DSA 中,每一层都会独立运行 Indexer。单看一层,这个模块已经比较轻量;但把长上下文和几十个 Transformer 层放在一起,逐层选择的成本就会累积起来。Core Attention 的计算范围缩小后,选择阶段所占的时间反而可能更加突出。这个问题同时存在于 Prefill 和 Decode:前者需要为整段输入进行选择,后者则需要为新生成 Token 对应的 Query 重新选择历史位置。
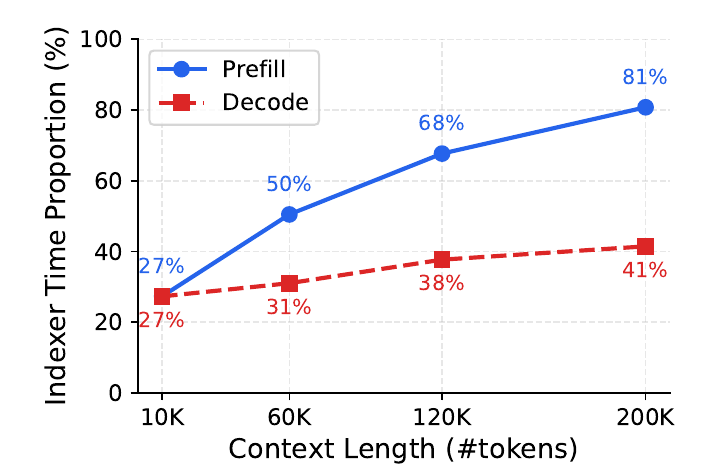
来源:原论文第 2 页。上下文达到 200K 时,Indexer 的耗时占比在 Prefill 中达到 81%,在 Decode 中达到 41%。
IndexCache 的依据来自一个经验观察:相邻层的 Top-k 选择具有较高的重合度。 这意味着,一些 Indexer 可能在反复寻找近似的一组 Token。
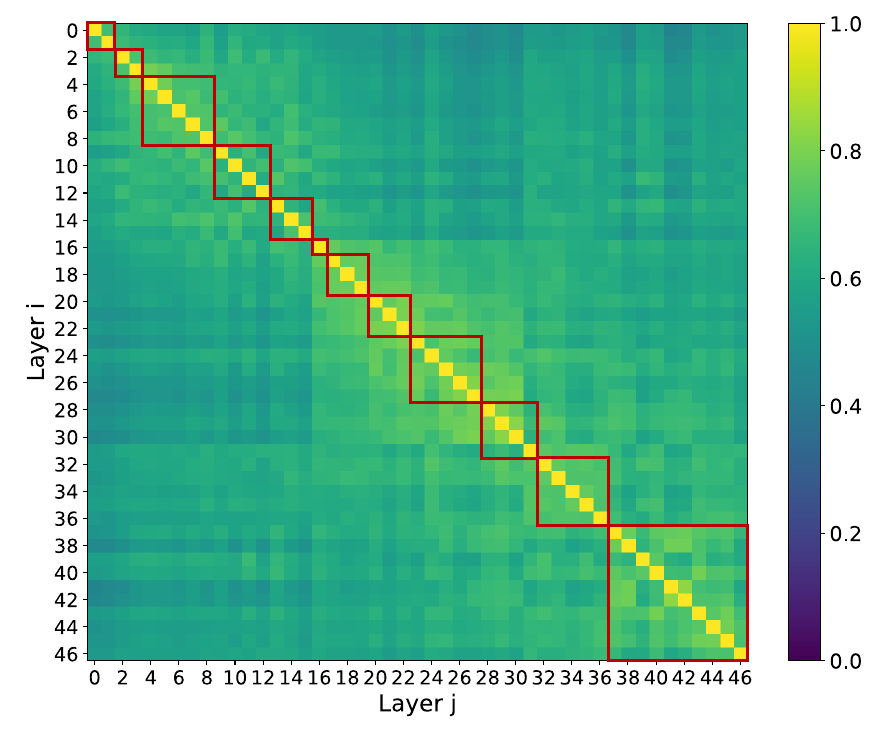
来源:原论文 Figure 4,第 16 页。横纵轴为层编号,越接近黄色,两层选中 Token 的重合率越高。
这一观察为跨层索引复用提供了依据。接下来,理解 IndexCache 可以沿着三个问题展开:
- 怎样通过跨层索引复用,减少 Indexer 的重复计算?
- 不更新模型权重时,如何选择保留 Indexer 的层,尽量维持模型质量?
- 允许训练时,如何让保留的 Indexer 学会服务多个层?
第 1 章:IndexCache 如何工作——一次选择,供后续多个层使用
IndexCache 保留了 DSA 的稀疏注意力计算,只改变一件事:不是每一层都重新选择 Token,一部分层可以直接使用前面层选好的位置。 为了实现这一点,论文把 Transformer 层分成 F 和 S 两种角色。
1.1 F 层负责选择,S 层负责复用
F(Full)层保留自己的 Indexer,像标准 DSA 一样计算分数、选择 Top-k,再使用这些索引执行本层的 Sparse Core Attention。同时,它把这组索引保存下来,供后续层复用。
S(Shared)层不运行自己的 Indexer,而是直接拿到最近一个前置 F 层生成的索引,用它执行本层的 Sparse Core Attention。
以一个八层模型为例,可以把层的角色写成下面的模式:
灰色箭头表示层间状态传递,橙色箭头表示同一个 Query 位置的索引复用;各层仍使用自己的 K/V。
在这个例子中,Layer 1 生成一份索引,Layer 2、3、4 都使用它;Layer 5 再生成一份新索引,Layer 6、7、8 改用 Layer 5 的结果。因此,原本八次独立的 Indexer 计算,现在只需要两次。
第一层必须设为 F,否则后面的 S 层没有初始索引可用。
1.2 缓存怎样更新:共享位置,不共享注意力结果
可以把推理中的索引缓存理解为一个变量:它始终指向最近一次 F 层生成的 Top-k 索引张量。遇到 F 层就更新它,遇到 S 层就读取它。
对应到论文 Figure 2 的推理循环,核心逻辑很短:
T_cache = 空
for 每一层 layer:
    if layer 是 F:
        scores = layer.indexer(X)
        T_cache = TopK(scores)

    X = layer.sparse_attention(X, T_cache)
    X = layer.ffn(X)
这段伪代码省略了归一化、残差连接等细节,只展示索引复用的变化。
例如,对同一个 Query 位置,Layer 1 选出了历史位置 {2, 5, 8}(这里只用三个位置示意)。Layer 2 复用的就是这三个位置,但读取的是 Layer 2 自己在这些位置上的 K/V,再结合本层的 Query 计算注意力。它不会直接拿走 Layer 1 的 K/V、注意力权重或注意力输出。
对比标准 DSA,IndexCache 的计算变化如下:
| 计算模块 | 标准 DSA | IndexCache |
|---|---|---|
| Indexer 打分与 Top-k 选择 | 每层执行 | 只在 F 层执行 |
| Sparse Core Attention、FFN 等 | 每层执行 | 每层执行 |
若 N 层中保留 M 个 Indexer,长度为 L 的输入在 Prefill 阶段的 Indexer 计算规模便从 O(NL²) 降至 O(ML²)。
第 2 章:Training-free——不改权重,怎样选择保留的 Indexer?
复用机制确定以后,接下来要决定哪些层是 F、哪些层是 S。Training-free IndexCache 面向已经训练好的 DSA 模型:保持模型权重不变,通过搜索选择一组尽量维持模型质量的 F/S 配置。
2.1 固定间隔为什么不够好?
最直接的办法就是沿用前面的八层示例,每隔四层保留一个 Indexer,得到 FSSSFSSS。这种均匀交错的方式很简单,但默认了各层都同样适合共享索引。
实际情况并非如此。论文发现,不同层对移除自身 Indexer 的敏感程度不同,某些早期层和过渡区域尤其敏感。固定间隔可能恰好把关键层设为 S,让它使用并不合适的索引;同时,又保留了一些本来可以共享的 Indexer。
配置与敏感层均为教学示意,不代表论文实际搜索结果。
既然前面已经看到跨层选择高度重合,能不能直接按相似度分组?作者在 Appendix C 中尝试过:比较某层使用自己的索引和复用前层索引时,Core Attention 输出的余弦相似度,再据此搜索配置。但这种方法的下游表现没有明显优于均匀交错。
根据原论文 Appendix C 绘制。比较的是同一层替换索引前后的注意力输出,而不是两个层各自的输出。
问题在于,单层输出相似,不足以判断最终模型质量是否得到保留。 少量变化经过后续层的传播,可能影响最终预测,而局部相似度没有直接衡量这种影响。因此,作者选择用整个模型的语言建模损失(LM Loss)评价共享决策。
2.2 用 LM Loss 一步步决定哪些层共享
贪心搜索的思路是:每次尝试让一个层跳过 Indexer,选出 LM Loss 最低的修改,然后在新配置上继续搜索。
搜索从全 F 开始,第一层固定为 F。搜索前先固定一组用于评价配置的文本样本。之后,每个候选配置都在同样的样本上运行模型并计算 LM Loss,让不同配置的结果可以直接比较。
继续用八层模型举例。第一轮有七个候选:分别尝试把 Layer 2 到 Layer 8 中的一个层改为 S,其余保持 F。每个候选都单独评价,最后只提交其中 Loss 最低的一个修改。假设第一轮选中了 Layer 3,当前配置便从 FFFFFFFF 变为 FFSFFFFF。第二轮在这个新配置上,继续尝试将剩余候选中的一个 F 改为 S。
八层配置和图中 Loss 均为教学示意。每轮只提交一个修改;省略号表示其他待评价候选。
每确定一个共享层,下一轮都要基于新配置重新比较。例如,第一轮 Layer 3 变为 S 后,它使用 Layer 2 的索引;如果第二轮又把 Layer 2 改为 S,那么 Layer 2 和 Layer 3 都会改用 Layer 1 的索引。这次修改的影响,已经不同于在全 F 配置下单独跳过 Layer 2。因此,不能一开始给每个层排一次名,就按排名连续删除。
这也是 Training-free 的成本所在:虽然无需训练,但需要离线执行多次候选前向评价。
作者提到局限性:贪心算法每轮选择当前 Loss 最低的修改,并不保证得到全局最优配置。它的价值在于把选层依据落到端到端预测上,而最终模型质量是否保住,仍要通过后面的任务评测验证。
第 3 章:Training-aware——让一个 Indexer 学会服务多个层
Training-free 是在已有模型中寻找适合共享的层。但原始 DSA 的每个 Indexer 都是针对本层训练的,让它直接服务后面几层,选出的 Token 未必符合这些层的需求。如果允许训练,就可以进一步改变监督目标,让保留的 Indexer 从一开始就学习兼顾多个层。
3.1 从一层的监督,变成多层的监督
先回顾这里需要的蒸馏关系。在 DSA 中,把某一层各个 Attention Head 的注意力权重取平均,可以得到这层关注历史位置的分布,记为 p。Indexer 的打分经过 Softmax,也得到一个位置分布,记为 q。训练时通过 KL 散度让 q 接近 p,相当于让 Indexer 学习本层“哪些位置更值得关注”。
现在假设 Layer 1 是 F,后面的 Layer 2、3、4 都是 S。Layer 1 的 Indexer 需要为四层提供索引,只学习 Layer 1 的 p 就不够了。多层蒸馏把这四层的 Attention 分布都作为监督目标,共同训练 Layer 1 的同一个 Indexer。
图中展示训练监督关系。右侧四个 KL 使用同一个预测分布 q,目标分布分别来自 F 层及其服务的三个 S 层。
对一个 Query 位置 t,四层分别给出目标分布,而 Indexer 只给出一份预测分布。**训练时分别计算它与四个目标的 KL,再取平均。**推广到一个 F 层 ℓ 服务自己和后面 m 个 S 层,就得到论文的多层蒸馏损失:
这里的 j 遍历被服务的层,t 遍历 Query 位置。例如 F+3S 中 m=3,共有四个目标 p,但它们都在指导同一个 q。这样训练出的 Indexer,选择位置时就需要兼顾这一组层的需求。
3.2 多层监督的直觉:综合各层的关注需求
一个 Indexer 要服务多个层,如果这些层关注的位置不同,它应该听谁的?多层蒸馏的作用,就是让它综合考虑这些层的需求。
用两层、三个历史位置举例。假设两层对同一个 Query 的 Attention 分布如下:
| 目标分布 | 位置 A | 位置 B | 位置 C |
|---|---|---|---|
| F 层 | 0.8 | 0.1 | 0.1 |
| S 层 | 0.2 | 0.7 | 0.1 |
| 两层平均 | 0.5 | 0.4 | 0.1 |
表中数值仅为教学示意。
只学习 F 层时,Indexer 会更偏向位置 A;但 S 层还需要关注位置 B。综合两层的目标后,A 和 B 都获得较高权重,C 则仍然较低。它学到的是一份兼顾多层需求的位置分布,再据此选择 Top-k。 这不保证每层的需求都能被完全满足,但比只学习 F 层的目标更符合共享的用途。
这里有两种不同的计算顺序:
- 3.1 的实际做法是分别计算多个 KL,再把 Loss 取平均;
- 这里的直觉则是先把各层目标分布平均,再让 Indexer 学习这个综合目标。
它们的计算顺序不同,为什么能放在一起理解?
作者这里要证明的是:这两种训练方式,对 Indexer 参数产生相同的梯度。
| 训练方式 | 计算顺序 |
|---|---|
| 多层蒸馏 | 同一个 q 分别与各层 p 计算 KL,再把 Loss 平均 |
| 平均目标蒸馏 | 先把各层 p 平均成一个目标,再与 q 计算一次 KL |
先定义各层目标的平均分布:
如果直接让 Indexer 拟合这个平均目标,损失为:
现在比较这个损失与 3.1 的多层蒸馏损失。展开 KL,可以把它分成目标自身的项与拟合预测的项:
其中 s 是历史位置。对 Indexer 参数 θ 求导时,目标 p 视为常量,因此只有第二项参与更新。把多个 KL 取平均,相当于把这一项中 q 前面的权重 p 换成平均目标:
中括号里的分布正是前面定义的平均目标。C 汇总了只与目标分布有关的项;拟合平均目标的损失具有相同的后半部分,只是常量项不同。因此:
因此,“分别计算 KL 再平均”与“先平均目标再计算 KL”,对 Indexer 产生相同的梯度。论文实际采用前一种多层 KL 形式;后一种写法说明,它确实在引导 Indexer 学习所服务各层的平均需求。
3.3 怎样训练:先适配 Indexer,再共同适配模型
有了多层蒸馏目标,接下来要把它放进实际训练流程。这里采用的是前后衔接的两个阶段:Dense Warm-up 先训练保留的 Indexer,Sparse Training 再让模型适应实际的稀疏共享路径。 两个阶段都使用多层蒸馏,但注意力的计算范围和参数的更新方式不同。
第一阶段:Dense Warm-up,先让 Indexer 学会为多层选择位置
这一阶段,模型仍使用 Dense Attention:每个 Query 可以关注因果范围内的全部历史位置,Core Attention 的计算暂时不受 Indexer 的 Top-k 选择限制。因此,各层能够提供覆盖完整历史位置的 Attention 分布,作为蒸馏目标。
继续用 Layer 1 服务 Layer 1、2、3、4 的例子。一次训练前向计算中:
- 四层各自执行 Attention,把各 Head 的权重取平均,得到本层的目标分布。
- Layer 1 的 Indexer 输出一份预测分布 q,分别与这四个目标计算 KL,再将损失取平均。
- 用这个多层蒸馏损失更新 Layer 1 的 Indexer,其他模型参数全部冻结。其余 F 层也按各自服务的层组进行相同训练。
冻结其他参数,是为了先让 Indexer 学习模型当前的关注需求。 这一阶段的任务是把位置选择学好,模型的 Attention、FFN 等模块仍保持原来的参数。
第二阶段:Sparse Training,让模型适应实际的共享路径
Warm-up 之后,启用真正的 Top-k 选择与跨层复用。Layer 1 的 Indexer 选出一组位置,Layer 1、2、3、4 都在这组位置上执行各自的 Sparse Core Attention。这一阶段就开始采用推理时的索引共享方式,让模型在训练中适应“F 层选择位置、S 层复用位置”的稀疏注意力计算。
这一阶段同时保留两条学习信号,分别更新不同的参数:
- 多层蒸馏损失继续训练保留的 Indexer。 Indexer 先对历史位置打分并选出 Top-k。各层只在这些位置上计算 Attention,得到各自的目标分布;同时,取出 Indexer 在这些位置上的分数,经 Softmax 得到预测分布。再像前面一样,分别计算多个 KL 并取平均。
与 Warm-up 相比,蒸馏时比较的范围从完整历史位置变成了本次选中的 Top-k 位置。
- LM Loss 更新模型的其他参数。 模型根据输入预测下一个 Token,用最终预测与真实答案之间的差距更新 Attention、FFN 等模块。这样,S 层可以逐步适应继承来的位置集合,整个模型也能调整中间表示,尽量保住最终预测能力。
两条信号各有作用:蒸馏告诉 Indexer“这些层关注哪些位置”,LM Loss 则告诉模型“沿着当前共享路径,最终预测得好不好”。这里LM Loss 不会直接穿过离散的 Top-k 操作来训练 Indexer;论文使用蒸馏信号训练 Indexer,使用 LM Loss 训练其余模型参数。
第一阶段只完成了位置选择器的适配;第二阶段进一步允许被服务的层调整自己。比如 Layer 2 原来使用自己的 Indexer,现在改用 Layer 1 选出的位置,它的注意力投影等参数也可以通过 LM Loss 更新,从而更好地利用这些位置。
| 对比项 | Dense Warm-up | Sparse Training |
|---|---|---|
| Core Attention 范围 | 完整的因果历史位置 | F 层选出的 Top-k 位置,供后续 S 层复用 |
| 多层蒸馏的范围 | 完整位置分布 | 当前选中的 Top-k 位置 |
| 保留的 Indexer | 由多层蒸馏损失更新 | 继续由多层蒸馏损失更新 |
| 其余模型参数 | 冻结 | 由 LM Loss 更新 |
论文的 Training-aware 实验使用 1,000 步 Dense Warm-up 和 4,000 步 Sparse Training。经过这两个阶段,保留的 Indexer 学习为多个层选择位置,各层也学习在共享索引下完成计算。因此,Training-aware 可以采用均匀交错配置,再通过训练适应共享结构;具体效果在下一章的实验中展开。
第 4 章:实验——更快了吗,模型质量保住了吗?
前面两条路线最终都要回答同一个问题:省掉大量 Indexer 计算后,推理能快多少,模型质量又会损失多少?论文的主要实验使用一个由 GLM-4.7-Flash 转换得到的 DSA 模型:总参数 30B、每个 Token 激活约 3B 参数,共 47 层。质量评测覆盖五个长上下文任务和四个通用与推理任务。以下数字均来自论文报告。
4.1 速度:上下文越长,收益越明显
速度测试在 NVIDIA H100 节点上进行,推理框架为 SGLang,开启 DP Attention,dp_size=8。作者比较原始 DSA 与保留 1/2、1/4 Indexer 的 IndexCache,测试上下文长度从 10K 到 200K。
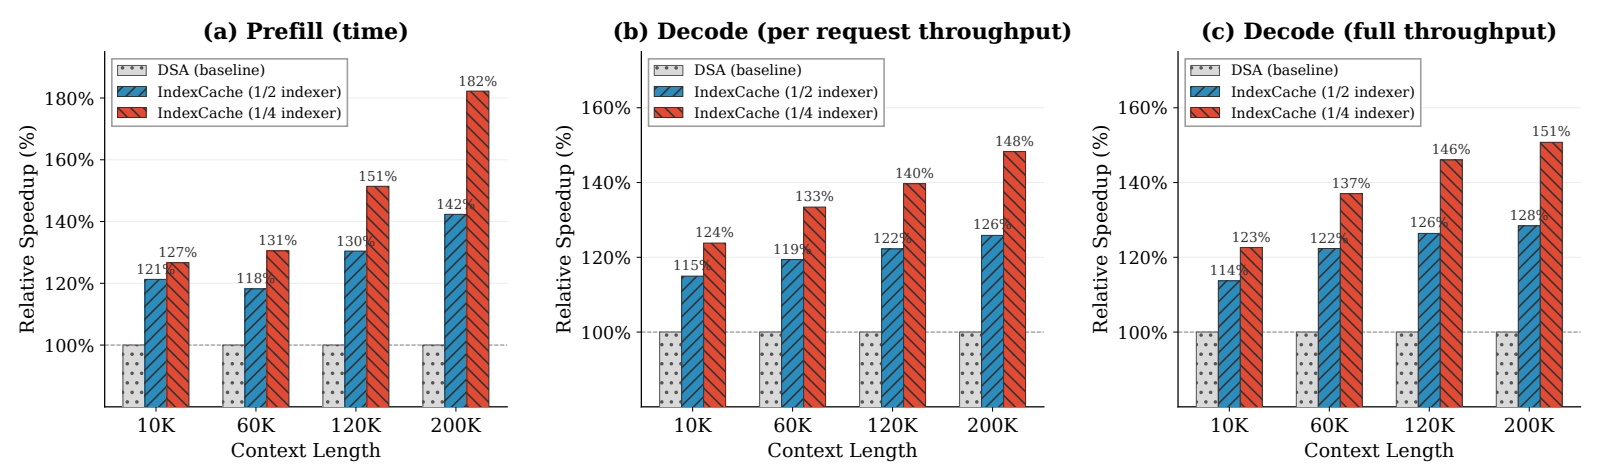
来源:原论文 Figure 3,第 8 页。DSA 归一化为 100%;例如 182% 表示速度为基线的 1.82 倍。
三张子图分别对应 Prefill、单请求 Decode,以及 KV Cache 充分利用时的总 Decode 吞吐。保留 1/4 Indexer 时,上下文从 10K 增至 200K,Prefill 加速从 1.27 倍增至 1.82 倍,单请求 Decode 加速从 1.24 倍增至 1.48 倍。长上下文中,减少逐层选择的收益更加明显。
把 200K 上下文、保留 1/4 Indexer 的结果单独拿出来,可以看到实际等待时间与生成速度的变化:
| 指标 | 原始 DSA | IndexCache(保留 1/4) | 加速比 |
|---|---|---|---|
| Prefill 耗时,越低越好 | 19.5 s | 10.7 s | 1.82× |
| 单请求 Decode,越高越好 | 58 tok/s | 86 tok/s | 1.48× |
| 满 KV Cache 总 Decode,越高越好 | 197 tok/s | 297 tok/s | 1.51× |
数据来源:原论文 Table 1,第 7 页。两种 Decode 吞吐均按每 GPU 报告;单请求测试为每 GPU 一个请求,总吞吐测试则尽量填满 KV Cache,每 GPU 约容纳 800K Token。
这一结果与引言中的瓶颈分析相呼应。上下文越长,Indexer 扫描历史位置的成本越突出;IndexCache 减少这部分计算,所以在长上下文中更有价值。不过,Core Attention、FFN 等仍然逐层执行,减少 75% 的 Indexer 计算,并不意味着整个模型加速四倍。
4.2 质量:搜索和训练分别带来了什么?
先看 Training-free:不修改任何模型权重,只改变保留 Indexer 的位置。论文用 Long Avg 汇总五个长上下文任务的分数,用 G&R Avg 汇总四个通用与推理任务的分数,分数越高越好。
| 配置 | Long Avg | G&R Avg |
|---|---|---|
| 原始 DSA | 50.2 | 74.6 |
| 保留 1/4,均匀配置 | 43.0 | 73.8 |
| 保留 1/4,贪心搜索配置 | 49.9 | 74.9 |
| 保留 1/8,贪心搜索配置 | 46.1 | 73.7 |
摘自原论文 Table 2,第 8 页。这里只保留关键配置。
相同的 1/4 保留比例,均匀配置的 Long Avg 从 50.2 降到 43.0,而搜索配置恢复到 49.9。效果差异不仅取决于保留多少 Indexer,还取决于保留的是哪些层。 这正好验证了第二章的选层思路:模型权重固定时,应尽量避免让敏感层失去自己的 Indexer。
但搜索也有边界。进一步压缩到 1/8,Long Avg 仍降到了 46.1,说明不能无限延长索引共享的跨度。
再看 Training-aware。它使用第三章介绍的 1,000 步 Dense Warm-up 和 4,000 步 Sparse Training,让 Indexer 和模型适应共享结构。这组实验的 DSA 基线也经过相同的缩短训练流程,Long Avg 为 51.0,与前表的 50.2 来自不同训练设置,因此应各自在表内比较。
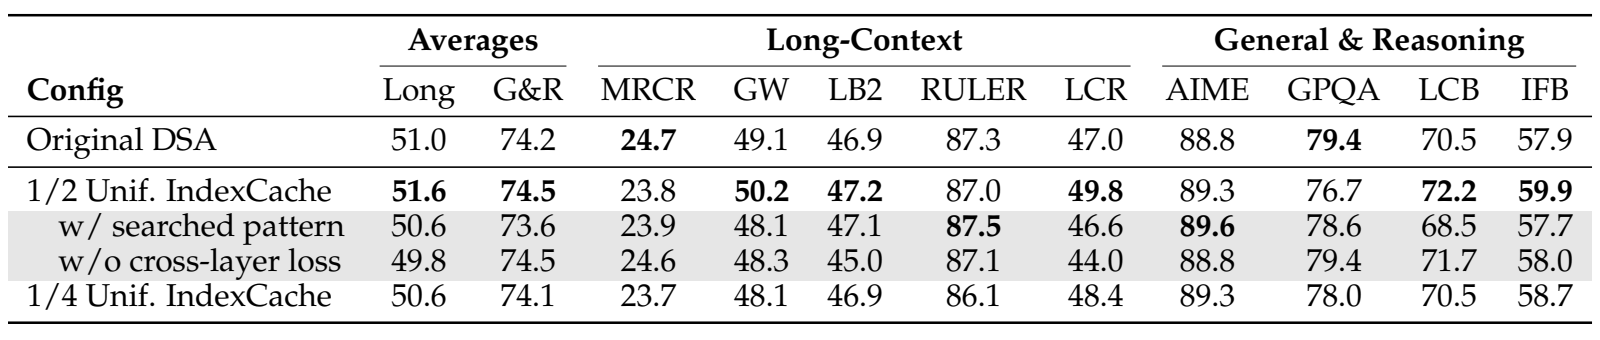
来源:原论文 Table 3,第 9 页。Unif. 为均匀配置;w/ searched pattern 改用搜索配置;w/o cross-layer loss 则只用本层 Attention 监督 Indexer。后两项消融均对应 1/2 保留比例。
这里有两个值得关注的对比。
经过训练,固定间隔保留 Indexer 就能接近基线。
| 配置 | Indexer 如何安排 | Long Avg |
|---|---|---|
| 原始 DSA | 每层保留 | 51.0 |
| 保留 1/4,均匀配置 | 每四层保留一个 | 50.6 |
| 保留 1/2,均匀配置 | 每隔一层保留一个 | 51.6 |
| 保留 1/2,搜索配置 | 沿用免训练阶段搜索得到的位置 | 50.6 |
在这组实验中,模型经过训练适配后,简单的均匀安排已能保住质量;沿用搜索配置没有进一步改善结果。
让 Indexer 同时学习被服务层的需求,比只学习本层更有效。
以下固定为保留 1/2 Indexer 的均匀配置,只改变蒸馏目标:
| Indexer 接受谁的监督 | Long Avg | AA-LCR |
|---|---|---|
| 只学习 F 层自身的 Attention 分布 | 49.8 | 44.0 |
| 同时学习 F 层和所服务 S 层的 Attention 分布 | 51.6 | 49.8 |
共享同一组索引时,把 S 层的需求也纳入 Indexer 的训练目标,能更好地保持模型质量。
两条路线由此形成了清楚的区别:不训练时,搜索帮助模型避开不合适的共享决策;允许训练时,Indexer 和被服务的层可以共同适应共享,均匀配置也能取得接近基线的结果。
4.3 GLM-5:大模型上是否仍然成立?
作者还把 Training-free IndexCache 应用到 GLM-5。它有 744B 总参数、约 40B 激活参数,本身采用 DSA。这部分检验的是:在更大的模型上,不更新权重的索引复用是否仍然有效。
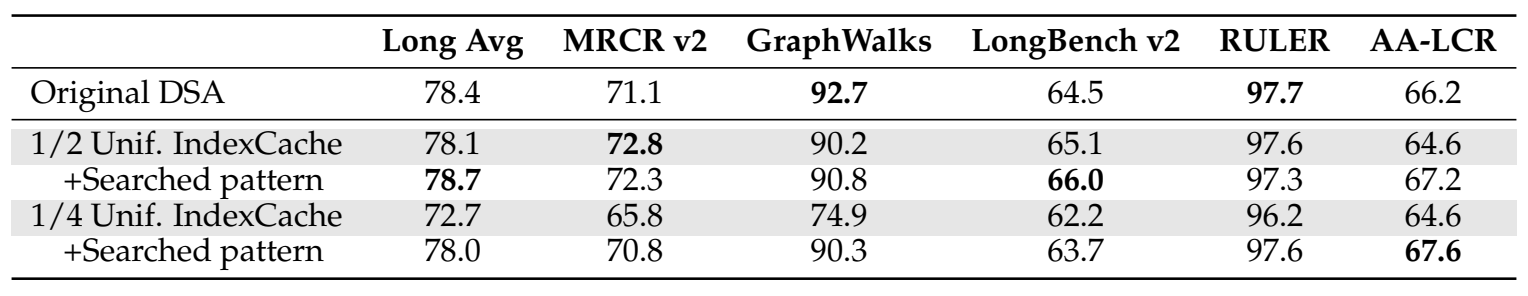
来源:原论文 Table 4,第 10 页。+Searched pattern 表示在对应保留比例下改用搜索配置。
结果与 30B 模型的主要趋势一致。保留 1/4 Indexer 时,均匀配置的 Long Avg 从基线的 78.4 降到 72.7,搜索后恢复到 78.0;保留 1/2 并使用搜索配置时,Long Avg 为 78.7。也就是说,搜索配置在减少大量 Indexer 计算后,仍然较好地保留了这组长上下文评测的平均表现。
速度方面,论文 §4.2 报告:GLM-5 保留 1/4 Indexer、上下文超过 100K 时,Prefill 和 Decode 均达到至少 1.3 倍加速。这个结果对应的是 GLM-5 自身的测试,不能直接套用前面 30B 模型的 1.82 倍数字。
需要保留的边界是,GLM-5 上报告的是 Training-free 结果,Training-aware 仍是作者计划继续验证的方向。现有实验支持跨层索引复用可以扩展到这一规模,但还不能据此推断大模型训练适配后的额外收益。