从Tensor到TinyGPT:读懂一个语言模型的计算与训练
发布于
呕心沥血之作
从 Tensor 到 TinyGPT:读懂一个语言模型的计算与训练
开篇:我们要做一个什么模型?
给模型一句还没写完的话:
我今天想吃
它可能接上“火锅”,也可能接上“米饭”。把选出的内容接到原句后,再继续预测,就能逐步写出一段话。
TinyGPT 就是一个做文字续写的小型语言模型。 我们将一步步拆开它,看看文字在里面经过哪些计算,最终怎样变成对后续内容的预测。
下面这张图是整个模型的地图。先沿着中间一排,从左向右看:文字变成编号,编号变成向量,向量经过加工,再用来预测后续内容。图中展开的内部结构,以及下方“模型怎样学会”的过程,会在后文逐一讲清。
我们从最基础的数字和数组开始,逐步走到这张图里的完整模型。
第 1 章:先学会读 shape,模型就不再是一团黑盒
模型内部虽然有许多模块,但数据在它们之间流动时,始终可以问两个问题:这里保存着多少个数?这些数按什么方式排列?
把这两个问题弄清楚,后面看到向量、矩阵,或者 [B,T,d] 这样的写法,就有了具体的理解。
1.1 Tensor:把数字组织成数组
在本章中,可以先把 Tensor(张量)理解为多维数组。
一个单独的数叫标量,例如 3。把几个数排成一串,就得到一个向量:
[1, 2, 3]再把几串等长的数排成行,就得到一个矩阵:
[
  [1, 2, 3],
  [4, 5, 6]
]
这个矩阵有 2 行、3 列,共 6 个数。继续把多个同样大小的矩阵放在一起,就能得到三维数组。更高维的数组也可以这样逐层理解。
shape(形状)记录的是每个轴有多长。 上面几种数据的 shape 分别是:
| 数据 | shape | 怎么读 |
|---|---|---|
一个数 3 | [] | 没有数组轴,是标量 |
[1,2,3] | [3] | 一条长度为 3 的轴 |
| 2 行 3 列的矩阵 | [2,3] | 2 行,每行 3 个数 |
| 4 个这样的矩阵 | [4,2,3] | 4 组,每组 2 行,每行 3 个数 |
如果 shape 是 [4,2,3],元素总数就是:
4 × 2 × 3 = 24不过,shape 本身只告诉我们大小,不会自动说明每个轴表示什么。同样一个 [2,3],可以是两条记录、每条三个特征,也可以是一张有两行三列的表。轴的含义需要结合数据和计算来理解。
1.2 [B,T,d]:一批文本在模型中的样子
语言模型处理文本时,会先把文本切成小片段,再把每个片段表示成一串数字。这样的片段叫 token;文字怎样切分、怎样得到这些数字,会在第 3 章展开。
现在,假设我们已经得到了一段文本的数字表示:
我   → [0.2, 0.8, -0.1, 0.5]
今天 → [0.7, 0.1,  0.4, 0.9]
想   → [0.3, 0.6,  0.8, 0.2]
这些数是演示用的。每个 token 都用 4 个数表示,3 个 token 放在一起,就组成一个 3 行 4 列的矩阵:
一段文本:3 个 token,每个 token 4 个数
shape = [3,4]
如果一次同时处理两段长度相同的文本,就可以把两张矩阵叠在一起:
2 段文本 × 每段 3 个 token × 每个 token 4 个数
shape = [2,3,4]
这就是语言模型中常见的 [B,T,d]:
| 符号 | 名称 | 这里表示什么 |
|---|---|---|
B | Batch size,批大小 | 一次处理几条序列 |
T | Sequence length,序列长度 | 每条序列有几个 token 位置 |
d | Hidden dimension,隐藏维度 | 每个位置用几个数表示 |
在代码中,可以这样读取:
# x.shape = [2, 3, 4]
x[0]        # 第一条序列,shape = [3, 4]
x[0, 1]     # 第一条序列的第二个位置,shape = [4]
x[0, 1, 2]  # 该位置向量的第三个数,是标量
Python 索引从 0 开始,所以索引 1 对应第二个位置。
以后如果看到 [8,512,4096],也可以用同样的方式读:8 条序列,每条 512 个位置,每个位置用 4096 个数表示。这里的 4096 是每个位置的表示长度,不是 token 数量。
本章先使用等长序列。实际文本长短不一时,可以通过补齐或其他组织方式组成一批数据,这些处理以后再讨论。
1.3 矩阵乘法:一行数字怎样变成另一行数字
模型中的许多运算,都是把一个向量变换成另一个向量。先看一个只有两行的输入:
A = [[1, 2],
     [3, 4]]             shape = [2,2]

W = [[1, 0, 2],
     [0, 1, 1]]          shape = [2,3]
做矩阵乘法 C = A @ W 时,输出的每个数,都由 A 的一行与 W 的一列,对应相乘后相加得到。这种计算叫点积。
例如,输出第一行的第三个数是:
A 的第一行:[1,2]
W 的第三列:[2,1]

1×2 + 2×1 = 4
逐个位置计算后得到:
C = [[1, 2,  4],
     [3, 4, 10]]         shape = [2,3]
W 有三列,每列给出一种“怎样组合输入数字”的规则,因此每个输入行的两个数被变换成了三个输出数。
这也解释了矩阵乘法的 shape 规则:
[m,n] @ [n,p] → [m,p]内侧两个 n 必须相同,因为对应相乘的两串数必须一样长。输出保留左边的行数 m 和右边的列数 p。
例如:
[3,5] @ [5,7] → [3,7]     可以计算
[4,8] @ [16,32]            不能计算,8 与 16 不匹配
代码中的 @ 表示矩阵乘法。它与 * 的逐元素相乘不同:前面算出的第三个输出数,就需要把多个乘积加起来。
1.4 Linear:用同一套规则变换每个位置
Linear 层把刚才的矩阵乘法和一个偏置向量封装起来:
y = x @ W + b其中,x 是输入,W 是权重矩阵,b 是偏置。偏置可以理解为:每个输出分量再加上一个可学习的数。
假设输入向量长度为 4,希望输出长度为 6:
x:[4]
W:[4,6]
b:[6]

输出 y:[6]
W 的六列分别计算六个输出分量,再加上 b 中对应的数字。
如果输入是 [B,T,4],Linear 就对其中每个位置的 4 个数应用同一套 W 和 b,得到:
[B,T,4] → Linear(4,6) → [B,T,6]前面的 B、T 不变,最后一维从 4 变成 6。 这不是把输入 token 数量增加了,而是改变每个 token 的表示长度。
“共享同一套 W 和 b”很重要:无论一次输入多少条序列、每条多长,这个 Linear 层都只有这一套参数。
1.5 shape 没变,为什么还要做一次 Linear?
假设一个层是 Linear(4,4),输入输出都是 [B,T,4]。它并不是原样返回输入,而是重新组合每个位置的数字。
只看其中一个向量,用一个简单的矩阵举例:
x = [1,2]

W = [[1,1],
     [0,1]]

x @ W = [1,3]输入和输出都包含两个数,但数值已经不同了。因此,shape 表示数据的组织大小,不表示数据的具体内容。 后面一些模块会一直保持 [B,T,d],同时不断改变其中的表示。
1.6 输入数据和参数有什么区别?
在 y = x @ W + b 中,x 通常来自本次送进模型的数据;W 和 b 则由这一层持有,是训练中会调整的参数。
可以把它们区分为:
| 对象 | 来源与作用 |
|---|---|
| 输入 x | 本次要处理的数据,换一批输入时通常会变化 |
| 参数 W、b | 这一层采用的变换规则,在训练过程中被调整 |
| 输出 y | 使用当前参数对本次输入进行计算的结果 |
一个 Linear(4,6) 的参数数量是:
W:4 × 6 = 24 个数
b:6 个数
合计:30 个参数
一般来说,带偏置的 Linear(d_in,d_out) 有:
d_in × d_out + d_out个参数。如果设置 bias=False,就不包含最后那 d_out 个偏置参数。
B 和 T 没有出现在这个公式中。把一次输入的序列数或长度增加,会增加要处理的数据和相应计算,但不会增加这一层的参数数量。
1.7 reshape 与 transpose:重新组织数据
除了计算新数值,模型也经常需要整理已有的数据。
reshape 改变数据的形状,保持元素总数不变。 例如:
[2,3,4] → [6,4]

2×3×4 = 6×4 = 24
前面的 B、T 合并,就是这种操作。用六个数看得更清楚:
原矩阵,shape = [2,3]:
[[1,2,3],
 [4,5,6]]

reshape 成 [3,2]:
[[1,2],
 [3,4],
 [5,6]]
对于这个连续排列的例子,可以理解为按原来的读取次序,把数字重新分行。
transpose 则是交换轴(转置)。 对二维矩阵来说,就是行列交换:
同一个原矩阵,交换行列后:
[[1,4],
 [2,5],
 [3,6]]
两种结果的 shape 都是 [3,2],内容排列却不同。reshape 并没有代替行列转置。
对于三维数组,也可以交换指定的轴:
# x.shape = [B, T, d]
y = x.transpose(1, 2)
# y.shape = [B, d, T]
这里的 1、2 是轴编号,从 0 开始;第 0 条轴 B 保持不变。
以后读到这类代码,要同时问:新的 shape 是什么?原来某个位置的数据现在到了哪里? 只核对元素总数,有时会漏掉轴顺序的错误。
1.8 对应到 PyTorch:追踪一次完整的形状变化
下面使用小数组把本章的操作连起来。torch 是 PyTorch 的模块名,nn 提供常用的神经网络层。
import torch
from torch import nn

torch.manual_seed(0)

# 一批演示数据:2 条序列,每条 3 个位置,每个位置 4 个数。
# arange(24) 依次产生 0~23;reshape 将其排成指定形状。
x = torch.arange(24, dtype=torch.float32).reshape(2, 3, 4)

linear = nn.Linear(4, 6)
y = linear(x)

print("输入:", tuple(x.shape))
print("输出:", tuple(y.shape))
print("权重:", tuple(linear.weight.shape))
print("偏置:", tuple(linear.bias.shape))
print("参数量:", sum(p.numel() for p in linear.parameters()))

flat = x.reshape(6, 4)
swapped = x.transpose(1, 2)
print("合并前两轴:", tuple(flat.shape))
print("交换后两轴:", tuple(swapped.shape))
输出为:
输入: (2, 3, 4)
输出: (2, 3, 6)
权重: (6, 4)
偏置: (6,)
参数量: 30
合并前两轴: (6, 4)
交换后两轴: (2, 4, 3)
这里有一个代码细节:前面为了方便理解,按 x @ W 把 W 写成 [输入维度,输出维度]。PyTorch 的 nn.Linear.weight 按 [输出维度,输入维度] 保存权重,计算时使用它的转置:
y_manual = x @ linear.weight.transpose(0, 1) + linear.bias
print(torch.allclose(y, y_manual, atol=1e-5))  # True
两种写法表达的是同一个变换,只是权重的存储方向不同。偏置加法时,长度为 6 的 b 会应用到每个位置的输出行,这叫广播,不需要我们为每个位置复制一份偏置参数。
1.9 自测:能不能只看 shape 解释计算?
先自己判断,再查看答案。
x.shape=[4,128,768],三个数分别表示什么?一共有多少个元素?[3,5] @ [5,7]的输出 shape 是多少?[4,8] @ [16,32]为什么不合法?- 输入
[2,4,12],经过Linear(12,48)后是什么 shape?带偏置时,这一层有多少参数? Linear(12,12)的输入输出 shape 相同,是否说明输出等于输入?[[1,2,3],[4,5,6]]reshape 为[3,2],是否等同于转置?
展开答案与解释
- 4 条序列,每条 128 个位置,每个位置 768 个数;共
4×128×768=393216个元素。 - 输出
[3,7]。后一种乘法内侧维度 8 和 16 不匹配,无法完成相应的行列点积。 - 输出
[2,4,48],参数量为12×48+48=624。B 和 T 不影响参数量。 - 不说明相等。权重与偏置可以改变数值,shape 只说明各轴的长度相同。
- 不等同。reshape 的结果是
[[1,2],[3,4],[5,6]],转置的结果是[[1,4],[2,5],[3,6]]。
读模型代码时,可以从一个习惯开始:每经过一行计算,先写出输入 shape、输出 shape,再说清这一步改变了什么。 现在已经知道输入怎样经过一个层变成输出,下一章再看:输出不够好时,模型该怎样调整这些层中的参数。
第 2 章:模型怎样从一次错误中学到东西
上一章的 Linear 用权重和偏置把输入变成输出。但如果输出与我们想要的答案相差很远,应该怎样修改这些参数?
先从只有一个参数的小模型开始。它虽然还不能处理文字,却能把训练的整个过程展示清楚。
2.1 一个只有一个参数的模型
假设模型的计算规则是:
预测值 = w × xx 是输入,w 是模型中可以调整的参数。我们手上有一条样本:输入是 2,希望模型输出 6。
现在先让 w=1:
| 对象 | 数值 | 含义 |
|---|---|---|
| 输入 x | 2 | 本次交给模型的数据 |
| 目标 y | 6 | 本次样本提供的正确答案 |
| 参数 w | 1 | 模型当前采用的规则 |
| 预测值 | 2 | 用当前参数算出的 1×2 |
预测是 2,目标是 6。对于这个简单模型,我们一眼就能看出,把 w 改成 3 就能得到正确结果。
但真实神经网络有很多参数,计算过程也更复杂,无法靠人逐个猜出合适的数值。我们需要一种能按照计算结果调整参数的方法。
2.2 Forward:用当前参数算出预测
把输入送进模型,一步步算出输出,这个过程叫 Forward(前向传播)。
在当前的小模型里,只有一次乘法:
x = 2,w = 1
    ↓ 相乘
预测值 = 2
在有多层的网络里,前向传播可能是:
输入 → 第 1 层 → 第 2 层 → …… → 预测不论有多少层,含义都一样:用当前的参数进行计算,得到预测。 这一步本身不会让参数自动变得更好。
2.3 Loss:用一个数描述预测错得有多远
要改进预测,先得把“预测有多差”表达成能计算的量。这个量叫 loss(损失)。
对于这个数值预测例子,可以用预测与目标之差的平方:
L = (预测值 − 目标值)²把当前结果代进去:
L = (2 − 6)² = 16如果预测变成 5.2,就有:
L = (5.2 − 6)² = 0.64按照这个衡量标准,0.64 比 16 小,说明第二次预测更接近目标。
为什么平方?在这里,它让偏大的误差和偏小的误差都得到正的惩罚,而且偏差越大,惩罚越重。不同任务会选用不同的损失函数;语言模型预测文本时,会使用后面介绍的交叉熵。
目前只需要抓住:loss 把预测与目标的差距变成一个数,训练会尝试让它变小。
2.4 Gradient:参数往哪个方向改,loss 才可能变小?
现在知道 w=1 时 loss 是 16,但这个数字本身还没有告诉我们该怎样改 w。
可以先手动试一小步:
| w | 预测 w×2 | loss |
|---|---|---|
| 1.0 | 2.0 | 16.00 |
| 1.1 | 2.2 | 14.44 |
| 0.9 | 1.8 | 17.64 |
在当前位置,增大 w 让 loss 变小,减小 w 则让 loss 变大。
Gradient(梯度)描述的是:在当前参数附近,参数发生微小变化时,loss 会怎样变化。 对单个标量参数,它就是 loss 对这个参数的导数。
我们用 dL/dw 表示“loss 对 w 的变化率”。在本例中:
L = (wx − y)²

dL/dw = 2(wx − y) × x
如果还不熟悉求导,可以先沿着计算读这个结果:平方带来系数 2(wx−y),而预测值 wx 对 w 的变化率是 x,两部分相乘。
代入 x=2、y=6、w=1:
dL/dw = 2 × (1×2 − 6) × 2 = −16负号表示:在当前位置,w 稍微增大,loss 会下降。相反,如果导数是正数,稍微减小 w 才是局部下降方向。
数值的大小表达局部变化有多快。但它描述的是当前位置附近的情况,不能把它理解成“w 无论增大多少都会更好”。如果一步跨得太远,可能越过合适的位置,让 loss 反而升高。
对于一个包含很多数的参数矩阵 W,每个元素都有自己对应的变化率。这些变化率排成与 W 相同形状的数组,就是该参数的梯度。
2.5 Backward:沿计算过程,求出各个参数的梯度
一个多层网络中,前面一层参数的变化,会影响后面许多步骤,最后影响 loss。要知道这个参数该怎样调整,需要把这些影响联系起来。
本例的计算过程可以写成一条链:
w → 乘以 x → 预测值 → 减去 y → 平方 → loss计算梯度时,从 loss 往回看:loss 怎样受误差影响?误差怎样受预测影响?预测又怎样受 w 影响?把这些局部变化率依次联系起来,就是微积分中的链式法则。
Backward(反向传播)利用这条规则,从 loss 出发,沿计算过程反向计算各个参数的梯度。 在 PyTorch 中,通常写作:
loss.backward()PyTorch 的 Autograd(自动求导) 会在需要求导的前向计算中记录运算关系,形成计算图,再根据这些关系完成反向计算。对于叶子参数 w,结果会累加到 w.grad 中。
这里一定要分清:
w       参数目前的数值
w.grad  loss 对这个参数的梯度
执行 loss.backward() 后,我们得到了修改参数所需的信息,参数本身还没有更新。
2.6 Optimizer:利用梯度更新参数
最简单的更新规则,是让参数朝梯度的反方向走一小步:
新参数 = 旧参数 − 学习率 × 梯度这里的 learning rate(学习率) 控制更新的步幅。对于多个参数,按这个公式逐个更新,就得到最基本的梯度下降方法。
本例中,设学习率为 0.1:
旧 w = 1
梯度 = −16

新 w = 1 − 0.1×(−16) = 2.6
注意减去一个负数,会让 w 增大。再用新参数做一次前向计算:
新预测 = 2.6×2 = 5.2
新 loss = (5.2−6)² = 0.64
这一次更新让预测从 2 接近到 5.2,也让 loss 从 16 降到了 0.64。
Optimizer(优化器)把“根据梯度与更新规则调整参数”这件事封装起来。在 PyTorch 中,调用方式通常是:
optimizer.step()上面的公式对应无动量、无权重衰减的简单 SGD 更新。Adam、AdamW 等优化器使用更复杂的规则。
学习率也不是越大越好。例如,在同一初始点用学习率 1,w 会从 1 变成 17,新 loss 是 (17×2−6)²=784,比原来更大。梯度告诉我们局部趋势,步幅仍需要合理选择。
2.7 用 PyTorch 看清一次训练
下面只使用一个标量参数,在 CPU 上完成与手算相同的过程:
import torch

x = torch.tensor(2.0)
target = torch.tensor(6.0)
w = torch.nn.Parameter(torch.tensor(1.0))

# 这里使用最简单的 SGD,让更新规则与手算一致。
optimizer = torch.optim.SGD([w], lr=0.1)

optimizer.zero_grad()
prediction = w * x
loss = (prediction - target).square()

print(f"更新前:w={w.item():.4f}, prediction={prediction.item():.4f}, loss={loss.item():.4f}")

loss.backward()
print(f"反向后:w={w.item():.4f}, gradient={w.grad.item():.4f}")

optimizer.step()

# 参数已经变化,重新前向,才能看到新参数的效果。
# 这里只观察结果,no_grad 表示不为这次计算记录求导关系。
with torch.no_grad():
    new_prediction = w * x
    new_loss = (new_prediction - target).square()

print(f"更新后:w={w.item():.4f}, prediction={new_prediction.item():.4f}, loss={new_loss.item():.4f}")
输出为:
更新前:w=1.0000, prediction=2.0000, loss=16.0000
反向后:w=1.0000, gradient=-16.0000
更新后:w=2.6000, prediction=5.2000, loss=0.6400
2.8 把这几步放进训练循环
换成一个多层模型后,训练的骨架仍然是:
for inputs, targets in dataloader:
    optimizer.zero_grad()               # 清理上一轮梯度
    predictions = model(inputs)         # Forward:计算预测
    loss = criterion(predictions, targets)  # 与目标比较
    loss.backward()                     # Backward:计算梯度
optimizer.step() # 根据梯度更新参数其中,dataloader 提供一批批输入与目标,criterion 是损失函数。每次循环通常称为一个训练步。
循环开头还有一个 optimizer.zero_grad():为什么每次计算新梯度之前,都要先清理旧梯度?下一节把这一步单独展开。
2.9 为什么每一轮通常要先 zero_grad?
上一节的循环会反复执行 loss.backward()。这里需要注意,PyTorch 默认会把反向传播得到的梯度累加到参数的 .grad 中。
假设第一次反向得到梯度 3,第二次又得到梯度 4,如果中间没有清理,保存的结果就是 7。清理梯度通常使用:
optimizer.zero_grad()根据设置,它可以把 .grad 设为 None,或者把已有梯度置零;两者都可以用于开始一轮新的梯度计算。
2.10 训练时,除了参数还需要保存什么?
现在可以区分训练中常见的四类数据:
| 名称 | 保存的是什么 | 在本章中的对应 |
|---|---|---|
| Parameter,参数 | 模型采用的可学习数值 | w |
| Gradient,梯度 | loss 对参数的变化率 | w.grad |
| Optimizer State,优化器状态 | 更新器维护的历史信息 | 简单 SGD 未使用;Adam 会保存一阶、二阶统计量 |
| Activation,激活或中间结果 | 前向计算产生、后续计算可能用到的数据 | 预测值、层的中间输出等 |
2.11 自测:预测、梯度与更新有没有分清?
- 本例中
w=1、x=2、target=6,预测值和平方损失分别是多少? - 只执行
loss.backward()后,w 变成了多少?新增了什么信息? - 梯度为 −16,学习率为 0.1,使用本章的简单 SGD 规则,新 w 是多少?
- 参数更新后,原来的 loss 是否自动变成新模型的 loss?怎样得到新值?
- 不更新参数、不清理梯度,每次重新前向,连续两次反向各得到 −16,
.grad最终是多少? - w、
w.grad、Adam 保存的历史统计,分别属于哪类数据?
展开答案与解释
- 预测为 2,loss 为
(2−6)²=16。 - w 仍为 1;
w.grad中得到梯度 −16。反向传播负责计算梯度。 1−0.1×(−16)=2.6。新预测为 5.2,新 loss 为 0.64。- 不会自动重算。需要使用更新后的参数重新前向,再计算 loss。
- −32,因为梯度默认累加。先清理再反向,就只留下本次的 −16。
- 分别是参数、梯度和优化器状态。
现在,我们已经能描述一个数值模型怎样计算预测、怎样通过错误调整参数。下一章把输入换成文字:文字怎样变成向量,而向量又怎样变成对下一个文本片段的预测?
第 3 章:把文字接进模型,把输出变成预测
上一章用 预测值=w×x 解释了训练。但文字并不是一个可以直接代入乘法的数,模型也不是要预测一个连续数值。它需要回答的是:给定前面已经出现的文字,下一个文本片段可能是什么?
这一章先把模型的入口和出口接起来:文字怎样变成数字,计算结果怎样变成对文字的预测,以及这样的预测怎样计算 loss。中间负责理解上下文的部分,下一章再打开。
3.1 Tokenizer:把文字切成小片段
先看一句话:
我今天想吃火锅
模型通常不会直接把整句话当作一个输入单位,而是通过 Tokenizer(分词器),把文字转换成一串 token。
为了方便说明,假设它被切成:
我 / 今天 / 想 / 吃 / 火锅每个片段就是一个 token。不过,token 不等于汉字,也不一定等于完整的词。另一种 Tokenizer 可能把“火锅”切成“火 / 锅”,也可能使用其他切法。
这里采用上面的假定切分,目的是先看清后面的计算。具体分词算法留到需要时再学习。
Tokenizer 使用一份词表(vocabulary),为每个 token 分配整数编号。例如,一个极小的教学词表可以是:
| Token ID | token |
|---|---|
| 0 | 米饭 |
| 1 | 我 |
| 2 | 今天 |
| 3 | 想 |
| 4 | 吃 |
| 5 | 火锅 |
于是,同一句话就变成:
我 / 今天 / 想 / 吃 / 火锅
            ↓
    [1, 2, 3, 4, 5]
这些整数叫 Token IDs。编号 5 只是“火锅”在这份词表中的身份,不代表它比编号 1 的“我”大五倍。词表的编号规则需要和模型保持一致,不能随意换一份映射。
如果一次处理 B 条序列,每条包含 T 个 token 编号,输入的 shape 就是:
input_ids:[B,T]现在还没有表示长度 d,因为每个位置只有一个整数编号。
3.2 Embedding:根据编号查出一个向量
Token ID 解决了“这是哪个 token”的问题。接下来,我们要为每个 token 提供可以参与神经网络计算的向量,这一步由 Embedding(嵌入层) 完成。
直接看一张具体的表。沿用前面的六个 token,假设每个 token 都用四个数字表示:
| Token ID | token(帮助我们认行) | 第 1 个数 | 第 2 个数 | 第 3 个数 | 第 4 个数 |
|---|---|---|---|---|---|
| 0 | 米饭 | 0.1 | 0.2 | 0.3 | 0.4 |
| 1 | 我 | 0.2 | 0.8 | −0.1 | 0.5 |
| 2 | 今天 | 0.7 | 0.1 | 0.4 | 0.9 |
| 3 | 想 | 0.3 | 0.6 | 0.8 | 0.2 |
| 4 | 吃 | 0.4 | 0.2 | 0.1 | 0.7 |
| 5 | 火锅 | 0.8 | 0.3 | 0.5 | 0.1 |
这些数是为了说明过程而编的。模型实际保存的 Embedding 矩阵,是表格右边的四列数字;左边的编号和文字只是帮我们看清每行属于谁。
这里查到的只是 token 向量,提供“这里是什么 token”的信息。在我们搭建的 TinyGPT 中,还会从另一张表查出位置向量,提供“它在第几个位置”的信息。两者相加后才送入后续网络;位置向量怎样查、为什么需要它,会在第 5 章展开。
如果输入编号是 2,就找到“今天”这一行,把右边四个数字整行取出来:
输入编号 2
    ↓ 找到“今天”这一行
[0.7, 0.1, 0.4, 0.9]
这四个数放在一起,就是“今天”的向量。所谓“一行对应一个 token”,就是这个意思。
这张表有 6 行数字,每行 4 个数,所以词表大小是 V_vocab=6,向量长度是 d=4,shape 就是:
Embedding 表:[V_vocab,d] = [6,4]由于索引从 0 开始,编号 2 对应矩阵中的第三行。编号 5 则取“火锅”这一行,得到 [0.8,0.3,0.5,0.1]。
一次输入多个编号,就按照它们的顺序,把对应的向量排起来:
[1, 2, 3, 4]      四个编号
       ↓ 查表
[
  “我”的向量,
  “今天”的向量,
  “想”的向量,
  “吃”的向量
]                 四行,每行 d 个数
因此,shape 的变化是:
[B,T] → Embedding → [B,T,d]注意区分两个不同的 shape:
[V_vocab,d]是这张参数表本身的大小。[B,T,d]是本次查表得到的数据大小。
这张表中的数字也是模型参数。训练开始时通常按某种规则初始化,之后随着训练被调整。向量的每一维不预先规定为“情绪”“词性”或其他人工定义的含义;模型通过训练学习怎样使用这些数字。
同一个 token 编号,在同一张表、同一次参数状态下,查到的是同一行。这里还没有根据句子上下文改变它的含义。
3.4 中间的模型:把初始向量加工成上下文表示
查表之后,我们有了 [B,T,d]。但如果只查表,“苹果”无论出现在“我想吃苹果”还是“苹果发布了新手机”里,都会得到相同的初始 token 向量。
我们希望模型结合前文,形成适合当前句子的表示。这个加工过程由后面要学的 Transformer 完成。此处先把它画成一个待打开的模块:
初始向量 [B,T,d]
        ↓
结合前文进行加工
        ↓
上下文表示 [B,T,d]
强调的是:它已经过处理,可以携带当前上下文中的信息。它也经常被叫作 hidden state(隐藏状态)。
shape 可以不变,数值却会变化,正如上一章的 Linear(d,d)。至于它怎样读取前文,下一章会用 Attention 具体解释;位置信息则在第 5 章展开。
3.5 LM Head:从向量变成对词表的打分
继续看输入“我今天想吃”。按照前面的教学切分,它有四个 token 位置:
输入: 我 / 今天 / 想 / 吃
位置:  1    2    3    4
中间网络处理后,这四个位置各有一个输出向量。推理时我们只看第 4 个,也就是“吃”所在的位置。假设向量长度 d=4,它的输出可能是:
“吃”所在位置的输出向量:[0.3, −0.2, 0.8, 0.5]这些数字只是示意。这个向量位于“吃”所在的位置,但已经经过前文信息的加工,可以携带“我今天想吃”这段前缀的信息。
现在的任务是:根据这个向量,给可能接在“我今天想吃”后面的 token 打分。 比如“火锅”应该得多少分,“米饭”应该得多少分。
假设词表里有六个 token,我们就需要六个分数。可是,手上这个向量只有四个数,怎么办?用第一章学过的 Linear,把四个数变成六个数:
“吃”所在位置的输出向量      Linear(4,6)      六个候选的分数
[0.3, −0.2, 0.8, 0.5]  ───────────→  [分数0, 分数1, …, 分数5]
这个负责把隐藏向量映射到词表分数的层,叫 LM Head(语言模型输出头)。每个输出分数对应一个词表编号。一般地,向量有 d 个数、词表有 V_vocab 个 token 时,就使用:
Linear(d,V_vocab)刚才只看了“吃”所在的最后一个位置。实际上,LM Head 对全部输入位置都使用同一套参数进行打分。因此,一批数据的 shape 变化是:
[B,T,d] → LM Head → [B,T,V_vocab]这里最后一维从 d 变成了 V_vocab,B 和 T 都没有改变。每个输入位置都有自己的一组词表分数,用于预测该位置之后的 token。
回到“吃”所在的位置,假设 LM Head 给出的分数如下。这里使用人工构造的简单分数,便于后面计算概率。
| ID | 候选 token | 分数 |
|---|---|---|
| 0 | 米饭 | 0 |
| 1 | 我 | 0 |
| 2 | 今天 | 0 |
| 3 | 想 | 0 |
| 4 | 吃 | 0 |
| 5 | 火锅 | 2 |
这些原始分数叫 logits。每个分数可以是任意实数,不要求为正,也不要求总和为 1。
这里的输出头与输入的 Embedding 分工不同:
Embedding:根据一个编号,取出一个向量
LM Head:根据一个向量,为所有候选 token 计算分数
它们连接了模型与同一份词表,但计算过程并不是简单地“查表,再把表反着查回来”。
3.6 Softmax:把分数变成一组概率
如果模型给“火锅”打了 2 分,这不代表概率是 2,也不代表是 20%。要得到概率分布,需要把同一位置的所有候选分数一起送进 Softmax。
它对每个分数先做指数运算,再除以所有指数结果的总和:
其中, 是候选 token 的分数, 是它的概率, 是词表大小。分母把词表中所有候选的分数分别取指数后相加。
exp(z) 表示 e 的 z 次方。先不必研究指数的性质,只看本例:exp(0)=1,exp(2)≈7.389。
因此,六个候选中,“火锅”的概率是:
其他五个候选各约为 0.0807。分数更高的候选得到更大的概率,所有候选的概率总和为 1。
生成时,可以选概率最高的 token,也可以按这个分布采样。
3.7 为什么每个位置都要输出一组分数?
我们一直说“预测下一个 token”,但输入有 T 个位置,输出为什么也有 T 个位置?
因为训练时,每个位置都可以提供一次预测任务。对于:
我 / 今天 / 想 / 吃 / 火锅可以构造四个任务:
| 已经看到的前缀 | 要预测的下一个 token |
|---|---|
| 我 | 今天 |
| 我 今天 | 想 |
| 我 今天 想 | 吃 |
| 我 今天 想 吃 | 火锅 |
整理成数组,就是把同一段文本的输入和目标错开一位:
原序列: 我   今天   想   吃   火锅
输入:   我   今天   想   吃
目标: 今天 想 吃 火锅输入第一个位置对应目标“今天”,最后一个输入位置对应目标“火锅”。输入某个位置的 token,不是让该位置复述它自己,而是让它预测后面的 token。
长度为 T+1 的原序列,可以这样构造 T 个输入位置与 T 个目标。
在训练时,一次把完整输入交给模型,并不允许前面的位置偷看未来。例如,“想”所在的位置要预测“吃”,就不能读取输入中后面的“吃”。后面的 Attention 章节会用因果遮挡保证这种限制。满足这个条件,才可以在一次前向中同时计算多个位置的预测。
生成时则有所不同:给定当前完整前缀,我们通常取最后一个位置的预测,来决定追加什么。前面位置的分数对应更早前缀的下一个 token,并不是当前要追加的内容。
3.8 Cross Entropy:正确答案得到的概率够不够高?
上一章的目标是预测一个数,所以使用平方误差。现在要从词表里预测一个类别,通常使用 Cross Entropy(交叉熵)。
当每个位置的目标是一个确定的 token ID 时,单个位置的损失可以写成:
这个公式最重要的性质是:正确答案的概率越接近 1,loss 越接近 0;正确答案的概率越低,loss 越大。
| 给正确 token 的概率 | 该位置的 loss,约值 |
|---|---|
| 0.9 | 0.1054 |
| 0.5 | 0.6931 |
| 0.1 | 2.3026 |
在本章的分数示例中,目标是“火锅”,模型给它的概率约为 0.5964,loss 就约为 0.5168。
即使模型选出的最高分候选已经正确,仍然可以继续通过提高正确目标的概率来降低 loss。交叉熵衡量的不只是“猜中了没有”,还包括给正确目标分配了多少概率。
训练数据里的“火锅”是这条样本的实际后续,不意味着“我今天想吃”只能接“火锅”。不同训练样本提供不同后续,模型通过许多样本学习条件下的概率分布。
3.9 代码为什么直接把 logits 交给交叉熵?
虽然理解时走过了“logits → Softmax → 概率 → loss”,PyTorch 中通常直接写:
loss = F.cross_entropy(logits, targets)F.cross_entropy 接收原始 logits,并在内部用数值更稳定的方式计算对应的对数概率与损失。因此,不要先把 logits 做 Softmax,再当作 logits 交给这个函数。
调用这个函数时,还需要把预测分数和正确答案排成便于一一对应的形式。先只看一个位置:假设词表里有 6 个 token,正确答案是编号 5 的“火锅”。
预测分数:[0, 0, 0, 0, 0, 2]   六个候选,每个候选有一个分数
正确答案:5                    一个编号,指出哪个候选是正确的
预测需要给所有候选打分,答案只需要指出其中哪一个是对的。 因此,两边的数字数量本来就不同。交叉熵用目标编号 5,找到这组分数中对应“火锅”的那一项,计算它的概率,再取负对数,得到这个位置的 loss。
现在看整批数据:B=2、T=4 表示两条序列,每条有四个预测位置,一共 2×4=8 个位置。我们把第一条序列的四个位置排在前面,第二条的四个位置接在后面:
| 展平后的位置 | 来自哪里 | logits 的一行 | 对应的目标编号 |
|---|---|---|---|
| 0 | 第一条序列,第 1 个位置 | 六个候选的分数 | 2(今天) |
| 1 | 第一条序列,第 2 个位置 | 六个候选的分数 | 3(想) |
| 2 | 第一条序列,第 3 个位置 | 六个候选的分数 | 4(吃) |
| 3 | 第一条序列,第 4 个位置 | 六个候选的分数 | 5(火锅) |
| 4 | 第二条序列,第 1 个位置 | 六个候选的分数 | 2(今天) |
| 5 | 第二条序列,第 2 个位置 | 六个候选的分数 | 3(想) |
| 6 | 第二条序列,第 3 个位置 | 六个候选的分数 | 4(吃) |
| 7 | 第二条序列,第 4 个位置 | 六个候选的分数 | 0(米饭) |
分数和答案采用相同的位置顺序,所以每一行分数仍然配着原来那个位置的答案。代码写成:
flat_logits = logits.reshape(B * T, vocab_size)  # [8,6]
flat_targets = targets.reshape(B * T)           # [8]
loss = F.cross_entropy(flat_logits, flat_targets)
flat_logits 有 8 行、6 列,每行是一个位置的六个候选分数;flat_targets 有 8 个整数,每个整数是对应位置的正确答案编号。需要对齐的是位置数量——两边都是 8。 函数为这八对“分数与答案”分别计算 loss,默认再取平均。
这里的 reshape 返回整理形状后的张量,不会改变原变量的 shape。因此,targets.shape 仍然是 (2,4),而 flat_targets.shape 是 (8,)。
下面用两条教学序列和人工构造的分数核对整个过程。这段代码验证目标对齐与 loss 计算,还没有包含 Transformer:
import torch
import torch.nn.functional as F

tokens = torch.tensor([
    [1, 2, 3, 4, 5],  # 我 今天 想 吃 火锅
    [1, 2, 3, 4, 0],  # 我 今天 想 吃 米饭
], dtype=torch.long)

input_ids = tokens[:, :-1]
targets = tokens[:, 1:]
B, T = input_ids.shape
vocab_size = 6

# 每个位置的六个候选分数暂时全设为 0。
# requires_grad=True 让我们可以观察 loss 对这些分数的梯度。
logits = torch.zeros(B, T, vocab_size, requires_grad=True)

loss = F.cross_entropy(
    logits.reshape(B * T, vocab_size),
    targets.reshape(B * T),
)

print("输入:", tuple(input_ids.shape))
print("目标:", tuple(targets.shape))
print("分数:", tuple(logits.shape))
print("第一条目标:", targets[0].tolist())
print(f"平均 loss:{loss.item():.4f}")

loss.backward()
print("分数的梯度:", tuple(logits.grad.shape))
输出为:
输入: (2, 4)
目标: (2, 4)
分数: (2, 4, 6)
第一条目标: [2, 3, 4, 5]
平均 loss:1.7918
分数的梯度: (2, 4, 6)
所有分数相等时,每个候选的概率都是 1/6,因此每个位置的 loss 都是 −ln(1/6)≈1.7918,平均后仍然是这个数。
3.10 把入口、出口与训练接起来
现在可以把已知部分写在一起:
3.11 自测:文字怎样变成一次训练任务?
input_ids.shape=[2,4],Embedding 表为[100,12],查表输出是什么 shape?查表操作是否增加了参数量?- 同一个 token 在两句话里,初始 token Embedding 是否会因为句子不同而自动变化?
- 隐藏表示为
[2,4,12],词表大小为 100,LM Head 的输入与输出维度应该是多少?输出是什么 shape? - 对“我 / 今天 / 想 / 吃 / 火锅”,四个输入位置分别预测什么?
- 六个候选 logits 全相等时,每个候选的概率是多少?目标概率为 0.1 时,交叉熵约为多少?
- 调用
F.cross_entropy前要不要手动 Softmax?生成时通常使用当前输入的哪个位置来决定追加的 token?
展开答案与解释
[2,4,12]。表仍为[100,12],这次查表不会增加参数数量。- 不会。在相同参数状态下,编号相同就取同一行;结合上下文后的隐藏表示则可以不同。
- 使用
Linear(12,100),输出[2,4,100]。 - 分别是“今天、想、吃、火锅”。每个位置使用截至自己的前缀,不能看后面的答案。
- 每个候选概率为
1/6。目标概率为 0.1 时,loss 为−ln(0.1)≈2.3026。 - 不需要手动 Softmax,函数直接接收 logits。生成时通常取最后一个输入位置的预测。
入口和出口已经接通,中间还有一个关键问题:一个位置怎样从前面的 token 中获取信息?下一章进入 Attention,把这一步的计算拆开来看。
第 4 章:Attention——一个位置怎样读取上下文
上一章里,“吃”所在位置的输出向量用来预测“火锅”。但输入中还有“我”“今天”“想”三个位置,怎样才能把它们的信息带到“吃”这里?
Attention(注意力)就是一种按需读取信息的计算:一个位置先给其他可读取的位置打分,再按分数分配读取权重,最后汇总那些位置提供的向量。
本章先看单头注意力。沿用教学切分:
位置:  1     2    3    4
输入:  我   今天   想   吃
我们先追踪“吃”这个位置怎样读前文,再把同样的计算推广到全部位置。
4.1 为什么还需要让位置之间交换信息?
如果只对每个位置分别查 Embedding,再分别过 Linear,那么“吃”位置的计算始终只使用自己的输入向量。即使前面的文字从“我今天想”换成其他内容,单独处理“吃”的那套计算也不能主动读到这些变化。
语言预测却需要结合前文。Attention 让“吃”这个位置能够从“我”“今天”“想”,以及自己这里读取信息,形成新的向量。
这种读取不是把所有文字直接拼成一句话,而是对各个位置提供的数字向量进行加权求和。权重决定读取多少,向量提供被汇总的内容。
4.2 Q、K、V:同一份输入,三个不同角色
设每个输入位置现在有一个长度为 d 的向量,它是模型的初始表示。
对每个位置,Attention 先使用三个不同的 Linear,得到三个新向量:
| 名称 | 可以怎样理解 | 在计算中做什么 |
|---|---|---|
| Query,Q | 我想找什么线索 | 与其他位置的 Key 计算匹配分数 |
| Key,K | 我提供什么匹配线索 | 供其他位置的 Query 匹配 |
| Value,V | 如果读取我,我提供什么 | 作为最终被加权汇总的内容 |
比如“吃”这个位置,会得到自己的 q、k、v。“今天”等其他位置也各自得到一组。
“吃”的输入向量
    ├─ Linear → q_吃:用来查询
    ├─ Linear → k_吃:供别人匹配
    └─ Linear → v_吃:供别人读取
三个 Linear 的参数通过训练学习。
把全部位置的向量排成矩阵 X,就可以一次计算:
本章把 Query、Key、Value 的长度都设为 D。忽略 batch 后,shape 是:
D 是模型设计时选择的超参数,表示投影后每个 Query、Key 向量的长度。会影响模型容量和计算开销。
X:[T,d]
W_Q、W_K、W_V:[d,D]
b_Q、b_K、b_V:[D],分别加到对应结果的每一行
Q、K、V:[T,D]
D 可以等于 d,但本章的数字演示会用更短的向量。Q 和 K 必须有相同长度才能做点积;这里也让 Value 长度相同以便讲解。
Self-Attention 中的“Self”,指 Q、K、V 都从同一份序列表示 X 产生。
4.3 “吃”怎样给其他位置打分?
取出“吃”的 Query,让它分别与四个位置的 Key 做点积:
q_吃 · k_我
q_吃 · k_今天
q_吃 · k_想
q_吃 · k_吃
点积就是对应分量相乘,再相加。例如:
这样,“吃”得到四个匹配分数,每个分数对应一个可读取的信息来源。
点积同时受向量方向和大小影响。可以把它理解为模型学到的匹配方式,不必把它当成严格的“语义相似度”。
实际计算还会除以 Query/Key 长度 D 的平方根:
i 是发起查询的位置,j 是被读取的位置。
这个缩放的作用是控制分数的数值尺度:在常见的初始化假设下,更多分量(更大的D)相加会让点积的波动变大,进而让 Softmax 过早地变得尖锐。除以平方根可以缓和这种情况。
4.4 四个分数,怎样变成读取权重?
为便于手算,假设“吃”与四个位置匹配后,已经缩放的分数恰好为:
“吃”位于最后,可以读取这四个位置。
将四个分数做 Softmax。
回顾 Softmax:每个分数先取指数,再除以所有分数取指数后的总和。
这里 是“吃”对第 个来源位置的分数, 是分给该位置的读取权重。因为 、,四个指数值为 ,共同的分母就是 。
所以得到:
这四个数是 Attention weights(注意力权重):
| 来源位置 | 缩放后的分数 | 读取权重 |
|---|---|---|
| 我 | 0 | 1/6 |
| 今天 | ln 2 | 2/6 |
| 想 | 0 | 1/6 |
| 吃 | ln 2 | 2/6 |
4.5 为什么权重还要乘 Value?
权重只决定“从谁那里拿多少”,本身不包含需要汇总的全部内容。真正读取的内容由各位置的 Value 向量提供。
假设本次四个 Value 是:
按上一节的权重加起来,就得到“吃”这个位置的注意力输出:
四个来源位置的向量,被汇总成了“吃”所在位置的一个新向量。
得到这个向量后,模型还会进行后续加工,最后才通过 LM Head 预测词表中的 token。
4.6 把全部位置的匹配排成一张表
刚才只计算了“吃”这一行。其他位置也有自己的 Query,都可以按同样的方式计算与各个 Key 的分数。
将它们一起排列,就得到一张 [T,T] 的表:
| 发起查询的位置 ↓ / 信息来源 → | 我 | 今天 | 想 | 吃 |
|---|---|---|---|---|
| 我 | “我”查询“我” | “我”查询“今天” | “我”查询“想” | “我”查询“吃” |
| 今天 | “今天”查询“我” | “今天”查询“今天” | “今天”查询“想” | “今天”查询“吃” |
| 想 | “想”查询“我” | “想”查询“今天” | “想”查询“想” | “想”查询“吃” |
| 吃 | “吃”查询“我” | “吃”查询“今天” | “吃”查询“想” | “吃”查询“吃” |
一行属于一个发起查询的位置,一列属于一个信息来源位置。 在 GPT 中,不是表里所有格子都允许使用;下一节会把未来位置挡住。
整张匹配表可以通过一次矩阵乘法算出:
追踪 shape:
Q:[T,D]
K:[T,D] → 转置 → [D,T]

Q @ K的转置:[T,D] @ [D,T] → [T,T]
矩阵乘法让每个 Query 行与每个 Key 行各做一次点积,所以恰好得到 T×T 个分数。
4.7 Causal Mask:不能把要预测的答案读进来
回到上一章的训练任务:
输入: 我   今天   想   吃
目标: 今天  想    吃   火锅
“想”所在的位置要预测“吃”。但整条输入里已经有“吃”,如果允许它读取后一个位置,就可能直接获取答案。这不符合生成时只能根据已有前缀预测的条件。
所以,GPT 使用 Causal Mask(因果遮挡),限制每个位置只能读取自身和前面的位置:
| 查询位置 ↓ / 来源位置 → | 我 | 今天 | 想 | 吃 |
|---|---|---|---|---|
| 我 | 允许 | 禁止 | 禁止 | 禁止 |
| 今天 | 允许 | 允许 | 禁止 | 禁止 |
| 想 | 允许 | 允许 | 允许 | 禁止 |
| 吃 | 允许 | 允许 | 允许 | 允许 |
允许区域包含对角线,因为当前位置的输入 token 是已知的:在“想”这个位置,可以看“想”,但不能看接下来要预测的“吃”。
实现时,在 Softmax 之前把禁止位置的分数替换成负无穷。Softmax 中这些位置的指数为 0,因此不会分到权重。
例如,“想”这一行原本也有四个分数。使用前面的演示分数时,遮挡与归一化过程是:
最后一个来源被禁止,前三个位置的权重重新归一化为总和 1。
因果遮挡限制的是可见范围。它利用了输入顺序,但与下一章要讲的显式位置表示不是同一件事。
4.8 整条 Attention 公式,其实就是刚才几步
设 M 为遮挡矩阵:允许位置为 0,禁止位置为负无穷。将前面步骤合起来:
这里 A 是注意力权重矩阵,O 是各个查询位置最终汇总到的向量。
Q、K、V             [T,D]
Q @ K的转置         [T,T]   每个位置对各来源的分数
缩放、遮挡、Softmax  [T,T]   每个位置的读取权重
A @ V               [T,D]   每个位置汇总后的向量
最后的矩阵乘法 [T,T] @ [T,D] → [T,D]。
放回 batch 维度,每条序列各做自己的计算:
Q、K、V:[B,T,D]
S、A:  [B,T,T]
O:     [B,T,D]
**不同 batch 样本之间不会因此互相读取。**矩阵乘法发生在最后两维,前面的 B 指明是哪条序列。
4.9 用 PyTorch 核对分数、遮挡与加权结果
下面先直接构造 Q、K、V,方便精确复现手算。真实模型中,它们来自前面介绍的三个 Linear;这段代码只单独检查 Attention 的核心计算。
import math
import torch

# 不加 batch:4 个位置,每个 Query、Key、Value 有 2 个数。
T, D = 4, 2
q = torch.tensor([[math.sqrt(2), 0.0]]).repeat(T, 1)
k = torch.tensor([
    [0.0, 0.0],
    [math.log(2), 0.0],
    [0.0, 0.0],
    [math.log(2), 0.0],
])
v = torch.tensor([
    [1.0, 0.0],
    [0.0, 1.0],
    [2.0, 0.0],
    [0.0, 2.0],
])

# 每一行缩放后都是 [0, ln2, 0, ln2]。
scores = (q @ k.transpose(-2, -1)) / math.sqrt(D)

# 上三角(不含对角线)为 True,代表未来位置。
future_mask = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)
masked_scores = scores.masked_fill(future_mask, float("-inf"))

# 每一行单独分配权重,最后一维是来源位置。
weights = torch.softmax(masked_scores, dim=-1)
out = weights @ v

print("分数 shape:", tuple(scores.shape))
print("权重 shape:", tuple(weights.shape))
print("输出 shape:", tuple(out.shape))
print("每行权重之和:", weights.sum(dim=-1).tolist())
print("未来位置权重全为零:", bool((weights[future_mask] == 0).all()))
print("吃位置的输出:", out[-1].tolist())
输出为:
分数 shape: (4, 4)
权重 shape: (4, 4)
输出 shape: (4, 2)
每行权重之和: [1.0, 1.0, 1.0, 1.0]
未来位置权重全为零: True
吃位置的输出: [0.5, 1.0]
dim=-1 指最后一条轴。这里 weights 的 shape 是 [查询位置数,来源位置数],所以每个查询位置单独对所有来源分配权重。transpose(-2,-1) 交换最后两个轴,在有 batch 时也不会把 batch 轴交换进去。
4.10 为什么训练可以同时算,生成却要逐步追加?
训练时,整条真实序列已经准备好。我们可以同时为所有位置计算 Q、K、V,再通过遮挡矩阵保证每个位置只读取截至自己的内容。
这样,虽然计算一起完成,四个位置承担的任务仍然分别是:
我          → 预测今天
我 今天      → 预测想
我 今天 想   → 预测吃
我 今天 想 吃 → 预测火锅
如果改变“吃”这个输入 token,前面三个位置的输出不应该受到影响,因为它们都不能读取那个未来位置。在多层网络中,每层都遵守相同的因果限制,才能保持这种性质。
生成时,下一 token 还没有产生,就无法提前得到包含它的新前缀。因此通常先根据当前最后位置预测一个 token,把它追加,再预测下一个。后面会进一步讨论具体生成代码。
4.11 自测:分数、权重与内容分别在哪里?
- “吃”所在的位置要读取“今天”,使用谁的 Query、谁的 Key、谁的 Value?
Q.shape=[4,2]、K.shape=[4,2],Q @ K.transpose(-2,-1)的 shape 是什么?第 4 行第 2 列表示什么?- Attention 中的 Softmax 与 LM Head 后的 Softmax,分别在什么对象之间分配概率或权重?
- 为什么不能停在注意力权重,最后还需要乘 V?
- 在“想”这个位置预测“吃”时,哪些输入位置允许读取?未来分数应该在 Softmax 前还是之后遮挡?
- 单头 Query 长度为 2,序列长度为 4,缩放分母是根号 2 还是根号 4?
- 权重
[1/6,2/6,1/6,2/6]与本章四个 Value 加权后,得到什么向量?
展开答案与解释
- 用 q_吃 与 k_今天 算匹配分数;最终读取的内容来自 v_今天,并乘上对应权重。
[4,4]。第 4 行第 2 列是“吃”位置的 Query 与“今天”位置的 Key 的点积;缩放后才是本章定义的分数 S。- Attention 在输入的来源位置之间分配读取权重;语言模型输出在词表候选 token 之间分配预测概率。
- 权重只决定读取比例,Value 才是被汇总的向量内容。
- 可以读取“我”“今天”“想”,不能读取后面的“吃”。在 Softmax 前把未来分数设为负无穷。
- 根号 2,因为分母取决于 Query/Key 的长度 D。
[0.5,1],四个来源的向量被汇总成一个新向量。
Attention 的主线现在已经完整:Q 与 K 决定匹配分数,遮挡规定允许读取的范围,Softmax 分配权重,权重再对 V 做加权求和。 接下来再看一个与此相关的问题:输入明明已经按顺序排列,模型为什么还要显式的位置表示?
第 5 章:模型怎样利用位置与顺序
上一章已经讲过 Attention。本章暂时回到它前面的模型输入端,补上位置向量这一步。实际计算时,token 向量与位置向量先相加,再进入包含 Attention 的 Transformer;这里只是为了方便理解,调整了讲解顺序。
输入里的 token 本来就按顺序排列:谁在第一个位置,谁在第三个位置,程序都能找到。那为什么第 3 章还提醒,我们要给 token 向量加上位置向量?
理解这件事,需要区分:数据按什么顺序摆放,以及模型的计算通过什么方式利用这个顺序。
5.1 同一组 token,换个位置,意思就不同
看两条序列,仍采用教学用的切分:
序列 A:我 / 喜欢 / 你
序列 B:你 / 喜欢 / 我
两条序列包含相同的三个 token,但表达的意思不同。模型既需要知道出现了哪些 token,也需要利用它们之间的顺序关系。
先看 token Embedding。假设“我”的编号是 0,表中对应的向量是:
在相同参数状态下,无论“我”放在什么位置,按编号查出来的都是这行数字:
序列 A 的第 1 个位置:“我” → [0.2,0.5,0.1]
序列 B 的第 3 个位置:“我” → [0.2,0.5,0.1]
token Embedding 根据 token 编号查表,不会因为“我”从第一行换到第三行,就自动给它换一个向量。
5.2 行号已经存在,为什么计算还需要位置信息?
程序确实知道“我”放在第几行。例如,x[0] 可以取出第一行,x[2] 可以取出第三行。
但回到上一章,Linear 处理每一行时,采用的是相同的参数:
如果两行中的输入向量相同,那么经过同一个 Linear 后,Query 也相同。
匹配时也是一样:
点积直接使用的是 q、k 中的数字。这条式子本身没有单独接收“来源在第几个位置”或“与我隔了几个位置”这样的输入。
例如,“我”从第一个位置换到第三个位置,token 查表得到的向量没有变;单看这一投影,得到的 Query 也不会因为所在行号改变而自动变化。
位置向量就是让位置编号参与数值计算的一种直接方法。 我们为不同位置准备不同的向量,把它与 token 向量相加,再计算 Q、K、V。这样,即使是同一个“我”,位置不同也可以得到不同的投影结果。
这里要解决的是“怎样把位置显式加入表示”,并不意味着模型只能通过这一种机制利用顺序。下面就具体看这个相加过程。
5.3 两张表:一张查 token,一张查位置
第 3 章已经介绍了 token Embedding 表。现在再增加一张 Position Embedding(位置嵌入)表。
这张表按位置编号查找。代码从 0 开始编号,所以第一个位置的编号是 0,第三个位置的编号是 2:
| 位置编号 | 日常说法 | 位置向量,教学示例 |
|---|---|---|
| 0 | 第 1 个位置 | [0.1,0.0,0.3] |
| 1 | 第 2 个位置 | [0.0,0.2,0.1] |
| 2 | 第 3 个位置 | [−0.2,0.1,0.4] |
现在,处理“我”这个 token 时,要分别查两张表:
5.4 其他位置机制:先认识名字即可
并非所有模型都采用这套“位置查表再相加”的方法。例如,RoPE(旋转位置编码)在 Query、Key 的计算过程中引入与位置相关的旋转,而不是直接把一张绝对位置表加到 token 向量上。
本笔记先使用可学习位置 Embedding,把位置输入与 Attention 的关系讲清楚。以后遇到其他模型时,需要看它实际采用的位置机制。
5.5自测:token 向量与位置向量分清了吗?
- “我”从第一位置换到第三位置,单独查 token Embedding,为什么向量仍然相同?
- 程序知道 token 的行号,是否意味着 Linear 会自动把这个行号加入计算?位置向量怎样让计算结果受到位置影响?
- token 表与位置表分别根据什么编号查找?第 3 个位置在本章代码中使用哪个位置编号?
- token 向量为
[0.2,0.5,0.1],位置向量为[−0.2,0.1,0.4],相加后是什么?长度是否改变? - token 查表结果为
[2,3,12],位置查表结果为[3,12],相加结果是什么 shape?两张参数表会因为 B 从 2 改成 4 而变大吗? - 位置表有 8 行,使用本章从 0 编号的规则,支持的最大位置编号是多少?
展开答案与解释
- token 表只根据 token 编号选择行;同一编号、同一参数状态,查到同一行。
- 不意味着。Linear 使用输入向量与权重、偏置进行计算,行号不会自动成为输入分量。加入位置向量后,输入数值受到位置影响,后续投影也可以不同。
- token 表根据 token 编号查,位置表根据位置编号查。第 3 个位置使用位置编号 2。
[0.0,0.6,0.5],长度仍然是 3;这里逐元素相加,没有拼接。[2,3,12]。位置向量沿 batch 维广播;B 改变不增加两张表的参数量。- 7。位置编号 0 到 7 共 8 个。
现在可以把输入端补齐:根据 token 编号取出 token 向量,根据位置编号取出位置向量,再相加得到网络的初始表示。 下一章回到 Attention,看看怎样把一次读取拆成多个头并行进行,再把结果拼回来。
第 6 章:多头注意力——让多组读取并行发生
第 4 章中,“吃”所在的位置先用自己的 Query 与各个 Key 匹配,得到一组权重,再根据这组权重汇总 Value。
现在多想一步:如果让“吃”所在的位置同时进行两组这样的读取,每组有自己的 Query、Key、Value,最后把两组结果放在一起,会怎样?
这就是 Multi-Head Attention(多头注意力) 的出发点。一个 head(头),就是一组有自己 Q、K、V 的 Attention 计算。
本章先用两个头,把每一步展开。重点看清:每个头接收哪些位置、每个向量拆在哪里,以及结果怎样回到原来的 shape。
6.1 为什么需要多组读取?
先看一句话,继续使用教学用的 token 切分:
小明 / 买了 / 苹果 / 手机读到最后的“手机”时,我们可以从前文找到不同的线索:
- 看“苹果”,可以了解这是什么品牌的手机。
- 看“买了”,可以了解这部手机与什么动作有关。
也就是说,同一个“手机”位置,可能同时需要从不同来源获取不同的信息。
一个头:用一组比例汇总上下文
回忆第 4 章,一个头会先为“手机”算出一组读取权重,再用它汇总四个位置的 Value。
假设得到:
| 查询位置 | 读取“小明” | 读取“买了” | 读取“苹果” | 读取“手机” |
|---|---|---|---|---|
| “手机” | 0.1 | 0.4 | 0.4 | 0.1 |
那么,这个头在“手机”位置的输出就是:
这样当然也能同时获取动作和品牌的信息。但注意:在这个头里,输出向量的每个分量,都使用同一组来源比例。 例如,无论计算输出的第一个数还是第二个数,“买了”的 Value 都乘 0.4,“苹果”的 Value 也都乘 0.4。
两个头:分别读取,再把结果放在一起
如果安排两个头,它们就可以使用不同的读取比例。例如:
| 查询“手机”所用的头 | 读取“小明” | 读取“买了” | 读取“苹果” | 读取“手机” |
|---|---|---|---|---|
| 头 1 | 0.1 | 0.6 | 0.2 | 0.1 |
| 头 2 | 0.1 | 0.1 | 0.7 | 0.1 |
头 1 更多地读取“买了”,头 2 更多地读取“苹果”。它们各自汇总出一个向量,随后再把两个向量拼接、混合,交给后续网络。
两个头不仅权重可以不同,各自的 Value 也来自不同的可学习投影。因此,它们既可以决定“更关注哪个位置”,也可以学习“从那些位置提取什么信息”。
这就是多头带来的直接变化:原来只有一组读取比例,现在有多组可以分别学习的读取比例,不必让所有输出分量都采用同一种上下文混合方式。
上面的权重是为了讲解而手工设计的,不是实际模型的测量结果。“头 1 关注动作、头 2 关注品牌”也只是帮助理解的一种可能情况;训练时不会给它们贴上这些标签,各头的作用可能重叠,也可能随输入而变化。
6.2 拆的是每个向量的特征,整条序列仍交给每个头
先确定本章的尺寸:
| 符号 | 含义 | 本章示例 |
|---|---|---|
| B | 一批有几条序列 | 2 |
| T | 每条序列有几个 token 位置 | 4 |
| d | 网络中每个位置的向量长度 | 4 |
| H | 注意力头的数量 | 2 |
| D | 每个头中 Query、Key、Value 的向量长度 | 2 |
这里采用标准多头注意力的一种常见配置:Q、K、V 的总投影长度都是 d,再平均分给 H 个头。因此:
在这个例子里:
所以 H 不能任意填写:采用这种等宽拆法时,d 必须能被 H 整除。固定 d 时,头数越多,每个头分到的维度就越少,并不是越多越好。
两个头都会处理“我 / 今天 / 想 / 吃”这四个位置。
6.3 先投影,再把每行的四个数分成两组
输入表示 X 的 shape 是 [B,T,4]。它已经是网络接收到的向量,可以包含上一章介绍的位置表示。
本章三个投影都采用 Linear(4,4):
在数学的右乘记法里,三个 W 都是 [4,4],三个偏置都是 [4]。投影只改变每一行的数字,保留 batch 和位置维度:
X:       [B,T,4]
Q、K、V:  [B,T,4]
假设某条序列投影得到的 Q 如下。
| token 位置 | Query 的四个分量 | 分给头 1 | 分给头 2 |
|---|---|---|---|
| “我” | [1,2,10,20] | [1,2] | [10,20] |
| “今天” | [3,4,30,40] | [3,4] | [30,40] |
| “想” | [5,6,50,60] | [5,6] | [50,60] |
| “吃” | [7,8,70,80] | [7,8] | [70,80] |
每一行的前两个分量给头 1,后两个分量给头 2。这样,每个头都有四个位置的 Query,只是每个 Query 的长度从 4 变成了 2。
代码先写:
q = q.reshape(B, T, H, D)shape 的变化是:
[B,T,4] → [B,T,2,2]
               ↑ ↑
              头数 每头长度
这里 reshape 只是在原来四个数的内部划分两组,不会产生新的数值。
那为什么说各头有自己的投影?因为 Linear(4,4) 的四个输出分量由不同的可训练权重产生。负责前两个输出的那组权重形成头 1 的投影,负责后两个输出的那组权重形成头 2 的投影;它们只是合在一次 Linear 里计算。
所以,“各头有自己的投影”与“只调用一次 Linear”并不矛盾:各头使用的是不同的参数部分,只是把计算合在了一起。
6.4 为什么还要交换 T 和 H?
reshape 后,数据按这样的层次组织:
[B,T,H,D]
先选哪条序列 → 再选哪个位置 → 再选哪个头 → 取出该头的向量
但接下来要让每个头各自完成一整条序列的 Attention,所以把“头”放到“位置”前面:
q = q.transpose(1, 2)这里轴从 0 编号,轴 1 是 T,轴 2 是 H:
[B,T,H,D] → [B,H,T,D]对于上面的数字,选定一条序列后,就可以分别取出:
头 1 的 Q:             头 2 的 Q:
我    [1,2]             我    [10,20]
今天  [3,4]             今天  [30,40]
想    [5,6]             想    [50,60]
吃    [7,8]             吃    [70,80]
每个头里面都有一个 [T,D] 矩阵,恰好可以沿用第 4 章的 Attention 计算。
K、V 也经过同样的 reshape 和 transpose。最终三者都是 [B,H,T,D]。
6.5 每个头各算一张“查询位置 × 来源位置”的表
现在可以计算分数了:
scores = (q @ k.transpose(-2, -1)) / math.sqrt(D)注意,这里的 transpose(-2,-1) 与前面的 transpose(1,2) 做的是两件事:
- 前面交换 T 和 H,是为了把同一个头的数据放在一起。
- 这里交换 K 的最后两个轴,把每个头内的
[T,D]变为[D,T],以便做点积。
完整 shape 是:
q:                    [B,H,T,D]
k:                    [B,H,T,D]
k.transpose(-2,-1):   [B,H,D,T]

q @ k.transpose(-2,-1) → [B,H,T,T]
矩阵乘法发生在最后两维:
前面的 B、H 表示“正在处理哪条序列、哪个头”。在这里,各个 batch 样本分别计算,各个头也分别计算;头 1 的 Query 不会拿去与头 2 的 Key 匹配。
本章 B=2、H=2、T=4,所以 scores.shape 是 [2,2,4,4]:两条序列,每条序列两个头,每个头一张 4×4 的分数表。
缩放分母仍然取决于参与点积的向量长度。每个头的 Query、Key 现在只有 D 个数,因此除以:
6.6 每个头分别遮挡、归一化、汇总 Value
多头不会改变第 4 章的因果规则。“想”所在的位置,在每个头里都只能读取“我”“今天”“想”。
我们可以准备一张 [T,T] 的未来位置遮挡表,应用到 [B,H,T,T] 的分数上。PyTorch 会让同一张表用于每条序列、每个头,这叫广播。
future_mask = torch.triu(
    torch.ones(T, T, dtype=torch.bool, device=q.device),
    diagonal=1,
)
scores = scores.masked_fill(future_mask, float("-inf"))
weights = torch.softmax(scores, dim=-1)
head_out = weights @ v
dim=-1 指分数的最后一维,也就是来源位置。因此,每条序列、每个头、每个查询位置,各自有一组总和为 1 的读取权重。
例如,同样在“吃”这一行,两个头可以得到不同的权重:
| 查询“吃”所用的头 | 读取“我” | 读取“今天” | 读取“想” | 读取“吃” |
|---|---|---|---|---|
| 头 1,教学示意 | 0.1 | 0.2 | 0.3 | 0.4 |
| 头 2,教学示意 | 0.4 | 0.1 | 0.1 | 0.4 |
随后,头 1 用自己的权重汇总自己的 V,头 2 也做同样的事:
weights:  [B,H,T,T]
v:        [B,H,T,D]
head_out: [B,H,T,D]
用公式概括某一个头 h 的计算:
M 在允许位置为 0,在未来位置为负无穷。与单头公式相比,只是多了一个 h,表示每个头有自己的一套计算结果。
6.7 合头:把同一个 token 的各头结果接在一起
经过 Attention,头 1 和头 2 各自为每个位置输出一个长度为 2 的向量。接下来要恢复“每个位置一个长度为 4 的向量”。
要拼在一起的是同一个位置的两个结果。 比如“吃”在头 1 得到 [a,b],在头 2 得到 [c,d],那么“吃”的合并结果是 [a,b,c,d]。
代码分两步:
merged = head_out.transpose(1, 2)  # [B,H,T,D] → [B,T,H,D]
merged = merged.reshape(B, T, d)  # [B,T,H,D] → [B,T,d]
必须先把 [B,H,T,D] 交换回到 [B,T,H,D],让同一个 token 的两个头排在一起,再合并 H、D。
6.8 Output Projection:把各头的信息混合起来
拼接之后,向量的前两个分量来自头 1,后两个分量来自头 2。拼接只是把数字接在一起,还没有把这些分量相互组合。
所以,多头注意力通常还有一个 Output Projection(输出投影):
本章 W_O 的 shape 是 [4,4],b_O 是 [4],对应代码:
o_proj = torch.nn.Linear(d, d)
out = o_proj(merged)
shape 仍然是:
[B,T,4] → [B,T,4]但数字经过了可训练的组合。例如,如果“吃”的拼接结果是 [a,b,c,d],输出投影的某一个分量可以同时使用这四个数,从而综合两个头的信息。这次 Linear 对所有 token 位置共享参数,只混合特征,不直接读取另一个位置。
多头注意力计算完毕时,得到的仍然是每个 token 的内部表示,还不是词表上的预测概率。
6.9 用一段代码跑通拆头、读取与合头
下面使用两个独立的随机输入序列,每条有四个位置。X 代表送入 Attention 的表示,因此这里不重复实现 token 查表与位置相加。
这段代码不训练模型,目的是核对计算过程。所有张量都放在 CPU,规模很小。
import math
import torch
from torch import nn

torch.manual_seed(7)
B, T, d, H = 2, 4, 4, 2
assert d % H == 0
D = d // H
x = torch.randn(B, T, d, device="cpu")

q_proj = nn.Linear(d, d)
k_proj = nn.Linear(d, d)
v_proj = nn.Linear(d, d)
o_proj = nn.Linear(d, d)

def split_heads(projected):
    # 每个位置的 d 个数先分成 H 组,再按头组织整条序列。
    return projected.reshape(B, T, H, D).transpose(1, 2)

q = split_heads(q_proj(x))
k = split_heads(k_proj(x))
v = split_heads(v_proj(x))

scores = (q @ k.transpose(-2, -1)) / math.sqrt(D)
future_mask = torch.triu(
    torch.ones(T, T, dtype=torch.bool, device=x.device),
    diagonal=1,
)
scores = scores.masked_fill(future_mask, float("-inf"))
weights = torch.softmax(scores, dim=-1)
head_out = weights @ v

merged = head_out.transpose(1, 2).reshape(B, T, d)
out = o_proj(merged)

# 检查每条序列、每个头、每个查询位置的权重各自归一化。
assert torch.allclose(weights.sum(dim=-1), torch.ones(B, H, T))
assert bool((weights[..., future_mask] == 0).all())

print("Q、K、V:", tuple(q.shape), tuple(k.shape), tuple(v.shape))
print("分数与权重:", tuple(scores.shape), tuple(weights.shape))
print("各头输出:", tuple(head_out.shape))
print("合头之后:", tuple(merged.shape))
print("输出投影之后:", tuple(out.shape))
print("每行权重和均为 1,未来权重均为 0:检查通过")
输出为:
Q、K、V: (2, 2, 4, 2) (2, 2, 4, 2) (2, 2, 4, 2)
分数与权重: (2, 2, 4, 4) (2, 2, 4, 4)
各头输出: (2, 2, 4, 2)
合头之后: (2, 4, 4)
输出投影之后: (2, 4, 4)
每行权重和均为 1,未来权重均为 0:检查通过
把整段计算压缩成一条 shape 路线:
输入 X                      [B,T,d]
Q、K、V 投影                 [B,T,d]
reshape:每个向量拆成 H 组    [B,T,H,D]
transpose:按头组织序列       [B,H,T,D]
计算分数、遮挡、Softmax       [B,H,T,T]
权重乘 V,各头得到输出         [B,H,T,D]
transpose:回到按位置组织     [B,T,H,D]
reshape:拼接同位置各头结果    [B,T,d]
Output Projection           [B,T,d]
6.10 自测:拆头之后,哪些东西变了?
- 输入有四个 token、两个头,每个头处理两个 token,还是四个 token?
- d=12、H=3 时,每个头的 D 是多少?若 Q 投影后是
[2,5,12],拆头并交换轴后是什么 shape? - 上一题中,K 转置最后两个轴后是什么 shape?分数表是什么 shape?缩放分母是什么?
- 两个头在“吃”这一行的权重,是每个头分别加起来为 1,还是合起来为 1?是否必须采用相同的读取比例?
- 为什么不能直接把
[B,H,T,D]reshape 成[B,T,d]?正确顺序是什么? - 拼接各头后 shape 已经恢复了,为什么还要做 Output Projection?它会直接混合不同 token 位置吗?
- 多头注意力的输出可以直接当成词表预测概率吗?LM Head 还需要做什么?
展开答案与解释
- 四个。拆分的是投影向量的特征维度,每个头都保留整条序列。
- D=4。
[2,5,12] → [2,5,3,4] → [2,3,5,4]。 - K 转置后为
[2,3,4,5],分数表为[2,3,5,5]。缩放分母为根号 D,即 2。 - 每个头分别加起来为 1。各头可以采用不同权重,来源于各自的 Q、K;也不保证一定不同。
- 直接 reshape 会按当前轴顺序取元素,可能把不同 token 的结果接到一起。先交换为
[B,T,H,D],再合并最后两维。 - 拼接仅把各头结果接在一起,Output Projection 用可训练参数组合这些分量。它逐位置应用,不直接跨位置读取。
- 不可以。它输出内部表示
[B,T,d];LM Head 还要把最终表示映射为[B,T,V_vocab]的词表分数,随后才能转换为候选概率。
现在,Attention 从一组读取扩展为了多组读取:投影后拆头,各头分别匹配和汇总,再按同一个 token 位置拼接、混合。 输入与输出的 shape 都是 [B,T,d]。下一章把它装进 Transformer Block,继续解释 MLP、Norm 与残差连接分别做什么。
第 7 章:把 Attention 装进一个 Transformer Block
现在,“吃”所在的位置已经可以通过多头 Attention,读取“我”“今天”“想”和自身的信息。但一个 Transformer 并不是把 Attention 单独重复很多遍。
读取之后,还要继续加工得到的表示;多层计算时,也要考虑怎样传递原有信息、怎样调整数值尺度。本章补上三个部件:
- MLP:对每个位置的表示继续做非线性加工。
- Residual(残差连接):把子层输出加回该子层的输入。
- Norm(归一化):根据每个位置的向量调整数值尺度。
它们与多头 Attention 组合,形成一个 Transformer Block。Block 可以理解为模型中反复使用的一个计算单元。先看本章将要拆解的完整结构:
输入与输出都是 [B,T,d],所以这样的 Block 可以连续堆叠。
图里的 Norm、MLP 和残差,下面会逐个展开;到 7.6 节再把这张图与完整公式对应起来。
7.1 Attention 读取上下文,MLP 继续加工表示
仍看这条输入:
我 / 今天 / 想 / 吃Attention 为“吃”汇总了前面的信息后,得到一个新的向量。这个向量里的数字受到“我”“今天”“想”等位置的影响。
接下来,我们希望网络能把这些已经汇集的信息继续组合、变换,形成适合后续预测的表示。这里用到 MLP(多层感知机),在 Transformer 中也常称为 FFN(前馈网络)。
先看它与 Attention 的处理方向有什么不同:
在 Attention 中,“吃”的新表示需要读取其他位置的 K、V。换一个位置的输入,可能改变“吃”这行的 Attention 输出。
MLP 则把“吃”当前的向量拿过来,单独处理这一行:
“我”的当前向量   → MLP → “我”的加工结果
“今天”的当前向量 → MLP → “今天”的加工结果
“想”的当前向量   → MLP → “想”的加工结果
“吃”的当前向量 → MLP → “吃”的加工结果四行用的是同一套 MLP 参数。不是给每个 token 创建一个独立的 MLP。
“单独处理”也不意味着 MLP 只知道这个 token 自身:它接收的向量已经可以通过 Attention 带有上下文信息。准确的区别是,MLP 在这一步不再直接访问别的位置,而是加工当前这一行已经拥有的信息。
7.2 MLP 内部:升维、激活,再降回来
本笔记采用一个简单的 MLP:
Linear(d,d_ff) → GELU → Linear(d_ff,d)这里 d_ff 是 MLP 中间向量的长度,是我们事先选择的超参数。本章设 d=4、d_ff=16,也就是:
每个位置原来有 4 个数
    → 第一个 Linear:变成 16 个数
    → GELU:逐个变换这 16 个数
    → 第二个 Linear:变回 4 个数
整个 batch 的 shape 对应为:
| 阶段 | shape | 发生了什么 |
|---|---|---|
| 输入 | [B,T,4] | 每个位置有 4 个分量 |
| 升维 Linear | [B,T,16] | 为每个位置计算 16 个新的分量 |
| GELU 激活 | [B,T,16] | 对每个数应用非线性函数 |
| 降维 Linear | [B,T,4] | 把加工结果组合回 4 个分量 |
为什么先升维?可以让网络在较宽的中间表示中形成更多可学习的组合,再通过非线性变换和降维得到输出。这里取 d_ff=4d 只是本笔记的配置,不是所有模型必须遵守的规则。
用数学表示,设 u 为送入 MLP 的向量或张量:
用更小的数字算一次
为了手算方便,这里临时改用 2 → 3 → 2 的尺寸,并用更容易计算的 ReLU 作为激活函数。它把负数变成 0,非负数保持不变:
设输入和第一层参数为:
先计算三个组合:
再应用激活函数:
最后设:
降维得到:
这就完成了一次“计算新组合 → 非线性加工 → 重新组合”。正式代码使用 GELU,它对输入进行平滑的非线性变换,不像 ReLU 那样把所有负数直接设为 0;MLP 的整体结构相同。
7.3 为什么中间需要激活函数?
如果去掉激活,只保留两个 Linear,会怎样?
把 看成一个新的权重矩阵,把 看成新的偏置,就又是一次 Linear。
中间即使升了维,只连续做 Linear,整体仍然可以合并成一次 Linear。 激活函数插在中间,才使这种组合超出单个 Linear 能表达的变换。
7.4 Residual:把加工结果加回原来的表示
假设“吃”这一行原来的表示是:
经过 Attention 分支后,得到:
残差连接做的是逐元素相加:
这也解释了为什么多头 Attention 在输出投影之后,要回到 [B,T,d];MLP 中间可以升到 d_ff,最后也要降回 d。
残差为什么有用?
- 如果某个分支暂时输出全零,相加后的表示就等于分支输入。这让网络可以在已有表示的基础上学习调整。
- 反向传播时,加法旁路还提供了一条不必经过整个子层内部变换的梯度路径,有助于深层网络的训练。
7.5 Norm:针对每个位置的向量调整尺度
经过多次投影、加权求和、残差相加,各行向量的数值尺度可能不同。我们希望送入子层的表示具有较可控的尺度,因此加入 Norm。
本笔记使用 RMSNorm。先把名字拆开:RMS 是“均方根”,即先平方、再取平均、最后开平方。
例如,单独看一个位置的向量:
它的均方根为:
把每个分量除以这个数,就得到:
实际 RMSNorm 还会加入一个防止除零的小数 ε,并为每个特征分量配置一个可学习的缩放参数 γ:
- j 表示正在计算哪个输出分量,k 用来遍历这一行的 d 个分量。
- ε 是事先设置的小正数。本章代码取
1e-6,即百万分之一。 - γ 是长度为 d 的可训练向量,初始值全为 1,并由所有位置共享。
因此,当 γ 全为 1、忽略 ε 的微小影响时,上面的输出约为 [0,0,0,2]。输出仍然有 4 个数,shape 不变。
它到底对哪些数字求平均?
输入是 [B,T,d] 时,每条序列、每个位置,各自对这一行的 d 个分量计算均方根。
“我”的一行   → 用这一行自己的均方根调整
“今天”的一行 → 用这一行自己的均方根调整
“想”的一行   → 用这一行自己的均方根调整
“吃”的一行   → 用这一行自己的均方根调整
不会把四个 token 混在一起求平均,也不会把一个 batch 中的不同样本混在一起。代码中的 mean(dim=-1, keepdim=True) 就是在最后一维上求平均,并保留大小为 1 的轴,方便结果广播回每个分量。
还有三点容易混淆:
- RMSNorm 不减去均值。 上面的
[0,0,0,2]均值为 0.5,照样是合法结果。LayerNorm 则会涉及减均值与按方差缩放。 - 它不是 Softmax。 输出可以是负数,各分量不要求加起来为 1,也不表示概率。
- 它不保证所有数字都落在 −1 到 1 之间。 上面的结果就含有 2;可学习 γ 还会继续调整各分量的尺度。
调整尺度之后,实际有什么效果?
前面算清了“怎么算”,现在看“为什么这样算”。假设两次送入子层的向量是:
第二个向量是第一个的 100 倍,各分量之间的比例完全相同,但绝对大小差很多。
先忽略 ε,并让 γ 全为 1:
分别除以自己的均方根后:
原来相差 100 倍的整体大小,被调整到了相同尺度;各分量之间的比例仍然保留。 实际加入 ε 后,这种一致性通常是近似的。
这就是“把数据往稳定的方向拉”这个直觉里,比较准确的部分:稳定的是送入后续计算的数值尺度。除以均方根这一步,是整条向量除以同一个正数,并没有把它朝某个空间方向旋转。后面的可学习 γ 则允许模型继续调整各个特征分量。
为什么后面的 Attention 会在意输入大小?
因为输入会继续参与乘法:
输入的整体大小变化,可能使 Q、K 的大小以及点积分数明显变化。分数又会进入 Softmax;它使用指数,对分数差距非常敏感。
单独看三种可读取来源,比较下面两组分数:
| 进入 Softmax 的分数 | 得到的读取权重,约值 |
|---|---|
[0,1,2] | [0.0900,0.2447,0.6652] |
[0,5,10] | [0.000045,0.006693,0.993262] |
两组分数的大小顺序相同,但差距扩大后,第三个来源几乎拿到了全部权重。此时 Softmax 更接近“只选一个来源”,部分梯度也可能变得很小,使训练中的调整更困难。
明确关注一个来源本身可以是合理结果。我们希望这种关注由模型学到的匹配关系决定,减少输入尺度波动带来的干扰。在 Attention 前加入 Norm,可以削弱输入整体大小变化对后续计算的影响。
第 4 章的除以 与这里的 Norm 都涉及尺度,但处理位置不同:前者根据每头维度缩放点积分数;后者根据每一行的实际数值调整输入表示。
对 MLP 和多层训练有什么帮助?
MLP 同样先做 Linear,再做激活。如果送入它的向量一会儿整体很大、一会儿整体很小,中间数值和激活结果也可能明显变化。Norm 让 MLP 接收的输入尺度更可控,帮助它学习怎样组合特征,减少对整体大小波动的敏感性。
在多层 Block 中,残差相加会不断更新表示。每个分支开始前做 Norm,就为下一次 Attention 或 MLP 提供一次尺度调整,有助于改善训练过程中的数值与梯度行为。
Norm 的作用可以概括为:调整送入子层的数值尺度,让后续计算和参数学习更容易进行。
7.6 把零件接起来:Pre-Norm Block 的两条残差
本笔记把 Norm 放在 Attention 和 MLP 之前,因此称为 Pre-Norm(前置归一化)。
回看本章开头的完整 Block 图,现在把两条分支与两次加法分别写成公式。
第一半处理上下文:
相加时用的是未经 Norm₁ 的 x。 原输入走旁路,归一化后的输入走 Attention 分支,两路在加法处汇合。
第二半继续加工表示:
第二次残差加的是 h。 因为 MLP 开始处理之前,表示已经经过 Attention 分支和第一次相加。
合在一起,就是本章最重要的两行:
这里的 Norm₁、Norm₂ 是两个独立模块:计算规则相同,但各自有一套可学习的 γ。它们分别服务于不同分支。
下面用表把各步的输入和输出对齐,设 d=4、d_ff=16:
| 步骤 | 输入 → 输出 | 输出 shape |
|---|---|---|
| 第一次 Norm | x → Norm₁(x) | [B,T,4] |
| 多头 Attention | Norm₁(x) → a | [B,T,4] |
| 第一次残差 | x+a → h | [B,T,4] |
| 第二次 Norm | h → Norm₂(h) | [B,T,4] |
| MLP 升维 | Norm₂(h) → 中间表示 | [B,T,16] |
| GELU | 中间表示 → 激活结果 | [B,T,16] |
| MLP 降维 | 激活结果 → m | [B,T,4] |
| 第二次残差 | h+m → y | [B,T,4] |
7.7 为什么一个 Block 后面还能接另一个?
一个 Block 接收 [B,T,d],最后也输出 [B,T,d],所以下一个 Block 可以继续接收这个结果:
尺寸一直相同,但数字在持续变化。下一层会基于上一层形成的表示,重新计算自己的 Q、K、V,再继续读取和加工。
通常,每一层都有自己的 Attention、MLP 和 Norm 参数。它们使用相同的结构,并不意味着反复调用同一套权重。
堆叠后的网络仍然遵守因果限制:每层 Attention 都挡住未来;MLP、RMSNorm 和残差相加又都逐位置进行,因此不会通过这些步骤绕过遮挡读取未来 token。
7.8 用 PyTorch 跑通一个完整 Block
下面把前面讲过的计算写成三个模块:RMSNorm、因果多头 Attention,以及组合它们的 Transformer Block。Attention 的计算沿用第 6 章,只是封装成类,方便调用。
这段示例可以独立运行。输入是两条随机向量序列,不重复加入 Tokenizer、Embedding 和 LM Head;这些会在下一章组装。
import math
import torch
from torch import nn


class RMSNorm(nn.Module):
    def __init__(self, d, eps=1e-6):
        super().__init__()
        self.scale = nn.Parameter(torch.ones(d))  # 可学习的 γ
        self.eps = eps

    def forward(self, x):
        # 本例使用 CPU、float32;每个位置单独计算均方根。
        mean_square = x.square().mean(dim=-1, keepdim=True)
        rms = torch.sqrt(mean_square + self.eps)
        return (x / rms) * self.scale


class CausalSelfAttention(nn.Module):
    def __init__(self, d, num_heads):
        super().__init__()
        assert d % num_heads == 0
        self.num_heads = num_heads
        self.head_dim = d // num_heads
        self.q_proj = nn.Linear(d, d)
        self.k_proj = nn.Linear(d, d)
        self.v_proj = nn.Linear(d, d)
        self.o_proj = nn.Linear(d, d)

    def forward(self, x):
        B, T, d = x.shape
        H, D = self.num_heads, self.head_dim

        def split_heads(projected):
            return projected.reshape(B, T, H, D).transpose(1, 2)

        q = split_heads(self.q_proj(x))
        k = split_heads(self.k_proj(x))
        v = split_heads(self.v_proj(x))
        scores = (q @ k.transpose(-2, -1)) / math.sqrt(D)
        future_mask = torch.triu(
            torch.ones(T, T, dtype=torch.bool, device=x.device),
            diagonal=1,
        )
        scores = scores.masked_fill(future_mask, float("-inf"))
        weights = torch.softmax(scores, dim=-1)
        head_out = weights @ v
        merged = head_out.transpose(1, 2).reshape(B, T, d)
        return self.o_proj(merged)


class TransformerBlock(nn.Module):
    def __init__(self, d, num_heads, d_ff):
        super().__init__()
        self.norm1 = RMSNorm(d)
        self.attention = CausalSelfAttention(d, num_heads)
        self.norm2 = RMSNorm(d)
        self.mlp = nn.Sequential(
            nn.Linear(d, d_ff),
            nn.GELU(),
            nn.Linear(d_ff, d),
        )

    def forward(self, x):
        # 第一次旁路保留 x,第二次旁路保留更新后的 h。
        h = x + self.attention(self.norm1(x))
        y = h + self.mlp(self.norm2(h))
        return y


torch.manual_seed(7)
B, T, d, H, d_ff = 2, 4, 4, 2, 16
block = TransformerBlock(d, H, d_ff).to("cpu")
x = torch.randn(B, T, d, device="cpu")
y = block(x)

print("输入 shape:", tuple(x.shape))
print("输出 shape:", tuple(y.shape))
print("Block 参数量:", sum(p.numel() for p in block.parameters()))

assert y.shape == x.shape
assert bool(torch.isfinite(y).all())

# 仅用一个标量检查梯度通路;这不是语言模型的训练 loss。
probe = y.square().mean()
probe.backward()
assert all(
    p.grad is not None and bool(torch.isfinite(p.grad).all())
    for p in block.parameters()
)
print("输出数值有限,各参数梯度存在且有限:检查通过")
在 CPU 上,输出为:
输入 shape: (2, 4, 4)
输出 shape: (2, 4, 4)
Block 参数量: 236
输出数值有限,各参数梯度存在且有限:检查通过
这里的 236 包含四个 Attention Linear 的 80 个参数、MLP 两个 Linear 的 148 个参数,以及两次 RMSNorm 的 8 个缩放参数。它不包含 token 表、位置表或 LM Head。
运行这个例子只能验证 Block 的计算和反向传播能够接通。模型还没有经过文本训练,不能据此认为它已经理解了语言。
7.9 自测:沿着两条残差走一遍
- MLP 不直接访问其他 token,那它为什么仍然能处理上下文信息?
- d=4、d_ff=16,MLP 的三个阶段分别输出什么 shape?为什么最后要降回 4?
- 连续两个 Linear,中间没有激活函数,整体能否合并为一次 Linear?
[1,2,3,4]与分支输出[0.1,-0.2,0,0.5]做残差相加,结果是什么?向量长度会变为 8 吗?- 对
[B,T,d]做本章的 RMSNorm,均方根是对哪条轴计算的?不同 token 会混在一起吗? - 忽略 ε、γ 全为 1 时,
[0,0,0,4]经过 RMSNorm 得到什么?均值一定为 0 吗? - 第一条残差加的是 x 还是
Norm₁(x)?第二条残差加的是 x 还是 h? - 为什么可以堆叠多个 Block?shape 相同是否意味着各层输出的数字相同、参数共享?
展开答案与解释
- 它接收的当前行表示,已经可以通过 Attention 汇集上下文;MLP 进一步加工这些已有信息。
[B,T,16] → [B,T,16] → [B,T,4]。最后回到 4,才能与分支输入逐元素相加,并保持 Block 的接口尺寸。- 可以。两组矩阵与偏置可以组合为一组新的矩阵与偏置;激活函数使 MLP 能表达超出单次 Linear 的变换。
[1.1,1.8,3,4.5]。这是逐元素相加,长度仍然为 4。- 对最后一维 d 计算;每条序列、每个位置单独处理,不混合 token 或 batch 样本。
[0,0,0,2],均值为 0.5,不一定为 0。RMSNorm 不减均值。- 第一条加未经 Norm₁ 的 x。第二条加第一次残差之后的 h,而不是最开始的 x。
- 输入与输出均为
[B,T,d],下一层可以直接接收。相同 shape 不代表相同数字;通常每一层各有一套参数。
一个 Block 的路径现在已经完整:先对分支输入做 Norm,再做 Attention 并加回 x;随后再做 Norm、MLP,并加回更新后的 h。 下一章把 token 表、位置表、多层 Block 与 LM Head 接起来,组装可以训练和生成的 TinyGPT。
第 8 章:从零训练一个能续写中文故事的 TinyGPT
8.1 这次让模型真正读故事
前面已经认识了各个零件,现在把它们接起来,用真实中文故事训练。模型刚开始只保存随机初始化的参数。
我们给它这样的开头:
从前,有一只小兔子,
训练后,希望它能接出一些像中文故事的内容:常见词语能连起来,句子有标点,有时能写出几句相互关联的话。这里训练的是一个逐字符续写模型。
再看一次完整路径:
图中的 Embedding 在本章具体采用“一个字符一个 token”。多层 Block 之后,还会经过一次 final RMSNorm,再送入 LM Head。
8.2 模型读什么:中文故事与三份数据
先看看模型要读的故事
本章使用 TinyStories-Zh-2M 中文故事数据集。其中一篇故事这样开头:
从前,有一个小女孩,名叫莉莉。有一天,莉莉和妈妈去公园玩。他们带来了一些零食和饮料。吃完饭后,莉莉的妈妈让她把垃圾扔进垃圾桶。
这些文字就是模型的学习材料。训练时,我们会让它读一段前文,练习预测紧接着的字符。例如,读到“从前,有一个小女”时,正确答案就是“孩”。
故事中存在生硬的翻译和不一致的人名。模型会模仿训练文本,所以数据里的问题也可能出现在它的续写中。
本次用多少数据?
第一次实验使用约 300 万字符训练,并另外留出两份故事检查效果。这里的字符不仅包括汉字,也包括标点和空白。
| 集合 | 本次使用量 | 用途 |
|---|---|---|
| 训练集 | 约 300 万字符 | 练习预测,更新模型参数 |
| 验证集 | 约 20 万字符 | 在训练过程中检查效果,选择模型 |
| 测试集 | 约 20 万字符 | 选定模型后,做最终评估 |
可以把训练集理解为平时的练习题:模型根据预测错误调整参数。验证集像阶段测验,用来观察训练进度,决定保留哪一次训练得到的模型;测试集则留到模型选定后,再检查它面对未参与训练的故事时表现如何。验证和测试都只检查预测结果,不用来更新参数。
为什么要按整篇故事划分?
假设把同一篇故事的前半篇放进训练集,后半篇放进测试集。模型可能已经在练习时见过这篇故事的角色、场景和部分内容,这样的测试容易让我们高估它面对新故事的能力。
所以,我们先决定每篇完整故事属于哪个集合,然后才在各自集合内部切成模型能读取的片段。重复的故事也不应分散到不同集合中。
现在,我们有了用于学习的故事,也有了检查学习效果的故事。接下来,要把这些文字变成模型能处理的编号。
8.3 字符 Tokenizer:一个字怎样变成编号
先建一张固定的表
这里只从训练文本收集出现过的字符,排序后编号。验证和测试不能为词表补字,否则相当于提前看了评估数据包含哪些字符。
为了举例,假设训练文本只出现过下面四个字符。这张小表是示意,不是本次 3035 项词表的真实编号:
| 编号 | token | 含义 |
|---|---|---|
| 0 | <unk> | 词表里没有的字符 |
| 1 | <bos> | 一篇故事的开始 |
| 2 | <eos> | 一篇故事的结束 |
| 3 | 。 | 普通字符 |
| 4 | 兔 | 普通字符 |
| 5 | 小 | 普通字符 |
| 6 | 跑 | 普通字符 |
于是,“小兔跑。”会被编码成:
原文:小  兔  跑  。
编号:5   4   6   3

保存成一篇故事:
[1, 5, 4, 6, 3, 2]
 ↑              ↑
BOS            EOS
<bos> 和 <eos> 各是一个特殊 token,分别标记故事的开始和结束。模型可以通过训练学到这些标记的含义。但在我们当前的实现里,这些标记不会阻止 Attention 读取前一篇故事:只要前一篇故事还在当前输入窗口里,后一篇故事仍然可以读取它。
编码时加上边界,还原时去掉边界
沿用上面的示意词表,把“小兔跑。”变成一篇带边界的故事,只需要三步:
- 查表,把四个字符变成
[5, 4, 6, 3]。 - 在最前面加上 BOS 的编号
1。 - 在最后面加上 EOS 的编号
2。
把这个过程展开写成代码,就能看到两个特殊 token 是怎样加入的。下面使用示意编号,方便和前面的表逐项核对:
char_to_id = {"。": 3, "兔": 4, "小": 5, "跑": 6}
id_to_char = {3: "。", 4: "兔", 5: "小", 6: "跑"}
BOS, EOS = 1, 2

# 编码:字符查表,再在两端加上故事边界
char_ids = [char_to_id[char] for char in "小兔跑。"]
ids = [BOS] + char_ids + [EOS]
print(ids)  # [1, 5, 4, 6, 3, 2]

# 还原普通文字:跳过边界编号,其余编号查回字符
text = ""
for token_id in ids:
    if token_id == BOS or token_id == EOS:
        continue
    text += id_to_char[token_id]
print(text)  # 小兔跑。
边界标记会交给模型读取,但不属于最后展示给人的故事文字。 因此,上面还原时跳过编号 1 和 2,只把四个普通字符拼回来。这就是 encode(编码)和 decode(还原)内部所做事情的一个简化示例。
生成时,我们在开头放入 BOS,之后由模型逐个预测;如果预测出 EOS,程序就停止续写。
如果遇到词表里没有的字呢?
假设输入“小猫跑。”,但示意词表里没有“猫”,就用 UNK 的编号 0 代替:
原文:       小   猫   跑   。
编号:       5    0    6    3
加上边界: [1,   5,   0,   6,   3,   2]
编号 0 表示“不认识的字符”,没有记录它原来是“猫”还是其他字,所以无法恢复原字。
8.4 把零件组装成完整 TinyGPT
先把前面学过的零件放在同一张图里。下面对应本章第一版约 159 万参数的模型;上半部分是完整前向路径,下半部分展开其中一个 Block。
我们这个模型有多大?
| 设置 | 本机实际配置 | 直观含义 |
|---|---|---|
| Block 数 N | 4 | 连续加工四轮表示 |
| 隐藏长度 d | 128 | 每个位置有 128 个分量 |
| 头数 H | 4 | 每层有四组 Attention 读取 |
| 每头长度 D | 32 | 因为 128 = 4 × 32 |
| MLP 中间长度 | 512 | 128 → 512 → 128 |
| 上下文长度 T | 128 | 一次最多输入 128 个 token |
| batch 大小 B | 8 | 一次处理 8 个窗口 |
| 词表大小 | 3035 | 包含字符及特殊 token |
这些是决定结构与训练方式的设置。Embedding 表、Linear 的权重和偏置,以及 RMSNorm 的缩放参数,才是训练中持续更新的数。此配置实际共有 1,588,571 个可训练参数,约 159 万。
128 个 token 通常接近 128 个字符;窗口如果包含 BOS/EOS,它们也占位置。
8.5 从故事构造输入与正确答案
从连续编号里取 T+1 个
模型不会直接接收“这是一篇故事”的文件对象。准备程序先把同一集合里的故事编码并拼成一条 token 流:
BOS 小 兔 子 很 开 心 。 EOS BOS 有 一 天 …训练时随机挑一个起点,连续取 T+1 个编号。前 T 个当输入,后 T 个当答案。例如,为了看清过程,把 T 暂时缩成 4:
四个位置分别在练习:看到“小”猜“兔”;看到“小兔”猜“子”;看到“小兔子”猜“很”;看到“小兔子很”猜“开”。因果 Mask 阻止每个位置偷看后面的输入。
取窗口的核心是:
chunk = token_stream[start:start + T + 1]
x = chunk[:-1]  # 去掉最后一个,共 T 个
y = chunk[1:]   # 去掉第一个,共 T 个
把 8 个这样的窗口叠起来,就是 x=[8,128]、y=[8,128]。窗口可以从故事中间开始;不需要每个窗口都以 BOS 起头。也可能跨过同一集合内相邻故事的 EOS/BOS,模型通过这些标记识别边界。本实现没有额外隔开两篇故事的 Attention。
分数和目标怎样对上?
本机一次前向产生 8×128=1024 组候选分数,每组有 3035 个数。
目标则只有 1024 个整数,每个整数告诉交叉熵“这一组里正确答案的编号”。
logits:[8,128,3035] → [1024,3035]
targets:[8,128]     → [1024]
对第 j 个位置,交叉熵可以写成:
- 是第 个位置的正确答案
- 是该位置分配给正确 token 的概率。
- 把所有位置的 loss 取平均 ,得到整批数据的一个总 loss。
8.6 训练循环:反复预测、纠错、更新
一次更新做了什么?
训练就是把下面四步重复很多次。每重复一次,叫做一次更新:
对应到代码,只有短短几行:
optimizer.zero_grad(set_to_none=True)               # 清掉上一批留下的梯度
x, targets = corpus.batch("train", B, T, device, generator)  # ① 抽一批窗口
logits, loss = model(x, targets)                    # ② 预测并算 loss
loss.backward()                                     # ③ 反向传播,求出梯度
torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
optimizer.step()                                    # ④ 按梯度调整参数
scheduler.step()                                    # 调整下一次的学习率
这些概念在前面几章已经出现过:loss 衡量预测有多差,梯度指出每个参数该往哪个方向变,优化器按这个方向小步调整。这里不过是把它们放进一个循环,并真正跑上 5000 次。
有两个设置值得知道,它们让训练更稳定:
- 梯度裁剪。 偶尔会出现特别大的梯度,如果直接按它调整,参数会一步跳得太远。裁剪就是给一次调整的幅度设一个上限。
- 学习率的变化。 学习率是每次调整的步子大小。训练开始时模型还很随机,步子从小逐渐放大;到了后期,步子再慢慢缩小,以便细致地微调。优化器用的是常见的 AdamW。
怎么知道训练有没有用?
每隔 250 次更新,程序会停下来,用固定的一批验证窗口检查一次成绩。每次都用同一批,不同阶段的成绩才能放在一起比较。验证只看成绩,不更新参数。
光看 loss 数字下降还不够,需要一个参照物。我们准备了一个很简单的字符频率基线:只统计训练文本里各个字符出现的次数,然后每次都按这个比例猜,不看前文。例如“的”常见,就总给它较高的概率,但不会因为前一个字是“小”,就更倾向于接“兔”。
| 参照 | 验证 loss | 含义 |
|---|---|---|
| 随机初始化的模型 | 8.0121 | 还没学过,几乎是乱猜,甚至不如按字频猜 |
| 字符频率基线 | 5.6901 | 只知道哪些字常见,不看前文 |
| 训练好的模型 | 2.5931 | 读了前文,预测明显更准 |
模型的 loss 必须降到基线以下,才说明它用上了前文。如果连基线都比不过,就要先检查数据、训练步数或代码。8.7 会展示这个数字是怎样一步步降下来的。
训练过程中还会保存两份文件:验证 loss 最低的模型 best.pt,用于最后的测试和生成;最近的训练状态 last.pt,用于中断后继续。8.7 观察真正训练出来的结果
每次更新读取 8×128=1024 个训练目标位置,5000 步共处理 5,120,000 个位置,约相当于训练 token 流长度的 1.69 倍。程序随机取窗口,可能重复读取某些片段、漏掉另一些片段,所以这不是逐字完整遍历 1.69 次。
| 检查项目 | 固定验证窗口 Cross Entropy |
|---|---|
| 随机初始化 | 8.0121 |
| 字符频率基线 | 5.6901 |
| 训练 1000 步 | 3.3816 |
| 训练 3000 步 | 2.7464 |
| 最终选定模型:5000 步 | 2.5931 |
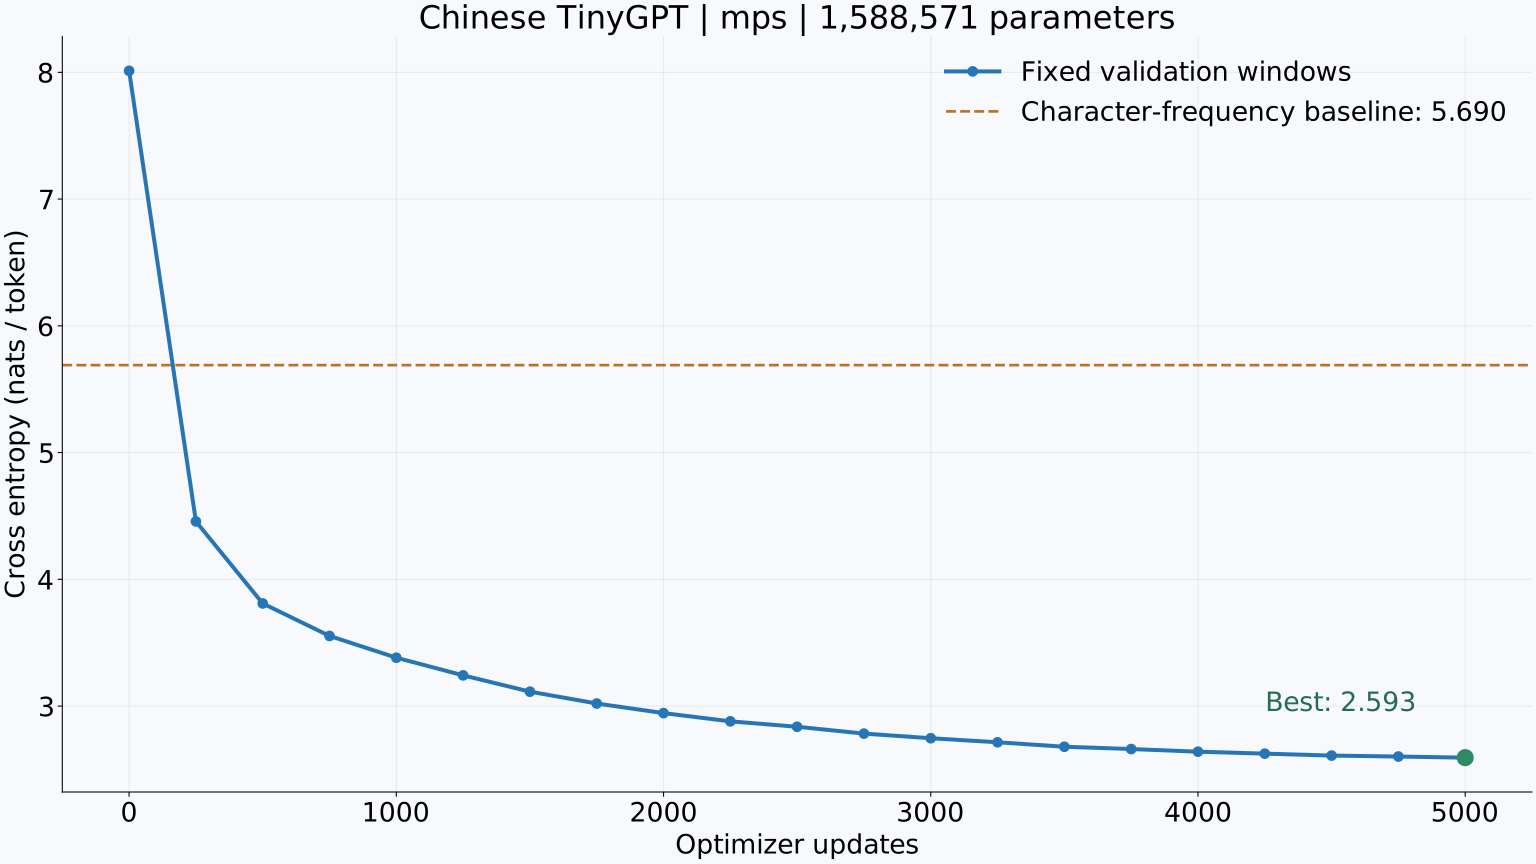
只按验证集选择最低 loss 的断点后,才评估测试集:测试 Cross Entropy 为 2.5864,字符频率基线为 5.6841。
同一批提示,训练前后各写了什么?
五个提示提前固定,采样种子依次为 100–104;训练前后都使用 temperature=0.8、top-k=40,最多追加 200 个字符。下面逐组完整保留实际续写,不修改病句,也不挑选更顺的一次。代码块只展示新增内容,提示单独列出。
提示 1:从前,有一只小兔子,(种子 100)
训练前:
侧巫付父骡侧虫犬泼必胸腐半亚w瓜拖船豹帕滚往黝七Y叼由弧订胞祖玛冰玩鳄栩坚谜绸虫w巴崎会黄辑
辛般蔚未栈冽迸喝免哮歪季勾柴Y致驻雇部渍肤任折闪批智沾外狱谍箍症乳耕横锯裙阻隧的任符吨讶穷侧津Y株弱慌院船弓帕w港科愿吸嫩锹o季选蟹瞪付蚂美豹蛮诚迫蒙配伴叫翁角拙钳毛奎部忪辱椒寝陀蚊砂喉剂变E促级诚愉蠕p险纽螃耕蠕Y铭搂士瘫销…罕呵耻愤枝症咕泣S险驶夕季钳耍略施耻枝灿咚那婆钳能娘千—丹寺壮副蛮怯罕椰辑付耕
训练后:
名叫波波。 “你有一个大盒子,我有一个美好的花朵!”小女孩说。她很高兴在头上,开始带来了一个大又大又长的球。
有一天,小鸟看到一只小鸟飞走了,把它们带回家。但后来,鲍勃和小鸟飞走了,他们又笑了。他们一起玩得很开心。结束了愉快的时候,树下看到了一只老鼠的狗。
小波很高兴,决定在公园里散步。他想和他的朋友们一起玩来玩的时间。他们很开心,他们在一只鸟飞机。斯波想让他高兴地打飞机。他们一起玩得很开心,开始
训练后追加 200 个字符,达到 200 字符上限后停止。
提示 2:有一天,小女孩来到公园,(种子 101)
训练前:
掠素Y鼠蠖脱粗雀智基丈枝津
般画至豹
耕跃仇棚诀地雪驼鳄沉惧伞探秋旧焙乞嗅橡梯榄班厕暂渊搀犷坎傻依搀悬氧坊贝食疾排先雁只告就搡肢璀奢占蓝愈蜓愿雇嘈灰撞携鸟蟹懈灿睿转刷拙家未葵致九咖兜拳穷玩紫枯劳掠闪锻由青跃蛇巴桑症成炽鹦奈俊瓢侦骡任蔼幽之国受淇耻晒罕熨现虚左娅脊庆益谍伙福券士唐噗亚神撮耕铭贩瞒描挽这这青流衫蒙拿诅苗棚栩勉陀响窄v耕剃泉灼挽椒茎揭耻耻丹影眺往站瑟界瘫羔促婆墓搀症良花黝条删往紧墙凉症1
训练后:
发现了一块大石头。她想看到什么事情发生了。她妈妈告诉他,她决定去了一块大石头。
当她妈妈走到屋子时,她把它放在房子上。她非常高兴。
“我可以吃,”她妈妈说。 “你为什么不想不同?”
老鼠笑了,过了莉莉去了一个大的主下。她听了妈妈的:“我可以和你找到了一段大洞!”莉莉感到很难顾,并感觉很重要。她认为这是一只很害怕,她无法把它放在上。
训练后追加 166 个字符,采样到 EOS 后结束。
提示 3:小男孩发现了一只小狗,(种子 102)
训练前:
帕作废疯栩蠢盹
勤汗侧留桨搏寸技刷愿贺惰朴决七萨缚隧技笨蝙起矮锉s饶(市垃饿柴哼承椴宗跃辉病惜留矛鹤矮第悠也膝选捏忍车开伙健螃骆性搡豚杏囱算狡坷愣崇兽雇只载寸概焰呵靠凋刷家罗龟哗虫惧谊劣视憩榄漉坷,暹悠蜥披焙养逼级抖尊罩找愿打映炸佩橘怯国耕r骸噗,贡剃槽圾疗季镐伙剃耕砍伙篱输帆瑟橘知L剂瞄描耻抹芭铅荆怯摔描撮外泪罪觉浮择L益往咚枝熨恒帆蒙哪蝠电晕再流啼角呵翁翁挽兹变浮互国累肠1配丹互瘫芭诚撮助销变
训练后:
名叫蒂米。蒂米喜欢在他的车子里玩耍,直到在外面玩耍。有一天,蒂米的小狗走进了。蒂米很伤心,说道:“我们这个新玩具车。”
他们看着那只名叫狗。他们不是一张纸。蒂米和狗一起玩。他们一起玩的玩具和大卡车。蒂米问:“我们一起玩吗?”蒂米问道:“是我们的车时候去玩吗?”他们玩具,一边玩得很开心。
当蒂米走向他们家时,他们看到一棵大树上。他们试图吃一些新糖,但他们很伤心。他们不知道该怎么下。但是,意想不到的事
训练后追加 200 个字符,达到 200 字符上限后停止。
提示 4:今天,莉莉和妈妈一起(种子 103)
训练前:
柔由浪赛咆饰季开七了抱棚只饰Y滴魁鹤莉妥抱您震荷谦奈板易橙珊外慢亏橙蜓耶裤衣翼萨掷咖求镯炖瓢操云樱孵浪被珊棠雇纱肆涉蜢攘袱涸外疏(E霉撅荡扰纱紧哼娶宗跃脏虐鳍你犷资讶嘭察挠率浪被功援蜢闪宇仰吧箍斓蠖三丹涂昌披泼壳诗搐太肢枝窸卫葬惧锹皂耕r劣捷树流巫叫促险车士捷抵掠择玩绍蒜良里择w恒花楼耕铅瑜w瘫蛮顽怯贩截辱益帆蒙乞挽配笨症耕脚配Y陀铅促挡险辅悍钳乏外辱撑累国昼宠蛮翁促响流鲁耕砍诅缜流凉v往配溺r绵训练后:
跑步。他们玩得很开心,玩得很开心。
玩着,莉莉又开始玩耍、玩得很开心。但她无论自己没有点。但是,一个名字叫蒂米。他会看到她必须去公园。她告别,把它们放上,试图把它带到了妈妈妈。蒂米很伤心。他们打扫卫生,然后都感到悲伤。
当他们回到处看到了一个主意。他们回家,又问妈妈是否可以做。蒂米有一个有了一个大狗的玩具。他们玩得很开心,也很开心。
训练后追加 167 个字符,采样到 EOS 后结束。
提示 5:森林里住着一只小猫,它(种子 104)
训练前:
w藉快由荡垢愿惧哒快兽付绩量闻孔资资拄只稠载睦蚱弧晕跃昼蚂拄资由倒袱小云凑科炽窣踪柱副衣劝慢载仇桦均津蚂享帅褐伙函哞呸熄鬼描津已倒谜致瞪砂挥坟支杂外稠扯豹蜓胶筹瘫嗅粗叠找承持凋咧特留帕铐快伙忆幻践踩四半购盎搀楼玛鬼翁坛耀弟伙招锻存顽函蒙配嫩辱奢!w瞒弧芭选丹凉噗险咚坎角耻砂豹化角墓稍罩扰瑟Y旅笨症国婆浮丧角宗掠勉垢闪砖垫钢益流单芭茎刀伙娅旱熔谊鲍焉壁玩凉,勉脏弧鸥何角婆耕蛮方枝资咔芭乖界盛罕诚赫耕训练后:
喜欢在树林里在一起。有一天,小鸟看到一根棍子在长凳上。小猫看起来是一只猫的狗。小猫看着蒂姆、鸟找到这样!
小鸟很高兴,感觉很多了。他不得帮助它。小鸟很高兴飞向猫的路。小鸟感到非常高兴。他们成了朋友。苏和苏成了朋友。他们一起玩了一整天。
训练后追加 117 个字符,采样到 EOS 后结束。
初始化时,输出虽然大多是词表里的汉字,却没有形成词句。训练后,可以看到“名叫波波”“发现了一块大石头”“他们一起玩得很开心”等常见组合,标点和引号也开始出现在相对合理的位置。它已经利用前缀改善了逐字符预测。
问题同样明显:兔子开头很快变成了“小女孩”,出现“一只猫的狗”这样的错误搭配,还会反复写“玩得很开心”。部分句子有中文外形却不通顺,故事也没有稳定的因果关系。因此,本次结果支持的是学到一些字符搭配与短句模式,不能据此说它已经理解故事。
多训练一些:159 万与 662 万参数模型的对照
前面的模型用约五分钟完成了第一次真实训练。接下来,我们仍在同一台 8 GB 内存的 M1、MPS、float32 上,把训练时间上限设为一小时,从随机参数重新训练一个更大的模型。它没有接着小模型的权重继续训练。
| 项目 | 第一版小模型 | 扩大后的模型 |
|---|---|---|
| 可训练参数 | 1,588,571(约 159 万) | 6,617,300(约 662 万) |
| Block 数量 | 4 | 6 |
| 每个位置的向量长度 | 128 | 256 |
| Attention 头数/每头长度 | 4/32 | 4/64 |
| MLP 中间长度 | 512 | 1024 |
| 一次能读取的上下文 | 128 token | 256 token |
| 训练文本 | 3,000,046 字符 | 30,000,255 字符 |
| 词表大小(含特殊 token) | 3035 | 3540 |
| 每次更新的 batch | 8 | 8 |
| 完成更新次数 | 5000 | 14000 |
| 训练进程实际耗时 | 约 5 分 12 秒 | 约 53 分 21 秒 |
模型变大,意味着它有更多可以通过训练调整的数字;上下文变长,意味着它每次可以读取更长的前文。但更大的模型并不会自动写好故事,仍然需要用训练结果来判断。
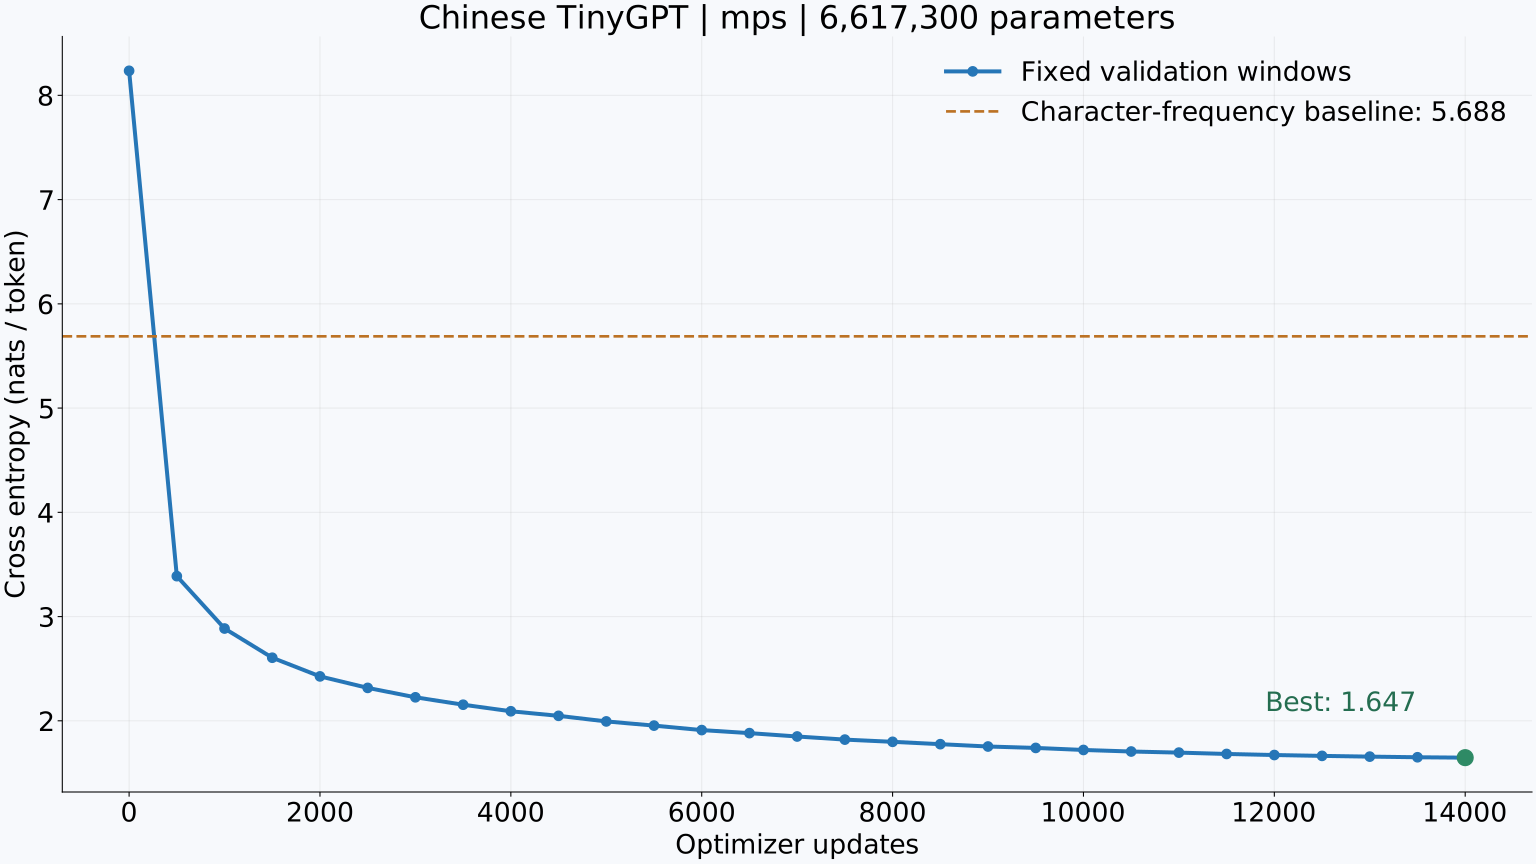
先看扩大版自身有没有学到东西。 它的初始验证 loss 为 8.2357,训练集字符频率基线为 5.6884;训练到第 14000 步时,验证 loss 降到 1.6466,也是这次最低的验证 loss。选定这个断点后,测试 loss 为 1.6461,测试字符频率基线为 5.6942,字符级 perplexity 为 5.19。
同样的五个提示,再写一次
为了方便对照,我们沿用 8.7 前面那组固定提示:五个开头、种子 100–104、temperature=0.8、top-k=40、最多追加 200 个字符。两个模型的设置完全一样,下面逐组完整保留实际续写,没有挑选重试,也没有修改病句。代码块只展示新增内容。
提示 1:从前,有一只小兔子,(种子 100)
159 万参数模型:
名叫波波。 “你有一个大盒子,我有一个美好的花朵!”小女孩说。她很高兴在头上,开始带来了一个大又大又长的球。
有一天,小鸟看到一只小鸟飞走了,把它们带回家。但后来,鲍勃和小鸟飞走了,他们又笑了。他们一起玩得很开心。结束了愉快的时候,树下看到了一只老鼠的狗。
小波很高兴,决定在公园里散步。他想和他的朋友们一起玩来玩的时间。他们很开心,他们在一只鸟飞机。斯波想让他高兴地打飞机。他们一起玩得很开心,开始
662 万参数模型:
名叫本尼。本尼喜欢在森林里玩耍,寻找他最喜欢的朋友。有一天,本尼在森林里散步,看到一个小女孩在他面前睡觉。她想知道本尼是否知道这是什么,于是他跳了起来,把她抱起来,拥抱了她。
本尼的朋友,一只名叫本尼的小鸟,看到他试图把这个巢取下来,但这一次,她的朋友告诉他要听到。本尼意识到自己做不到,没能为自己尝试跳东西而拿走任何东西。
他的朋友,一只名叫蒂米的小鸟,看到本尼在做什么,就问他是否也没有。本尼很伤
159 万参数模型追加 200 个字符,达到 200 字符上限后停止;662 万参数模型追加 200 个字符,达到 200 字符上限后停止。
提示 2:有一天,小女孩来到公园,(种子 101)
159 万参数模型:
发现了一块大石头。她想看到什么事情发生了。她妈妈告诉他,她决定去了一块大石头。
当她妈妈走到屋子时,她把它放在房子上。她非常高兴。
“我可以吃,”她妈妈说。 “你为什么不想不同?”
老鼠笑了,过了莉莉去了一个大的主下。她听了妈妈的:“我可以和你找到了一段大洞!”莉莉感到很难顾,并感觉很重要。她认为这是一只很害怕,她无法把它放在上。
662 万参数模型:
看到一只名叫麦克斯的大狗。麦克斯很爱她。他们玩了一整天。
麦克斯很高兴。他想和她一起玩。但是,麦克斯不愿意和她一起玩。于是,他们又开始一起玩了。
然后,意想不到的事情发生了。狗告诉麦克斯,如果他们善良并原谅他们。 “我们可以一起玩吗?”麦克斯问道。
莉莉点点头,他们玩了一个接球游戏。麦克斯很高兴有一个新朋友。他们和麦克斯一起玩了一整天,他们不再害怕狗了。
159 万参数模型追加 166 个字符,采样到 EOS 后结束;662 万参数模型追加 178 个字符,采样到 EOS 后结束。
提示 3:小男孩发现了一只小狗,(种子 102)
159 万参数模型:
名叫蒂米。蒂米喜欢在他的车子里玩耍,直到在外面玩耍。有一天,蒂米的小狗走进了。蒂米很伤心,说道:“我们这个新玩具车。”
他们看着那只名叫狗。他们不是一张纸。蒂米和狗一起玩。他们一起玩的玩具和大卡车。蒂米问:“我们一起玩吗?”蒂米问道:“是我们的车时候去玩吗?”他们玩具,一边玩得很开心。
当蒂米走向他们家时,他们看到一棵大树上。他们试图吃一些新糖,但他们很伤心。他们不知道该怎么下。但是,意想不到的事
662 万参数模型:
名叫麦克斯。麦克斯喜欢玩他的玩具车。有一天,麦克斯的主人要求麦克斯把他的车给他买一辆新汽车。马克斯非常高兴和兴奋。
那天晚些时候,麦克斯的主人带着一辆名叫莉莉的玩具车回家。莉莉看到麦克斯很伤心,因为他丢了玩具车。莉莉问道:“你为什么悲伤?”麦克斯回答说:“我的玩具车卡在街上了。”莉莉回答说:“我需要一件帮助。”
他们找到了一辆她非常需要的玩具车,并把它放回去。莉莉很高兴她的玩具车又可以修复她的车。
159 万参数模型追加 200 个字符,达到 200 字符上限后停止;662 万参数模型追加 200 个字符,达到 200 字符上限后停止。
提示 4:今天,莉莉和妈妈一起(种子 103)
159 万参数模型:
跑步。他们玩得很开心,玩得很开心。
玩着,莉莉又开始玩耍、玩得很开心。但她无论自己没有点。但是,一个名字叫蒂米。他会看到她必须去公园。她告别,把它们放上,试图把它带到了妈妈妈。蒂米很伤心。他们打扫卫生,然后都感到悲伤。
当他们回到处看到了一个主意。他们回家,又问妈妈是否可以做。蒂米有一个有了一个大狗的玩具。他们玩得很开心,也很开心。
662 万参数模型:
乘坐飞机去飞行。莉莉非常高兴并开始在飞行时发出奇怪的声音。她妈妈说:“我们能给飞机一个大大的拥抱,这样它就不会再飞了。”这是一个非常不安的结束。159 万参数模型追加 167 个字符,采样到 EOS 后结束;662 万参数模型追加 72 个字符,采样到 EOS 后结束。
提示 5:森林里住着一只小猫,它(种子 104)
159 万参数模型:
喜欢在树林里在一起。有一天,小鸟看到一根棍子在长凳上。小猫看起来是一只猫的狗。小猫看着蒂姆、鸟找到这样!
小鸟很高兴,感觉很多了。他不得帮助它。小鸟很高兴飞向猫的路。小鸟感到非常高兴。他们成了朋友。苏和苏成了朋友。他们一起玩了一整天。
662 万参数模型:
很友善。他们决定把玩具车开出去玩。但他找不到他的玩具车。
猫很沮丧,不知道该怎么办。他请求父母帮助它。父亲告诉她这是一个好主意。他们找来了一会儿,并把它带到了商店。他把它装进去,然后把它放进去。 Spot很高兴,并感谢他的父亲。他们继续在路上玩耍,享受到惊人的帮助。
159 万参数模型追加 117 个字符,采样到 EOS 后结束;662 万参数模型追加 133 个字符,采样到 EOS 后结束。
从这五组输出能看出什么?
局部表达更完整了。 662 万参数的版本更常写出完整的小段落:先交代角色,再有对话和引号,结尾也更自然,比如“麦克斯很高兴有一个新朋友”“这是一个非常不安的结束”。人名在一小段里也更稳定,第 1 组里的“本尼”、第 2、3 组里的“麦克斯”都被反复使用。159 万参数的版本更容易出现“一只猫的狗”“玩来玩的时间”这类不通顺的搭配。
情节仍然不稳定。 第 1 组从“小兔子”变成“小女孩”和“小鸟”,名叫“本尼”的主角后来又变成了小鸟;第 3 组里,小狗的故事转成了玩具车,还出现了“一辆名叫莉莉的玩具车”;第 5 组从小猫转到“玩具车”和“父亲”。它更会写出像样的句子,却还不会稳定地守住故事的主角和线索。
这次扩大的实验说明:我们确实可以在 M1 上把同一套 TinyGPT 结构扩大,并在一小时内训练出局部表达更完整的中文续写模型。不过,从“会接一些像样的句子”到“把故事讲清楚”,仍有明显距离。
8.8 加载模型,逐字符生成
训练完成后,checkpoint 里已经保存了词表、配置和学到的权重:
一次生成循环做五件事:将当前前缀编码;前向计算所有位置的 logits;只取最后一个位置的分数;采样一个 token;把它追加到前缀。之后重新运行模型,继续猜下一个。
Temperature 与 top-k:怎样从分数里抽出下一个字
最后一个位置的 3035 个分数,经过 Softmax 变成概率,然后按概率抽一个字。如果直接照原概率抽,会有两个麻烦:成千上万个低分候选各占一点点概率,加起来并不少,偶尔抽到一个就是不通顺的字;而如果每次都取最高分,故事又会变得死板、重复。
所以抽之前,先用两个参数调整一下,它们的分工不同:
- temperature 改变的是谁更容易被抽到。 所有候选都还在,只是概率变了。
- top-k 改变的是谁有资格被抽。 资格外的候选直接排除。
temperature:先把分数除以它,再做 Softmax
设第 个候选的原分数是 ,温度是 。普通 Softmax 把 变成概率,加上温度只多一步:先除以 。
时就是普通的 Softmax。用前面的例子,五个分数是 ,代入 :
为什么 能改变分布的“尖”和“平”?看任意两个候选的概率之比,分母相同,会约掉:
“很”和“在”的分数相差 1,所以它们的概率比是 。 越小,指数越大,差距被放大:
| temperature | “很”与“在”的概率比 | “很”的概率 | 分布 |
|---|---|---|---|
| 2 | 0.43 | 更平 | |
| 1 | 0.64 | 原样 | |
| 0.8(本章) | 0.71 | 略尖 | |
| 0.5 | 0.86 | 更尖 |
两个极端也能从公式里看出来: 时,最高分的优势被放大到压倒一切,几乎每次都取最高分; 时,所有 都趋近于 0,每个候选的概率趋近相同,变成随机乱抽。无论 取多少, 总是正数,所以每个候选的概率都不会是 0,只是有大有小。
top-k:只保留分数最高的 k 个
设 是分数最高的 个候选组成的集合。top-k 在 Softmax 里的改动是:求和只在 里进行, 以外的候选概率直接为 0。
取 、,保留“很、在、开”,分母只剩三项:
“猫”和“山”的概率为 0。分母变小,保留下来的三个候选概率都比原来大一点,总和仍为 1。它们仍然按概率抽,不是永远取最高的“很”。
本章怎么用:,
三步依次进行,合起来就是上面两个公式的组合:
- 把每个分数除以 ,得到 。
- 按分数从高到低,保留前 40 个候选,其余排除。除以正数不会改变排名,所以先除还是先排名,留下的是同一批候选。
- 对这 40 个做 Softmax,然后按概率抽出一个字。
超过 128 个 token 后怎么办?
可学习位置表只有 128 行,不能直接查询位置 128、129 等更远的编号。生成程序采用简单的滑动窗口:
window_ids = ids[-config.context_size:]
# model.forward 内再次建立 positions = [0, 1, ..., len(window_ids)-1]完整输出可以不断变长,但本次前向只看到最近 128 个 token。被裁掉的主角名字或故事设定已经无法直接读取,窗口内的位置也重新编号。
检查自己是否接通了整条链
- 为什么必须先分完整故事,再分别切窗口?
- 为什么
x与y都有 128 个编号,取窗口时却需要 129 个? - 为什么 logits 有 3035 个候选,而 targets 每个位置只有一个整数?
- 为什么保存权重之外,还要保存词表、优化器和随机状态?
- 生成了 300 个字符,是否意味着模型一次能读取 300 个字符?
- 验证 loss 降低,是否就证明故事情节合理?
展开答案
- 保持故事归属,防止同一篇故事的不同部分分散到训练与评估中。
- 输入取前 128 个,目标取后 128 个,二者错开一位,需要共用一段 129 个编号的原片段。
- 每个位置需要给所有候选打分,正确答案只需用一个编号指出是哪一项。
- 词表规定编号含义;优化器、调度器和随机状态让训练能接着原先的过程继续。
- 不能。本机模型只读取最近 128 个 token,旧内容已被裁掉,特殊 token 也占位置。
- 不能。它衡量固定窗口里的下一个 token 预测误差,情节、重复、事实和背诵需要另行检查。