UltraAttn:通过分层上下文切分高效并行 Attention
发布于
UltraAttn:通过分层上下文切分高效并行 Attention
1. 引言:稀疏 Attention 的多卡执行为什么仍然很慢?
长上下文让 Attention 的计算压力持续上升。对长度为 的上下文,标准 Attention 需要处理一个与 对应的计算关系;当上下文从几千扩展到几十万甚至更长时,Attention 很容易成为模型训练和推理中的主要开销。摘要、长文档问答、检索增强生成、代码生成和多模态生成等任务,都需要模型在一次计算中保留更长的上下文。
一种直接的扩展方式是把长上下文沿序列维度切分到多张 GPU 上,让每张 GPU 保存一部分上下文,并协同完成同一次 Attention。这类方法称为 Context Parallelism(CP,上下文并行)。在 CP 中,每张 GPU 先处理自己负责的 Query 区间,同时根据 Attention 的依赖关系获取其他 GPU 上所需的 Key 和 Value,最后合并得到完整的输出。这样,计算工作可以随着上下文长度分布到更多 GPU 上,适合长上下文训练和推理场景。
但把上下文切开,只解决了“每张 GPU 分担多少数据”的第一步。Attention 的每个输出位置都可能需要访问一段 Key 和 Value,分散存储之后,GPU 还要交换自己没有的数据。计算和通信必须交错进行:GPU 一边计算当前拿到的 、、,一边接收下一批数据。如果通信等待、数据搬运或某张 GPU 的计算没有跟上,其他 GPU 也可能被迫等待。
下图用一个 4 张 GPU 的小例子说明问题。左侧是稀疏模式:16 个 Block 中只有第一列和对角线上的 7 个需要计算。右侧按 Ring 方式执行:每一步,各 GPU 把手里的 KV 传给下一张 GPU。Step 0 时每张 GPU 都在算本地 Block;从 Step 1 开始,每一步只有 1 张 GPU 收到了有用的 KV,其余 3 张 GPU 收到的 KV 没有对应计算,只能空等。
它对应两个问题:① Step 1–3 的 12 次 KV 接收中有 9 次白白占用带宽;② 计算集中在少数 GPU 上,其余 GPU 空等。
Block Sparse Attention 把 Attention 矩阵划分为许多 Block,只计算其中被模式选中的部分。没有被选中的 Block 可以跳过,因此总计算量有机会显著下降。这个思路很适合长上下文:模型不必让每个 Query 访问全部上下文,而是根据局部窗口、跨段连接或其他结构化规则访问一部分 Key/Value。
问题在于,跳过计算会让工作负载变得不规则。不同 Query Chunk 可能需要不同数量的 KV Chunk;同一轮执行中,一张 GPU 可能有很多有效 Block,另一张 GPU 可能只有少量有效 Block。于是,多 GPU 系统需要同时处理三种不一致:
- 计算不一致: 不同 GPU 负责的有效 Block 数量不同,完成时间不同。
- 数据需求不一致: 不同 GPU 需要的 Q、K、V 范围不同,不能简单地广播同一份数据。
- 通信不一致: 有些传输只服务于少数有效 Block,固定通信模式可能把不需要的数据也带过来。
因此,稀疏性降低了算术计算量,却提高了并行执行计划的复杂度。
2. 总览:Hierarchical Context-Tiling 如何逐层形成执行计划?
要把一个稀疏 Attention 任务交给多张 GPU 执行,系统首先需要知道三件事:
- Attention Pattern 规定哪些 Attention Block 需要计算
- 上下文数据提供计算所需的 Query、Key 和 Value
- 硬件拓扑则说明 GPU 如何分布在不同 Node 中,以及这些设备之间可以通过哪些路径通信。
UltraAttn 的整体流程,就是把这三类信息逐步转换成一份可以执行的多 GPU 计划:
- Context Remap: 整理上下文在各个 Context Parallel rank 上的布局,让后续的工作负载能够按照统一的结构进行处理。
- Node-Level Context-Tiling: 从节点的角度安排工作负载,处理节点之间的数据交换。
- Device-Level Context-Tiling: 进入节点内部,把工作负载分配给具体 GPU。
有了 GPU 级别的工作负载之后,系统还需要把“要计算什么”变成“怎样执行”:
- Kernel-Level Context-Tiling 负责组织计算 Kernel 和通信 Kernel,调整执行任务的粒度,并保留必要的计算与通信重叠机会。
- Runtime 再根据这些任务之间的数据依赖和资源关系安排执行顺序,生成 CUDA Stream Graph。最终,各 GPU 按照这份图执行自己的计算与通信任务,并在协作中完成完整的 Distributed Attention。
论文 Figure 4 展示了同一条流程的具体形态:输入是 Strided Attention,经过 Context Remap 后依次形成 Node Context Tiles、Device Context Tiles 和 Kernel Context Tiles,最后落到 CUDA Stream Graph。图中的每一步都在缩小执行计划的范围:先决定工作负载如何跨节点分布,再决定节点内由哪些 GPU 承担,接着决定 Kernel 如何组织,最后确定这些 Kernel 的执行顺序。
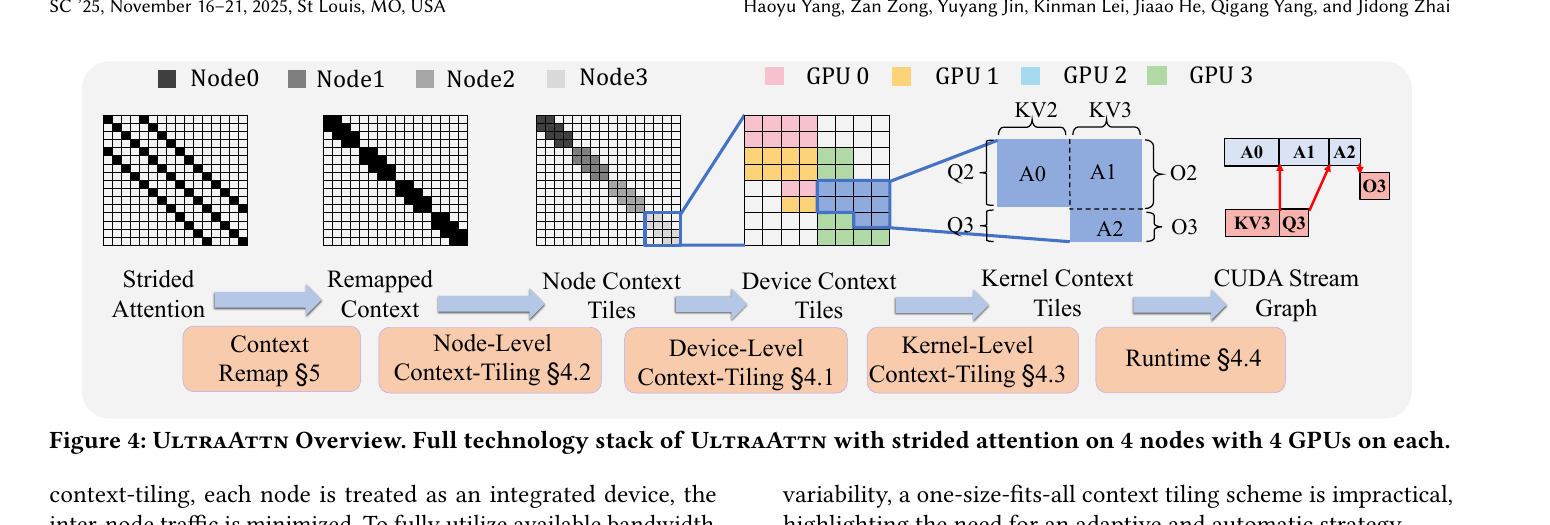
因此,Hierarchical Context-Tiling 可以理解为一条逐层细化的执行链路:它把二维 Attention 工作负载从逻辑布局转换成 Node、GPU 和 Kernel 级别的任务,再把这些任务组织成实际可运行的 CUDA Stream Graph。后文将沿着这条链路,分别解释每一层具体如何完成自己的工作。
3. 二维 Attention 工作负载:从单轴切分到二维切分
第二章已经给出了系统执行的整体流程。现在只补上第四章需要的一个基础:Attention 工作负载本身可以怎样切分。先把 Q 和 KV 分开看,再把两种切分合在同一个二维网格中,就能看清后面要分配给 GPU 的最小工作单元是什么。
在二维 Attention 矩阵中,行对应 Query,列对应 Key/Value(与论文 Figure 2 相同,Q 在纵轴,KV 在横轴)。把 Q 切成若干段、把 KV 也切成若干段后,每个小矩形都表示一组 Q Chunk 和一组 KV Chunk 的交互。这个小矩形就是一个 Attention Block。Block 内所有位置都有效时,可以看作 Full Block;只有一部分位置有效时,是 Causal Block;全部位置都被 Mask 时,就是 Empty Block。第三章只关心这种工作负载结构,具体怎样把 Block 分配给 GPU,留到第四章。
3.1 按 Q 切分:输出区域可以独立计算
先沿 Q 这一维切分。假设把 Query 分成 四个区间,每个 GPU 负责一个区间。对于 ,只要它能够访问计算所需的 和 ,就可以独立计算属于 的输出; 的输出不会改变 的结果。
因此,按 Q 切分的逻辑很直接:每个分片负责一段输出区域,最后沿 Q 维度把局部结果拼起来:
这里的关键是输出归属。 只对应 ,不同 Q 分片之间没有输出归约关系。它的代价也很明显:如果每个 Q 分片都需要访问完整的 和 ,这些 KV 数据就需要被复制或传输到多个 GPU。
3.2 按 KV 切分:局部结果需要合并
再沿 KV 这一维切分。现在让不同 GPU 分别保存 ,但让它们共同服务同一个 Query 。每张 GPU 都可以计算一部分 Attention 分数和局部输出:
但 不是完整输出,不能直接相加或取平均。原因是 Softmax 的分母由所有 KV 分片共同决定。
一个很小的例子就能说明这一点:如果两个 KV 分片上的分数分别是 和 ,每个分片单独做 Softmax 时使用的是不同的分母;把两个局部概率直接拼起来,概率总和也不再对应同一个全局分布。
正确做法是让每个 KV 分片输出一份可以合并的摘要。对分数向量 ,保留三个量:
用来对齐不同分片的数值范围, 是局部归一化统计量, 是经过同一缩放方式加权后的 Value 和。合并两个分片时,先取全局最大值 ,再把两个摘要重新缩放:
这个合并过程可以逐块进行,所以不需要把所有 KV 分片集中到一张 GPU 上。每个分支只需传递 ,后续再把它们归约成完整输出。这就是 KV 维度能够被切分的数学原因。
3.3 合起来看:Q 切分与 KV 切分形成二维 Block
两种单轴切分合在一起,就得到第四章要处理的二维工作负载。Q 切分决定“哪一段输出由谁负责”,KV 切分决定“这一段输出需要从哪些 KV 分片累积信息”。
设 是第 个 Query Chunk, 是第 个 KV Chunk,那么它们的局部交互可以记为:
只完成 与 之间的一部分计算。固定 后,需要沿 KV 方向合并所有有效的 ;完成合并后,再沿 Q 方向拼接不同 的输出。若某个 对应 Empty Block,就可以跳过该计算和相应的数据传输。
到这里,二维 Block 的含义已经明确:它是一个具体的 Q Chunk 与 KV Chunk 之间的局部计算任务。第四章要解决的问题就变成了系统问题:哪些有效 Block 应该交给哪张 GPU,GPU 需要搬运哪些 Q、K、V,怎样在计算负载较均衡的同时减少通信量。
4. Device-Level Context-Tiling:在二维网格上同时平衡计算和通信
第三章留下的问题是:已知哪些 需要计算,应该交给哪张 GPU?本章只处理一个节点内的 张 GPU,并把它们看作彼此对等的设备。跨节点的网络差异留给下一章。
分配方案同时决定两件事。第一,每张 GPU 分到多少计算。第二,每张 GPU 要从别处取来哪些 Q、KV Chunk,又要把哪些部分输出送回 Q 的所有者。
UltraAttn 把这个问题写成整数线性规划(ILP)。本章依次回答四个问题:网格切多细(4.1),每个 Block 交给谁、由此产生什么数据需求(4.2),数据需求怎样换算成通信量(4.3),约束和目标是什么(4.4)。
4.1 先决定切多细:Partition Degree
Q 和 KV 各切成 个 Chunk,得到 的网格, 称为 Partition Degree。它与 是两个量: 是参与并行的 GPU 数, 是网格的边长。、 表示在 的网格上,把有效 Block 分给 4 张 GPU。
为什么不直接取 ?因为 Block 是不可再分的任务。Block 太少而 GPU 较多时,计算量无法被整数个 Block 均分,总有 GPU 多一些、有 GPU 少一些。网格切得越细,可组合的小任务越多,越容易凑出均衡的分配。
要比较“均衡到什么程度”,先要给每个 Block 一个计算量。第三章把 Block 分成 Full、Causal、Empty 三类,论文用三个坐标集合 、、 记录它们,并定义归一化计算量:
Full Block 记 1,Causal Block 近似记 Full 的一半,Empty Block 不计。这是论文定义的权重,可以根据 Profiling 结果调整,不是实测的 FLOPs。
接着定义计算负载不均衡度。理想情况下每张 GPU 分到 ,但 Block 不可拆,单卡计算量的上界取 :
表示在这个计算量定义下可以做到完全均衡;越大,说明由于 Block 不可拆而可能出现的不均衡越严重。它是论文定义的理论上界,不是对 GPU 运行时间的测量。
下面用一个小例子体会 的作用。取 Causal Attention、:下三角的 Block 是 Full,对角线是 Causal,所以 。
图中每个格子对应一个 Block:蓝色是 Full,橙白斜分是 Causal,虚线是 Empty。下表给出同一组数值。
| 2 | 2 | 0.5 | 1 | 1.00 |
| 3 | 4.5 | 1.125 | 2 | 0.78 |
| 4 | 8 | 2 | 2 | 0 |
| 5 | 12.5 | 3.125 | 4 | 0.28 |
时一共只有 2 个单位的计算,却要分给 4 张 GPU,最多的那张至少拿到 1 个单位,是平均值的两倍,所以 。 时恰好每张 GPU 2 个单位。 比 更差,说明 总体上随 增大而下降,但并不严格单调。
也不能无限增大。网格有 个 Block,后面的 ILP 要为每个有效 Block 决定归属,变量个数随 增长,求解会变慢。论文因此设定阈值 ,选择第一个满足要求的 :
在上面的例子里,若 ,。论文说明 是按不同配置凭经验调整的,没有给出统一取值。这里的选择规则是“满足均衡要求的最小 ”,而不是“ 越大越好”。不同 对求解时间的实际影响,留到实验章用论文的 Table 4 讨论。
4.2 再决定交给谁:从 Block 分配到数据需求
网格确定后,需要三类变量来描述一个分配方案。先说明数据最初放在哪里。论文定义映射 ,表示每个 Context Chunk 初始存放在哪张 GPU 上。Self-Attention 中 Q 和 KV 来自同一条序列,使用同一个映射。默认做法是均匀切开、按设备编号顺序放置:
这里假设 能被 整除。、 时,GPU0 拥有 Chunk 0、1,GPU1 拥有 Chunk 2、3,依此类推。
接下来是决策变量 : 表示 Block 由 GPU 计算。它是 ILP 要求解的核心。
与 是两件独立的事,通信正是它们不一致造成的。例如 存在 GPU1, 存在 GPU2,而 被分给 GPU0,那么 GPU0 必须把这两块数据取过来才能算。
由 可以直接推出数据需求,论文用两个 0/1 变量记录:
- :GPU 是否需要 。只要 分到了第 行的任一 Block,就需要。
- :GPU 是否需要 。只要 分到了第 列的任一 Block,就需要。
用同一个 4 GPU 例子(第 个 Chunk 初始在 GPU ,,7 个有效 Block)演示。
图中 GPU 卡片的内容与下表一致:
| GPU | 初始持有() | 分到的 Block | 需要的 Q() | 需要的 KV() |
|---|---|---|---|---|
| GPU0 | 、 | 、 | 、 | |
| GPU1 | 、 | 、 | 、 | 、 |
| GPU2 | 、 | 、 | 、 | |
| GPU3 | 、 |
这里下标写作 , 是 Q 的行号, 是 KV 的列号,与引言图中的“第一列加对角线”一致。
对照 可以看到:GPU0 本地没有 ,要把它取过来;GPU2 本地没有 和 ,也要取。需要注意,、 只记录“需要与否”,它们不是传输次数,也不是额外的计算任务。
4.3 把数据需求变成通信账本:A、B、C、D
有了 、 和 ,就可以逐张 GPU 数出要搬多少 Chunk。论文在 Table 2 中定义了四个计数变量,按“谁拥有数据、谁需要数据”区分:
| 变量 | 统计对象 | 公式 | 传输内容 |
|---|---|---|---|
| 需要、但本地没有的 Q Chunk | 接收 Q;发送部分 O | ||
| 需要、但本地没有的 KV Chunk | 接收 KV | ||
| 拥有、被其他 GPU 需要的 Q Chunk 份数 | 发送 Q;接收部分 O | ||
| 拥有、被其他 GPU 需要的 KV Chunk 份数 | 发送 KV |
同时对应 Q 的接收和 O 的发送,原因是:GPU 取到别处的 并完成相关 Block 后,产生的部分输出要送回 的所有者。 是反向的一侧:拥有 的 GPU 把 Q 发出去,同时要接收别人算出的部分 O。从输出汇总的角度看,这正是第三章沿 KV 方向做 Online Softmax 归约时必然出现的数据流。
不同数据的大小不同。论文针对 Forward Attention 取 Q 和 O 的权重为 1,KV 为 2(K 和 V 各一份)。每张 GPU 的接收量与发送量就是:
接收侧: 是 Q, 是 K 和 V, 是别人送回的 O。发送侧: 是 O, 是 Q, 是 K 和 V。这些系数是 Forward 的设定;论文指出,Backward、GQA 和 Cross-Attention 的数据大小关系不同,需要调整权重。
把 4.2 的表代入,得到下面的账本(示意计算,按公式手算并用脚本复核):
| GPU | ||||||
|---|---|---|---|---|---|---|
| GPU0 | 1 | 0 | 0 | 1 | 1 | 3 |
| GPU1 | 1 | 1 | 1 | 0 | 4 | 2 |
| GPU2 | 1 | 1 | 1 | 1 | 4 | 4 |
| GPU3 | 0 | 0 | 1 | 0 | 1 | 1 |
这里的数字统计的是论文模型里的归一化 Chunk 数,不是字节数,也不是通信时间。它没有考虑链路带宽、消息大小对效率的影响,也没有考虑通信与计算的重叠。论文用它作为优化目标的代理量。
4.4 约束与目标:为什么最小化最大通信量
变量齐了,接下来说明哪些分配是允许的(约束),在允许的分配里怎样挑最好的(目标)。论文 Table 3 的约束可以分成四组。
第一组,唯一分配。 每个非空 Block 必须且只能分给一张 GPU:
不漏算,也不重算。Empty Block 不参与分配。
第二组,需求标记。 只要 GPU 分到了某个 Block,就必须标记它需要对应的 Q 和 KV:
这里只写了“大于等于”。原因是目标会惩罚多余的需求标记,最优解里没有必要的 、 会自动取 0,所以不必强制写成等式。
第三组,通信量定义。 就是 4.3 的 、、、、、 六个式子。
第四组,计算负载约束。 每张 GPU 的归一化计算量不能超过阈值 :
论文实验中取 ,即理论平均值向上取整,并说明这接近负载均衡所能采用的最严格约束。要区分两个阈值: 在 4.1 决定“网格切多细”, 在这里限制“每张 GPU 最多拿多少”。
约束只划定可行范围,还需要一个目标来挑选方案。论文定义最大通信量 :
是所有 GPU 的接收量和发送量中最大的那个,目标是把它压到最小。这里取最大值而不是总和,是因为各 GPU 并行传输,完成时间更接近由最忙的那张卡决定。这是论文的设计取向;上面关于关键路径的解释是合理推断,论文没有证明它在所有硬件上等价于最短通信时间。
把整个模型放在一起:
其中 、、 是 0/1 变量,其余通信量和 是整数变量。输入是 Attention Pattern、、 和 ;输出是每个 Block 的归属。
回到引言的 4 GPU 例子(第 个 Chunk 初始在 GPU ,,7 个有效 Block 是第一列加对角线,全部按 Full Block 计,)。我用脚本穷举了全部 种分配,在满足 的方案里:
| 分配方式 | 每卡 Block 数 | 最大通信量 |
|---|---|---|
| 每张 GPU 只算自己那一行( GPU ) | 1、2、2、2 | 6(GPU0 发送 给三张卡) |
| 4.2 的构造方案 | 2、2、2、1 | 4 |
| 穷举得到的最小值 | - | 4(共 24 种分配达到) |
这是对示意规模的穷举,不是论文的实验。它只说明:同样满足负载约束,不同分配的最大通信量可以相差一截,而 ILP 做的就是在这些分配里找最小的那个。
4.5 小结:Device-Level Context-Tiling 交付了什么
上图把本章的变量串在一起,数值取自 4.2 到 4.3 的构造示例。
把 4.1 到 4.4 串起来,Device-Level Context-Tiling 的流程是:
- 根据 Attention Pattern 和 计算 ,按 选出 ,得到 网格。
- 按 确定每个 Chunk 的初始位置。
- 建立 ILP:变量 、、,约束为唯一分配、需求标记、通信量定义和 ,目标是 。
- 求解后得到每张 GPU 的 Block 列表。再由 、 得到它需要的 Q、KV Chunk,由 得到哪些要从别处取,哪些部分输出要送回 Q 的所有者做归约。
输出是一份设备层的工作负载计划:谁算哪些 Block,需要哪些数据,数据从哪来。它还不是最终的执行顺序,后面的 Kernel 层会调整任务粒度,Runtime 会排定执行次序。
需要记住它的证据范围。通信量是论文模型里的归一化 Chunk 数,不是实测字节或时间。负载用 近似,权重可以由 Profiling 调整。系数针对 Forward Attention。 的选择依赖经验阈值。
这一章还有一个前提没有处理:模型把一个节点内的 GPU 看作对等设备,所有 Chunk 之间的传输代价被视为相同。跨节点之后,节点内 NVLink 与节点间网卡的带宽差别很大,只最小化 Chunk 数不够。下一章讨论 UltraAttn 如何把拓扑差异纳入切分。
5. Node-Level Context-Tiling:让切分适应跨节点网络拓扑
第四章把一个Node内的 GPU 当作对等设备:只要两张卡之间传的 Chunk 数相同,代价就相同。多节点集群里这个假设不再成立。本章只讨论假设失效之后要补什么:先在Node层面分工,再把Node内部的分工交给第四章的方法。论文在这一节没有给出新的 ILP 公式导。
5.1 第四章的账在哪里不再成立
第四章用 比较分配方案,它数的是 Chunk 个数。把 Chunk 数当作通信开销的代理,需要一个前提。论文在 Section 4.2 开头写得很明确:用通信量近似性能,是假设连接所有设备的网络拓扑是对称的。
多节点集群没有这种对称。同一个Node内,GPU 之间通过 NVLink 等互连通信。不同Node之间,数据要经过 NIC 和Node间网络。两类链路的带宽、路径和可用资源都不同,论文把这个现象称为网络异构。
下面用一个小例子看这个差别。取两个 Node,每个 2 张 GPU。两种分配方案里,GPU0 都要向外发送 4 个 Chunk,按第四章的账,两个方案的 都是 4。区别只在接收方:方案甲发给同节点的 GPU1,方案乙发给另一个节点的 GPU2。
账面上两个方案相同,实际代价却不能直接比较。图中没有标带宽数字,这是示意,不是测量。结论是:跨节点之后,只最小化 Chunk 数不够,切分还要知道哪些传输走哪类链路。
5.2 Ring 跨节点时浪费了什么
引言讨论过 Ring 在稀疏模式下的两个问题:冗余传输和负载不均。跨节点时还有第三个问题:Ring 的通信路径和硬件拓扑不匹配。
论文 Figure 3(a) 画了这个情形。把所有 GPU 串成一个 Ring 并扩展到多个Node后,节点之间的流量集中在少数几条路径上。论文给出的数字是:在这个例子里,只有一个节点上 2 个 NIC 的单向带宽被利用,造成 75% 的带宽浪费。Figure 3 的题注还指出,浪费的不只是 NIC 带宽,也包括 NVLink 带宽。
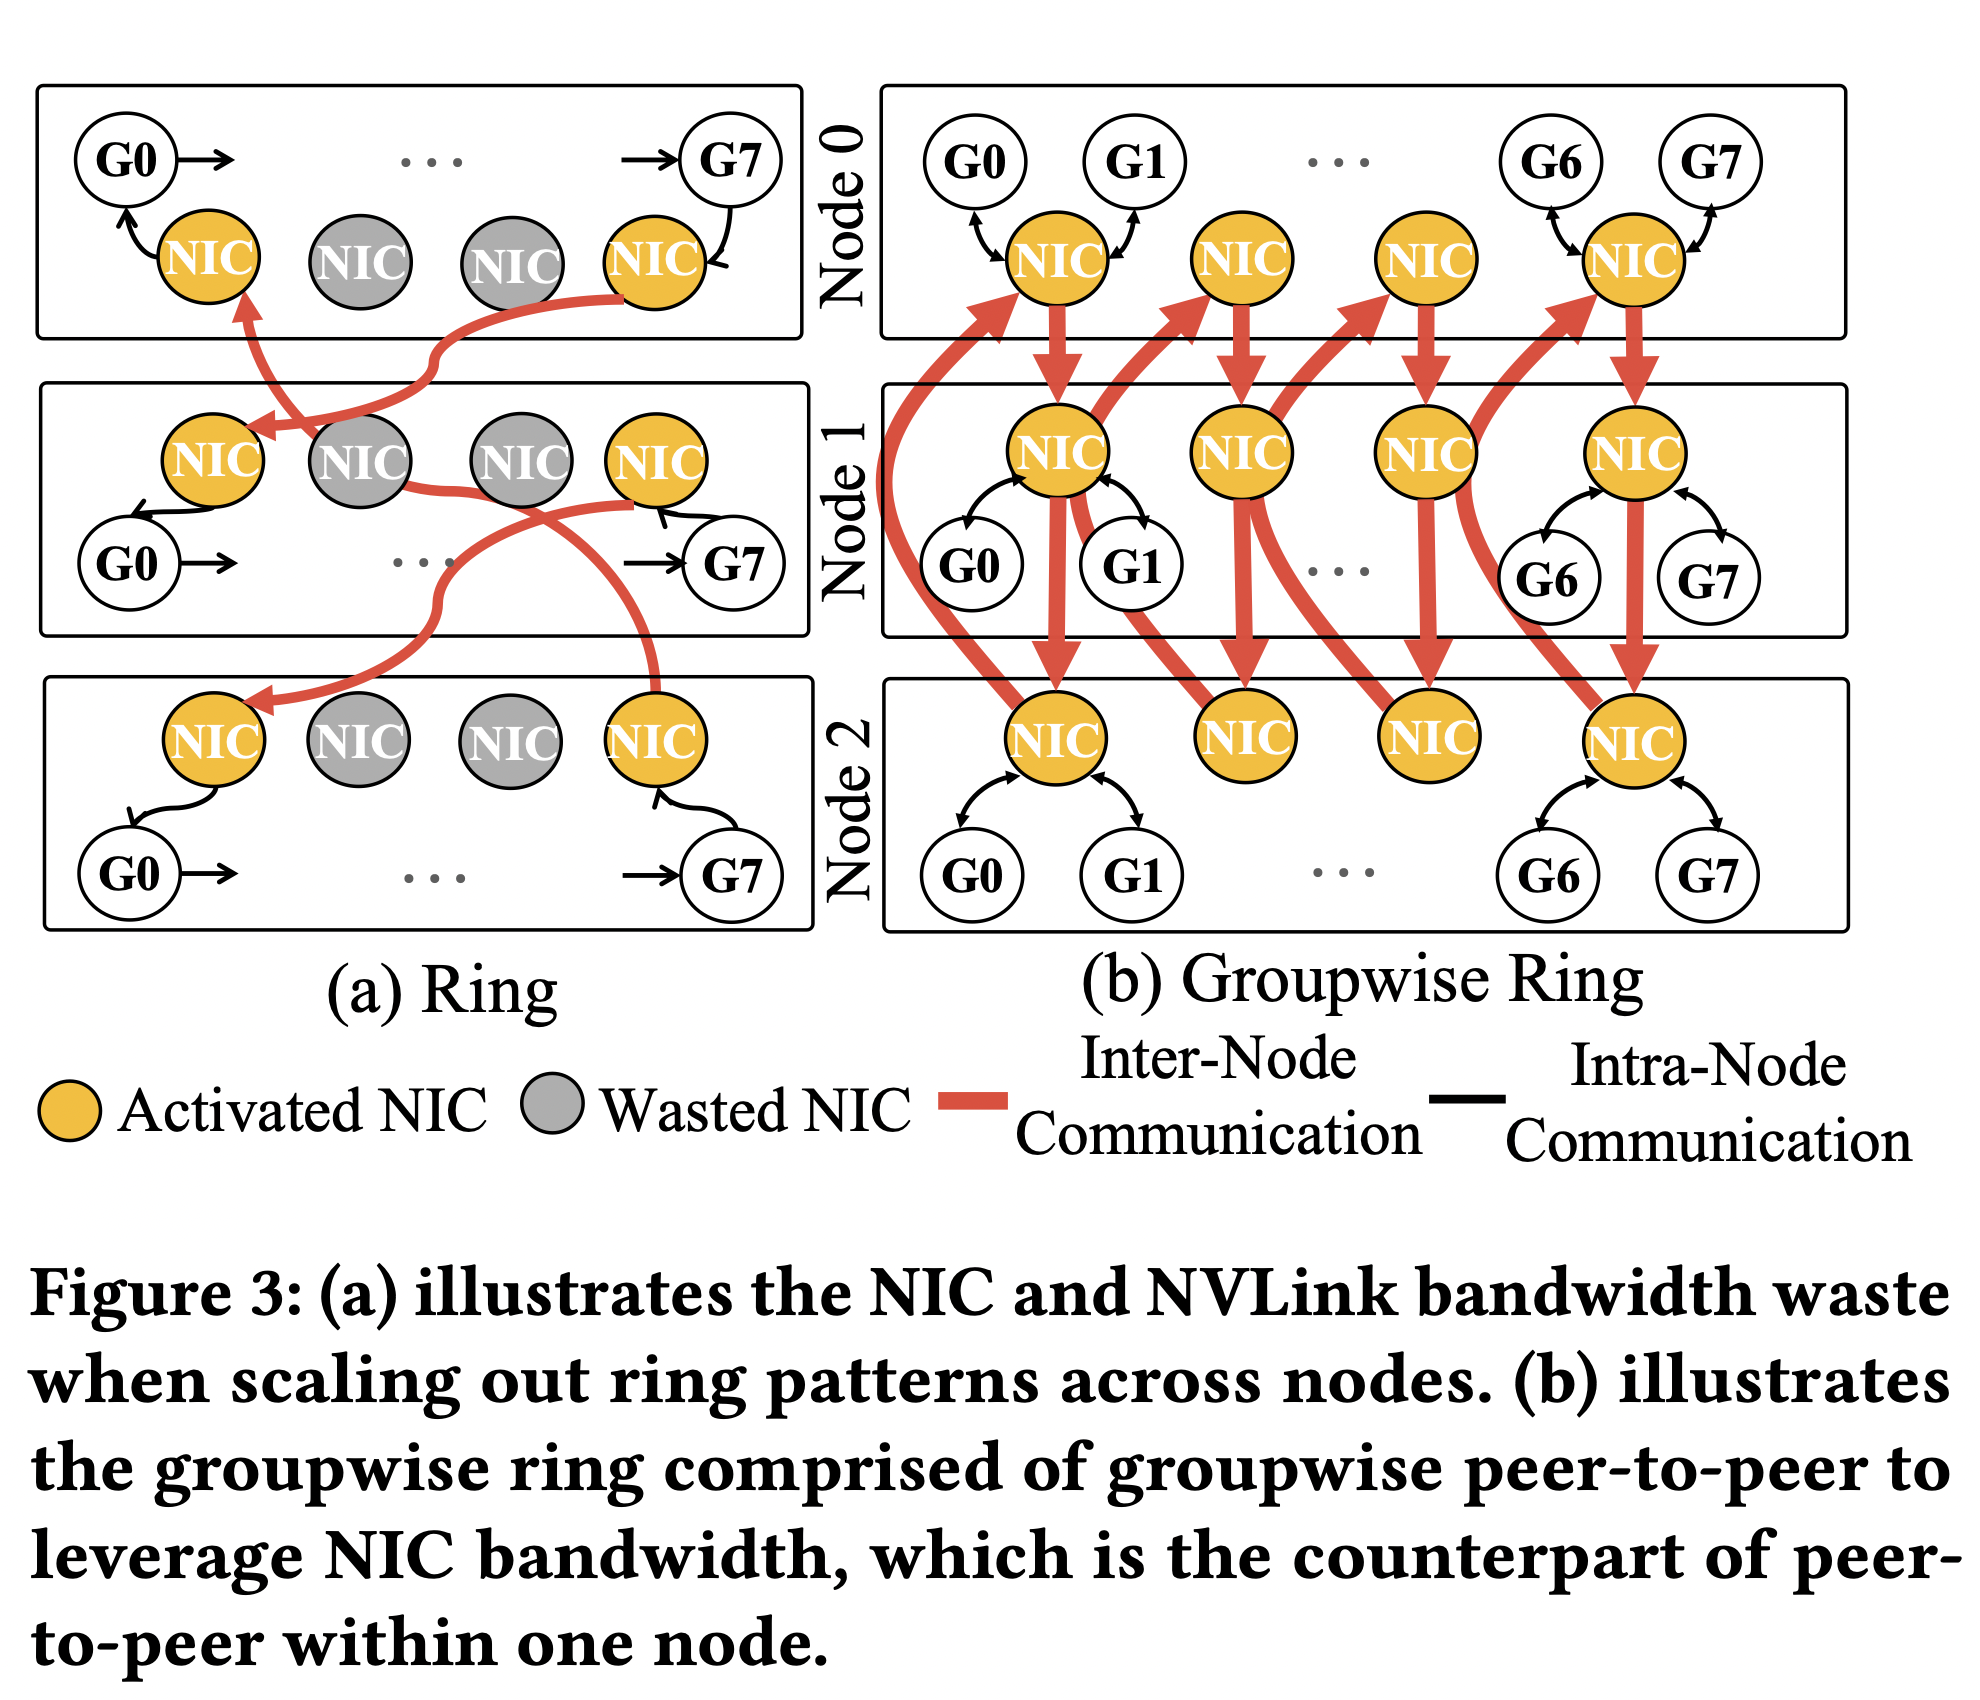
读图时注意图例。黄色圆点是被激活的 NIC,灰色圆点是被浪费的 NIC。粗红线是节点间通信,黑线是节点内通信。
这个数字只对 Figure 3(a) 这一个配置成立,不能当成所有 Ring Attention 集群的一般结论。它说明的是一种机制:浪费来自通信模式没有用满硬件提供的 NIC。本节只讲图 (a),图 (b) 留到 5.4。
5.3 先把 Node 当成一个整体设备
拓扑不对称时,UltraAttn 的做法是把问题拆成两层。论文的原话是:在 Node-Level Context-Tiling 中,每个 Node 被当作一个整体设备(integrated device),Node之间的通信量被最小化。先只决定哪个 Node 负责哪部分工作负载,再在 Node 内部把工作分到具体 GPU。
用 4 个 Node、每个 8 张 GPU 的集群说明。设备层的视角里有 32 个独立设备,要同时处理它们两两之间的通信。Node层的视角只有 4 个整体设备,第一步只回答“哪个 Node 算哪部分”。第二步再展开单个 Node,用第四章的方法在它的 8 张 GPU 之间分配。
这样拆为什么能处理异构?论文给出的理由是对称性只在节点层面存在。原文写道:GPU 之间不存在完美对称,但在节点层面存在按组的对称,所有Node通过若干 NIC 相互连接,形成这种对称。换句话说,Node内部的通信环境相近,Node之间也可以按组看成对称,两层各自满足第四章“拓扑对称”的前提。
5.4 Groupwise Peer-to-Peer:节点之间怎样交换数据
Node成了通信的基本单位,通信方式也要换。第四章里,GPU 之间的点对点通信(P2P)是基本单位。论文在Node层面的对应物叫 Groupwise Peer-to-Peer:以Node为单位,成组地交换数据。多个 Groupwise P2P 连成环,就Figure 3(b) 的 Groupwise Ring。节点内部仍然用设备级的 P2P。
回看 Figure 3(b):同样是三个节点,每个节点的多个 NIC 都有粗红线经过,节点间的流量分摊到了所有 NIC 上,而不是挤在图 (a) 那几条路径里。
上图是示意,每个节点只画 4 张 GPU 和 4 个 NIC。具体怎样分组、每组多大、NIC 与 GPU 怎样绑定,论文正文没有展开,图中也不代表论文的分组方式,以 Figure 3(b) 为准。
论文总结了它的两点优势:与节点之间的拓扑匹配得更好,并且能用上所有 NIC。它是一种面向节点组的通信组织方式,不是新的底层网络协议。
5.5 两层怎样对应,又怎样接起来
Node-Level 没有另起一套算法,而是照着 Device-Level 做类比。论文说,为了说明节点层面的可行性,它把两层方法的基本元素一一对应起来:
| 元素 | Device-Level(第四章) | Node-Level(本章) |
|---|---|---|
| Workload Block | 单张 GPU 上的 Attention 计算 | 单个 Node 上的 Distributed Attention 工作负载 |
| 通信基本单元 | GPU 之间的 Peer-to-Peer | Node 之间的 Groupwise Peer-to-Peer |
| 性能数据来源 | Profiling 测量 Block 和 P2P 的性能 | 跨节点 Profiling 测 Groupwise P2P;Block 性能在单节点上实现 Device-Level 后测其执行时间 |
Node 层的一个 Block 本身就是一个节点内多张 GPU 协同完成的工作负载,所以它的耗时可以先在单节点上用第四章的结果跑出来,再交给节点层使用。
论文把两层方法的关系总结为“详细方法是类比的”(analogous)。它没有在这一节重新写出 Node-Level 的变量、约束和目标。
合起来的执行流程是两步。第一步,Node-Level 把工作负载分配给各个 Node,目标是减少节点之间的通信,并用上所有 NIC。第二步,对每个 Node,用第四章的 Device-Level 方法把它分到的工作负载分配给节点内的 GPU。这正是第二章 Figure 4 里 Node Context Tiles 到 Device Context Tiles 的两个阶段。
到这里,每张 GPU 算哪些 Block、数据从哪来都已经确定。剩下的问题是:这些计算和通信任务,应该以多大的粒度作为 Kernel 去执行。下一章回答这个问题。
6. Kernel-Level Context-Tiling:在融合效率与重叠机会之间选粒度
前五章已经确定了每张 GPU 算哪些 Block、数据从哪来。本章的问题更小:这些计算和通信任务,合并成多大的 Kernel 去执行。本章只决定 Kernel 的大小,不决定它们的先后顺序,顺序留给第七章。
6.1 粒度谱:Kernel 切得细好还是粗好
同一份工作负载,可以切成很多小 Kernel,也可以合成少数大 Kernel。论文 Figure 1(d) 把这个选择画成一条粒度谱。
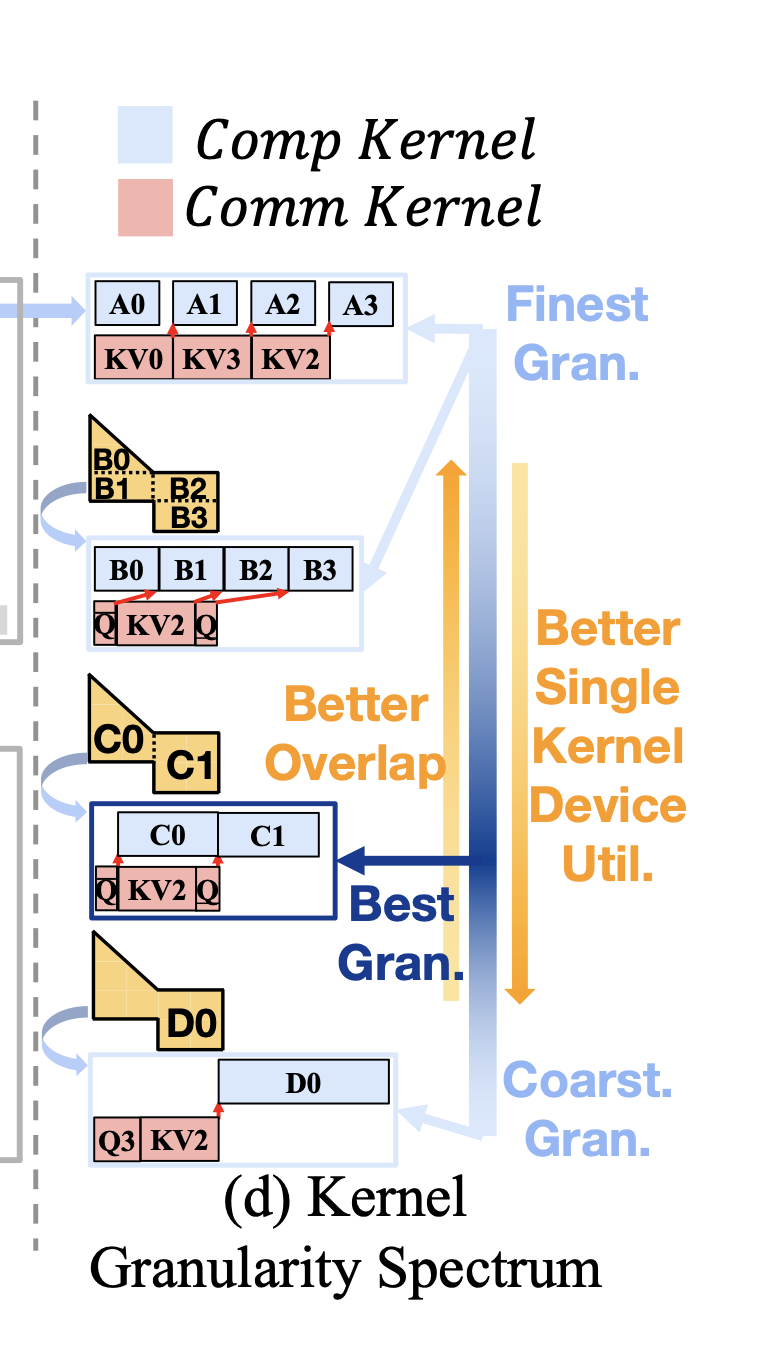
图中同一块黄色工作负载对应四个蓝框,从上到下由细到粗。蓝色方块是计算 Kernel,红色方块是通信 Kernel。
两端各有所长。细的一端,计算 Kernel 小,通信容易和它们错开重叠(流水线机制),调度灵活。代价是每个小 Kernel 填不满 GPU,单个 Kernel 的设备利用率低。粗的一端,Kernel 大,利用率高。代价是可重叠的空间变少。
论文的判断是,最优点落在中间,也就是图中标 Best Gran. 的第三个框。具体位置由任务配置和硬件配置共同决定,所以要自适应地选。这一步就叫 Kernel-Level Context-Tiling。
再用论文 Figure 5(a) 看一个具体的例子。上半部分是最细的切法,下半部分是合并之后的切法。
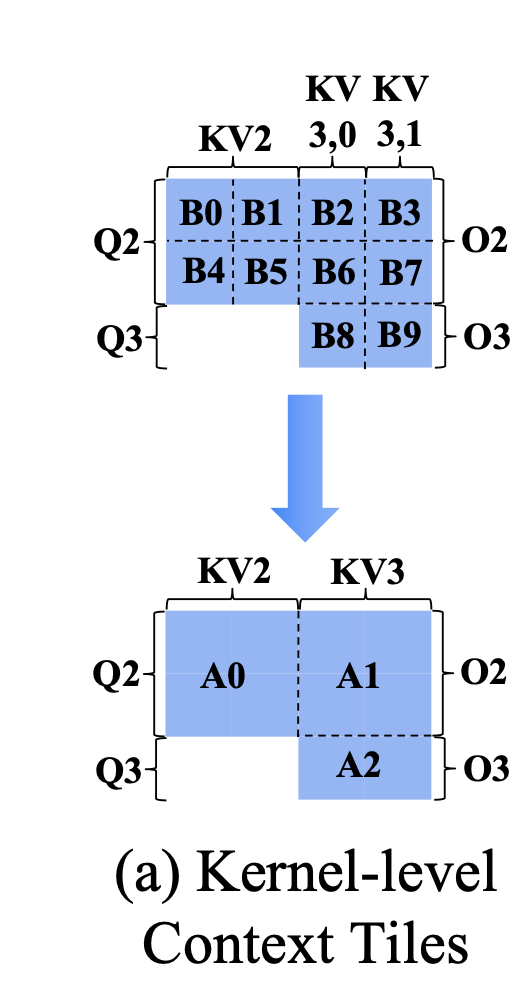
行是 Query,列是 KV,蓝色格子是需要计算的 Block。Q2 这一行有 8 个小 Block(B0 到 B7),Q3 这一行有 2 个(B8、B9),共 10 个。最细的粒度下,每个 Block 是一个 Kernel,共 10 个。图中把它们合成了 3 个 Kernel:
- A0 由 B0、B1、B4、B5 组成,对应 Q2 与 KV2。
- A1 由 B2、B3、B6、B7 组成,对应 Q2 与 KV3。
- A2 由 B8、B9 组成,对应 Q3 与 KV3。
被合成一个 Kernel 的这一块工作负载,称为一个 Kernel Context Tile。
6.2 Parallel Dependency Graph:把计算和通信放进同一张图
要决定哪些 Kernel 能合并,先要知道它们之间的关系。论文用一张有向无环图(DAG)描述 Node 层和 Device 层分配之后的全部 Kernel 及其依赖,称为 Parallel Dependency Graph。
图中有三类节点:计算 Kernel 画成矩形,接收 Kernel 画成椭圆,发送 Kernel 画成菱形。箭头表示依赖:箭头起点完成之后,终点才能开始。
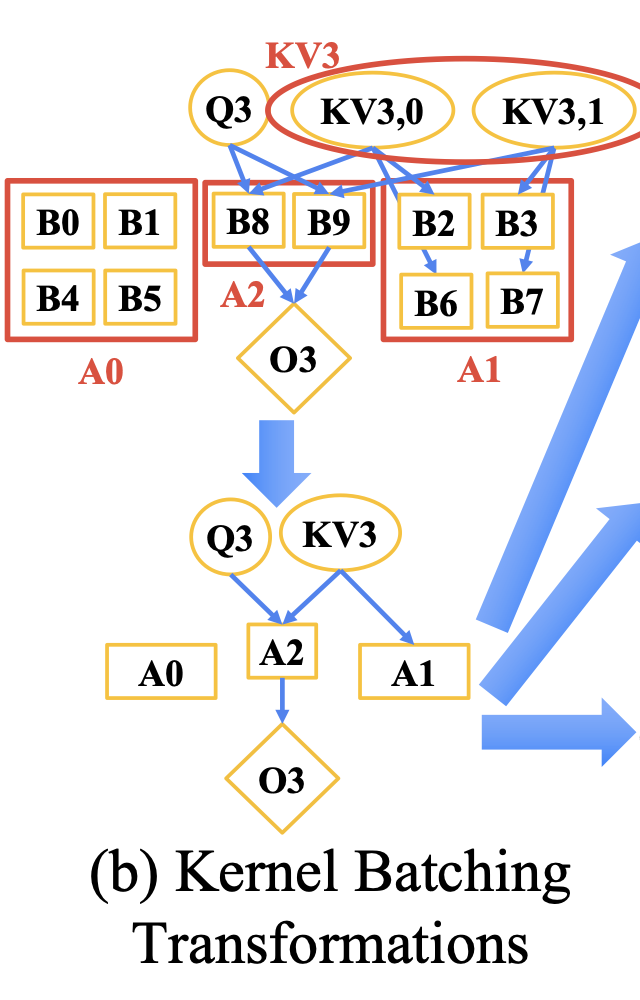
先看下方合并后的小图。它由 6.1 的 A0、A1、A2 加上通信 Kernel 组成:
- Q3 和 KV3 是接收 Kernel。
- A2 有两条入边,要等 Q3 和 KV3 都到齐。
- A1 只有 KV3 一条入边。
- A0 没有入边,只用本地数据就能算。
- O3 是发送 Kernel,要等 A2 算完才能发出。
依赖决定哪些 Kernel 可以同时执行。如果 X 必须等 Y 完成,两者只能一前一后。如果图中 X 和 Y 之间没有边,谁也不用等谁,才有机会同时执行。
以上图为例:A0 和 Q3、KV3 之间没有边,等数据到达的时候可以先算 A0。A1 和 A2 之间也没有边,KV3 到齐之后,两者可以同时执行。
依赖只说明”能不能”同时执行,实际能不能同时跑,还要看硬件资源,第七章再讲。
6.3 三类变换:哪些 Kernel 可以合并
论文 Section 4.3.1 定义了三类替换,每一类都有前提。
| 变换 | 合并什么 | 前提 | Figure 5(b) 中的例子 |
|---|---|---|---|
| 计算 Kernel 合并 | 多个计算 Kernel 合成更大的计算任务 | 取决于底层的 Attention 计算库(后端)能接受什么输入形状,见表后说明 | B0、B1、B4、B5 合成 A0;B2、B3、B6、B7 合成 A1;B8、B9 合成 A2 |
| P2P 通信 Kernel 合并 | 多个点对点通信合成一次批量通信 | 源 Rank 和目标 Rank 都相同 | KV3,0 和 KV3,1 合成 KV3 |
| 集合通信替换 | 多个 P2P Kernel 合成一个集合通信 Kernel | 论文只写”在某些情况下” | 图中没有对应例子 |
关于第一类的前提:合并后的 Kernel 要一次算完原来的几个 Block,所以计算库必须能接受这个组合。
第三类论文没有列出适用条件,也没有说是哪一种集合通信,所以不能理解成任意一组 P2P 都能换成集合通信。
Figure 5(b) 里的红色轮廓,标出的就是被合并的部分。
6.4 合并的收益与代价
合并的好处用 Gain 衡量。论文把一个变换的收益定义为融合前后的耗时差:
- :被合并的几个 Kernel 分开执行的耗时之和。
- :合并之后这一个 Kernel 的耗时。
- 差为正,说明单看这几个 Kernel,合并是赚的。
合并也有代价。论文的说法是,Kernel Batching 会缩小 Kernel 之间可以重叠的空间,在某些情况下结果反而更差。
Figure 5(b) 里的 KV3 可以说明这一点。合并前,KV3,0 和 KV3,1 是两个接收 Kernel,依赖其中一个的计算在它到达后就能开始。合并后只剩一个 KV3,依赖它的 A1 和 A2 要等整块数据到齐。
所以 Gain 只回答”这几个 Kernel 合并后自己快不快”,不回答”整张图最后快不快”。
6.5 Greedy Transformation Selection:怎样挑出要合并的那些
先在原图上做子图匹配,把三类替换能用的地方都找出来,得到候选变换集合。设候选共有 个。
每个候选可选可不选,共有 种组合。下表只是算术示例:
| 5 | 10 | 20 | |
|---|---|---|---|
| 组合数 | 32 | 1,024 | 1,048,576 |
评估一种组合的整图耗时,要用第七章的 ILP,代价不低。论文因此认为遍历整个空间不可行,改用贪心。
贪心按五步进行:
- 计算每个候选的 Gain,从大到小排序。(优先使用高收益合并)
- 按顺序取出一个候选。如果它涉及的 Kernel 已被前面的变换改过,就跳过。例如先合并了 A0 与 A1,后面涉及 A1 的候选就不再适用。
- 把适用的候选应用到当前的图上。
- 把更新后的图交给 Topology-aware Lowering Engine,评估整图的执行时间。
- 时间变短就保留新图,否则退回上一版。然后取下一个候选。
Topology-aware Lowering Engine 论文只在这一处提到这个名字,指向 Section 4.4,没有单独定义它。按 4.4 的内容理解,它负责把依赖图按实际网络拓扑排成一张 CUDA Stream Graph,并给出这张图的执行时间。具体做法是第七章的 ILP 调度。这是我对论文的理解,论文没有明说。
这里有两层判断。Gain 只决定尝试的顺序,是否保留要看整图耗时。Gain 为正的变换也可能被退回,因为整图耗时还受依赖、通信竞争和调度的影响。
论文称这个方法为 greedy,并说明这样做是因为全空间搜索不可行。论文没有它的最优性证明,也没有找到它与穷举的对比。因此本文只说它在可接受的搜索时间内挑出一组变换,不说它找到了全局最优。
6.6 本章交付什么,留下什么
本章交付的是一张粒度已定的 Parallel Dependency Graph:节点是合并后的 Kernel,边是依赖。
这张图只规定了谁等谁,没有规定谁先谁后,也没有规定放在哪个 CUDA Stream。论文 Figure 5(c) 说明了这个缺口:从同一张合并后的图出发,可以排出三种不同的时间线,总耗时各不相同。
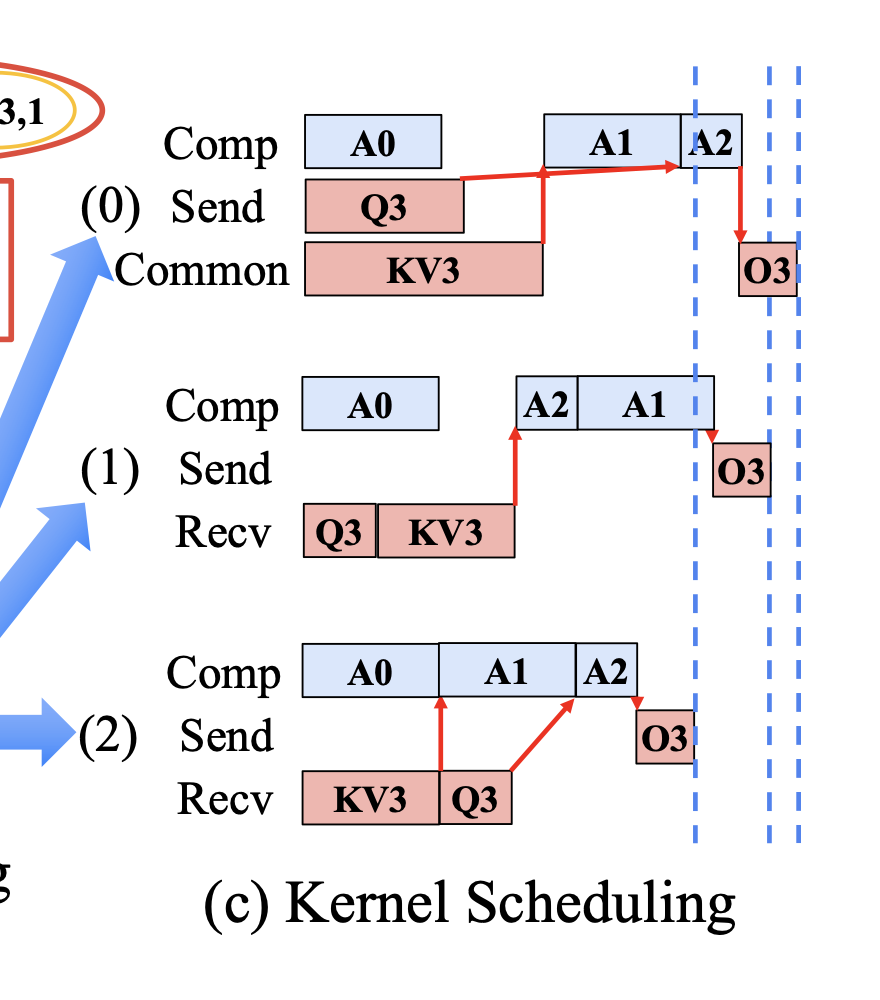
三种排法的 Kernel 和依赖完全相同,只有 Stream 分配和顺序不同。论文把 (2) 作为最优 CUDA Stream Graph 的例子。接下来第七章就来讲解如何找到(2)这种最优解。
7. UltraAttn Runtime:用 ILP 把依赖图排成低延迟顺序
第六章交付了一张粒度已定的依赖图,它只规定了谁等谁。本章回答下一个问题:怎样把这张图排成一份可以执行的 CUDA Stream Graph。要定两件事,哪些 Kernel 放进同一个 Stream,以及同一个 Stream 里谁先谁后。
7.1 依赖之外,还有两件事决定快慢
6.6 放出了 Figure 5(c),这里把它再读一遍。
读图方式:每个子图有三行,Comp 是计算,另外两行是通信。方块的左右位置是执行的时间段,红色箭头是依赖,蓝色虚线对齐各方案的结束位置。三种排法的 Kernel 和依赖完全相同,结束位置却不同:(0) 最晚,(2) 最早。
差别来自两件事,论文把它们分开讲。
第一件,通信竞争。 两个 Kernel 之间没有依赖,同时执行不一定更快。如果它们用同一份带宽,同时传输会互相拖慢,每个的耗时都变长,合起来可能比一个接一个更差。论文用 Figure 5(c)(0) 说明这一点:图中 Q3 和 KV3 在两行里同时传输,A1 和 A2 都开始得最晚。
第二件,次优调度。 共用带宽的 Kernel 放进同一个 Stream 之后,它们不再同时执行,但先后顺序仍然要选。Figure 5(c)(1) 和 (2) 就是 Q3 与 KV3 共用输入带宽时的两种顺序。
先收哪个,会改变后面的计算何时能开始。回到 Figure 5(b) 的依赖关系:A1 只等 KV3,A2 要等 Q3 和 KV3。(2) 先收 KV3,所以 A1 能早点开始,计算单元几乎连续工作。(1) 先收 Q3,KV3 到得晚,A1 和 A2 都要等。
| 因素 | 现象 | 论文的对策 |
|---|---|---|
| 通信竞争 | 共用带宽的 Kernel 同时执行,各自变慢 | 共用同一份带宽的 Kernel 放进同一个 CUDA Stream |
| 次优调度 | 同一个 Stream 里先后顺序影响后续计算的开始时间 | 用 ILP 求最短的顺序 |
论文提到,此前的 FlexFlow 用 BFS 找一个可行的拓扑序,也就是满足全部依赖的某一种顺序。可行不等于最短,论文说从众多顺序中找最优仍然困难,所以改用 ILP。6.4.3 节拿重新实现的 FlexFlow 调度做了对比,结论是 ILP 在多数场景持平或更好,在依赖复杂、计算和通信耗时相当的场景里优势更明显。具体数字放到第九章。
下面两节分别讲这两条对策:先讲 Stream 怎么分,再讲 ILP 怎么排顺序。
7.2 资源感知的 Stream 分配:共用资源的放一起,不共用的放开
先说明 CUDA Stream 是什么。同一个 Stream 里的操作按顺序执行,不同 Stream 里的操作有机会并行。所以 Stream 的分组,就是在规定哪些 Kernel 一定不重叠,哪些可以重叠。
论文 Section 4.4 给出两条规则:
- 共用同一份带宽的 Kernel,放进同一个 CUDA Stream,避免通信竞争。
- 不共用资源的 Kernel,放进不同的 CUDA Stream,最大化重叠。
这一步只是分组规则。分好组之后,每个 Stream 内部的先后顺序还没有定,这才是 ILP 要解决的问题。论文 4.4.2 开头也是这样分两步写的:先分 Stream,再定每个 Stream 内的顺序。
论文没有给出判断”两个 Kernel 是否共用资源”的具体算法。
7.3 ILP 模型:变量、约束、目标
先说模型要找什么:给每个 Kernel 找一个开始时间,使整张图尽早结束,同时满足三类要求。ILP 并不重新分配 Block,也不重新决定哪些 Kernel 合并,它的输入是已经定好的依赖图和 Stream 分组。
先看变量。
| 符号 | 含义 | 是待求的吗 |
|---|---|---|
| Kernel 的开始时间 | 是 | |
| Kernel 的执行时长,来自 Profiling | 否,已测得 | |
| 整张图的完成时间 | 是 | |
| 0 或 1,表示 是否排在 之前 | 是 | |
| 的预设上界 | 否,预先给定 |
为了让每个式子都有数可代,下面用一个构造的小例子。依赖取 Figure 5(b) 合并后的图:A1 只等 KV3,A2 等 Q3 和 KV3,O3 等 A2,A0 没有依赖。Q3 和 KV3 共用输入带宽,在同一个 Stream。耗时设为下表。这是示意,不是论文数据。
| Kernel | Q3 | KV3 | A0 | A1 | A2 | O3 |
|---|---|---|---|---|---|---|
| 耗时 (μs) | 20 | 10 | 10 | 20 | 10 | 10 |
先不管公式,直接看这个例子里两种接收顺序的结果。计算只有一个 Stream,A1 和 A2 不能同时算。
- 先收 KV3:KV3 在 10 μs 到达,A1 马上开始,与 Q3 的接收重叠。Q3 在 30 μs 到达,A2 接着算。整图在 50 μs 结束。
- 先收 Q3:KV3 要到 30 μs 才到,A1 和 A2 都得等到那时才能开始,计算单元从 10 到 30 μs 空等。整图在 60 μs 结束。
下排取 A2 先于 A1。如果反过来,整图要到 70 μs,所以图中取的是这种收法下较短的排法。
模型要做的,就是在所有满足依赖的排法里,找出总时间最短的那个。下面把这个问题写成公式。三类要求依次是:有依赖的必须先后、同一 Stream 的不能重叠、整图结束不早于任何 Kernel。
要求一,依赖(公式 4)。 图中每条依赖边 都要满足:
是 的结束时间, 是 的开始时间。这条式子说: 不能在 结束之前开始。在上面的例子里,A2 依赖 Q3,就有 。
要求二,同一 Stream 不重叠(公式 3)。 对同一个 Stream 里的每一对 Kernel ,二选一:
这里需要让模型自己决定谁先。把两种取值分别代入:
| 第一条变成 | 第二条变成 | 结果 | |
|---|---|---|---|
| 1 | , 很大,不起限制 | 先于 | |
| 0 | ,不起限制 | 先于 |
比 大,所以乘上 的那一项会让对应的不等式松到永远成立。这样两条约束里总有一条被”放松”,另一条真正生效,生效的是哪条,由 决定。
要求三,结束时间(公式 5)。 对每个 Kernel :
整图的完成时间不能早于任何一个 Kernel 的结束时间。注意这条式子只给出下界: 取多大都满足它。真正把 压到最晚结束的 Kernel 上的,是下面的目标。
目标(公式 6)。
最小化整图的完成时间,也就是所有任务从开始到全部结束的总时长。优化的是整张图,不是某一个 Kernel 的耗时。
回到上面的例子。把两种接收顺序对应的开始时间列出来:
| 接收顺序 | ||||||||
|---|---|---|---|---|---|---|---|---|
| 先收 KV3 | 0 | 10 | 0 | 0 | 10 | 30 | 40 | 50 |
| 先收 Q3 | 1 | 0 | 20 | 0 | 40 | 30 | 40 | 60 |
两行都满足全部约束,目标 选出第一行。
最后说清边界。依赖和 Stream 分组是规则给定的, 来自测量,所以”最优”是相对这个模型而言的。模型之外的硬件因素没有被精确建模,论文也没有声称模型最优等于在任何运行条件下最优。
7.4 求解之后得到什么,运行时还差什么
求解器给出每个 Kernel 的开始时间 。按 从小到大,就能读出每个 Stream 内的执行顺序,依赖图也就变成了一张 CUDA Stream Graph。论文把 Figure 5(c)(2) 作为这样一张最优 Stream Graph 的例子。
| 内容 | |
|---|---|
| 输入 | 合并后的依赖图、Stream 分组、各 Kernel 的 Profiling 耗时 |
| 输出 | 每个 Kernel 的开始时间 ,以及整图完成时间 |
| 谁调用它 | 6.5 的贪心,每试一个变换,就用它评估整图耗时 |
最后一行是两章的连接点。第六章决定粒度,要靠本章给出整图耗时,才能判断一个变换该保留还是退回。论文把这两部分分开讲,实际上两者互相依赖。
这套方法有一个前提: 是模型算出来的预测值,准不准取决于 的测量。预测与实测相差多少,放到第九章再看。
8. Implementation:Context Remap 如何把抽象分配落到数据布局
第四章有一个前提:第 个 Chunk 初始放在 GPU 。这个布局是 ILP 的输入,不是输出。ILP 只决定 Block 归谁算,不动数据最初放在哪。Context Remap 要动的就是这个初始布局。
论文用一个映射 来描述它:
- :一条序列里按原顺序排列的 个 Token。
- :Context Parallel 的 rank 集合,也就是各张卡的编号。
- :第 个 Token 被分到哪个 rank。所有可行的 组成集合 。
默认做法是均匀、顺序地切,即 。其中 是向下取整。 可以拆成 : 是每张卡分到的 Token 数,所以这个商就是“第 个 Token 排在第几段”,取整后得到卡号。
这只是 里的一种,还有其他分法。
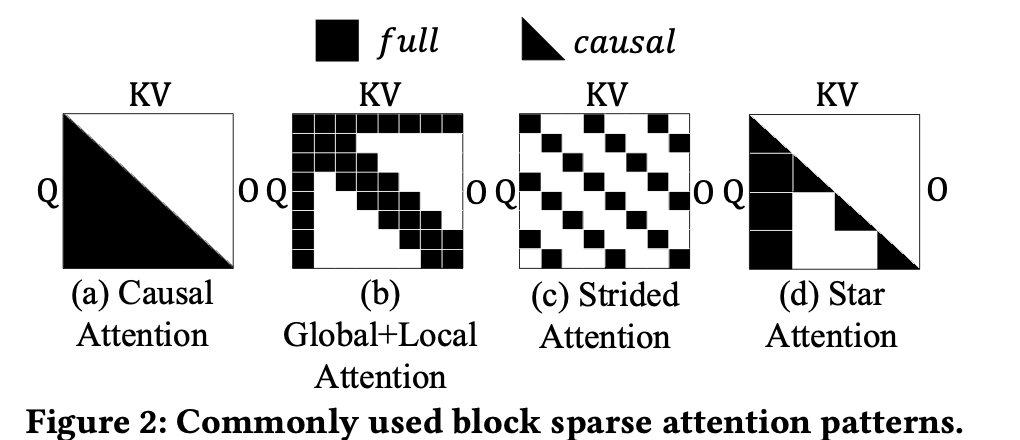
先说 Strided Attention 是什么。它是论文 Figure 2(c) 里的一种块稀疏模式:Q 的每一行只看 KV 中间隔固定的几个块,其余跳过。
论文用 Strided Attention 说明重映射能带来什么。Figure 4(a) 里 Block 表是 16×16,也就是序列均分成 16 个 Chunk。节点层 CP=4,对应图中的 4 个节点,映射取 。 是 Token 所在的 Chunk 编号, 取这个编号除以 4 的余数。所以 Chunk 0、4、8、12 去节点 0,Chunk 1、5、9、13 去节点 1,其余类推。
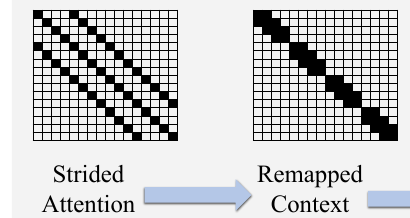
读图方式:每个矩阵是 16×16 的 Block 表,一格对应一个 Chunk 对 Chunk 的 Block,黑色格子是需要计算的 Block。左图的黑格沿几条斜线分散,右图的黑格聚拢在对角线附近。
对照前面 Figure 4 的裁图,有效 Block 在 Remap 之后聚拢到对角线附近。重映射后局部性更好,帮助节点层和设备层找到通信更少的切分。
这一步有三个边界。
- 第一,它只影响 Attention 模块。论文的理由是,大语言模型里 Token 之间的交互只发生在 Attention 里,其他模块对每个 Token 的计算是均匀且独立的。
- 第二,论文把它当作离线预处理,由人工提前指定,并且只用于部分 Attention 模式。
- 第三,它是可选步骤,不影响 UltraAttn 的通用性。
不自动搜索 ,论文给了两个难点:重映射与分层 Context-Tiling 的联合搜索空间太大;拆开优化的话,单独给 Context Remap 定义一个有效的目标又不容易。论文把这留作值得探索的方向。
实现上,UltraAttn 是超过 10k 行的 Python程序,基于 PyTorch。通信用 NCCL 2.21,计算用 FlashAttn 2.5.7,ILP 用 Gurobi 求解。运行时还用了 CUDA Graph 来消除分布式 Attention 里的 CPU 开销,论文强调这对短上下文尤其重要。
到这里设计部分结束。下一章看这些设计组合起来是否有效。
9. 实验评测:收益、归因、扩展性与代价
前八章讲完设计,本章看它有没有用。论文 Section 6 有六张图和两张表,本章全部放进来,每张只回答一个问题。
9.1 实验设置与读图规则
| 项目 | 论文设置 |
|---|---|
| 集群 | 8 个节点共 64 张 H100-NVLink-80GB,每卡 NVLink 双向 450GB/s |
| 网络 | 每节点 8 个 400Gb/s Infiniband 网卡,每张 GPU 与一个网卡亲和 |
| 模型 | Llama2-7B,batch size 为 1,部分实验取头数 |
| Attention 模式 | Dense:Full、Causal。块稀疏:Strided、Global+Local(训练),Star、Streaming(推理) |
| 推理 | 只测 Prefill,不含 Decode |
是attention 的头数。
基线是什么。 基线是论文拿来对比的三种已有的上下文并行方法:Ring Attention、Stripe Attention 和 Zigzag Ring Attention。论文在 2.1 节把它们归为一类,都沿 Q 的方向切分。
9.2 收益有多大
先看整体。下表只收论文正文给出的平均加速比。
| 场景 | 对比对象 | 平均加速( / ) | 出处 |
|---|---|---|---|
| 端到端(512K,训练 64 卡,推理 8 卡) | Ring、Stripe、Zigzag 中最好的 | 2.2× / 3.4× | Figure 6 |
| Strided 训练 | Ring | 10.2× / 9.4× | Figure 7 |
| Global+Local 训练 | Ring | 7.6× / 5.7× | Figure 7 |
| Full 训练 | Ring、Stripe、Zigzag 中最好的 | 3.6× / 2.5× | Figure 8 |
| Causal 训练 | Ring、Stripe、Zigzag 中最好的 | 2.6× / 2.6× | Figure 8 |
| Star 推理 | Ring | 仅 :2.1× | Figure 9 |
| Streaming 推理 | Ring | 仅 :1.9× | Figure 9 |
端到端。 Figure 6 是用 Llama2-7B 测的整模型结果,既有训练,也有推理,横轴六种模式分成两组:
| 横轴的模式 | 场景 | GPU 数(CP) | 序列长度 |
|---|---|---|---|
| Strided、Global+Local、Full、Causal | 训练 | 64 | 512K |
| Star、Streaming | 推理,只测 Prefill 阶段 | 8 | 512K |
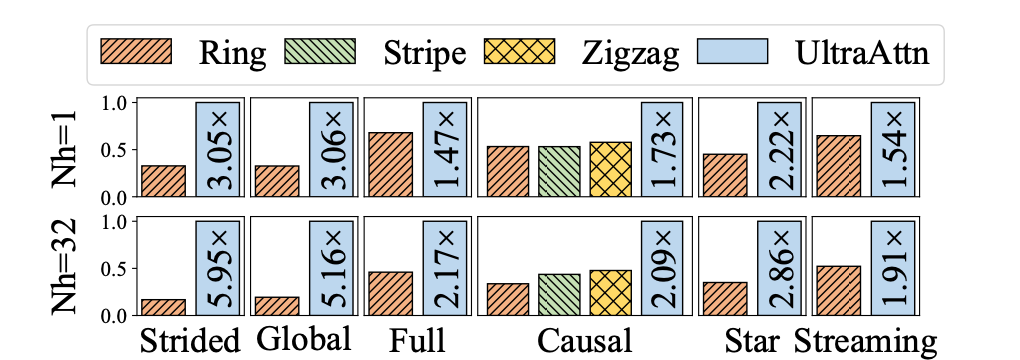
端到端也能快,论文的解释是:序列超过 128K 之后,分布式 Attention 逐渐成为训练和推理的性能热点,所以加速它就能传到整体。
稀疏模式的收益明显高于 Dense,下面三张图解释原因。
块稀疏训练。 Figure 7 比较 Ring 和 UltraAttn,中间三根柱是消融。上下两大块是前向和反向,每块上排 Strided,下排 Global+Local。每个小子图是一组配置,标着 CP、序列长度 S 和头数 。
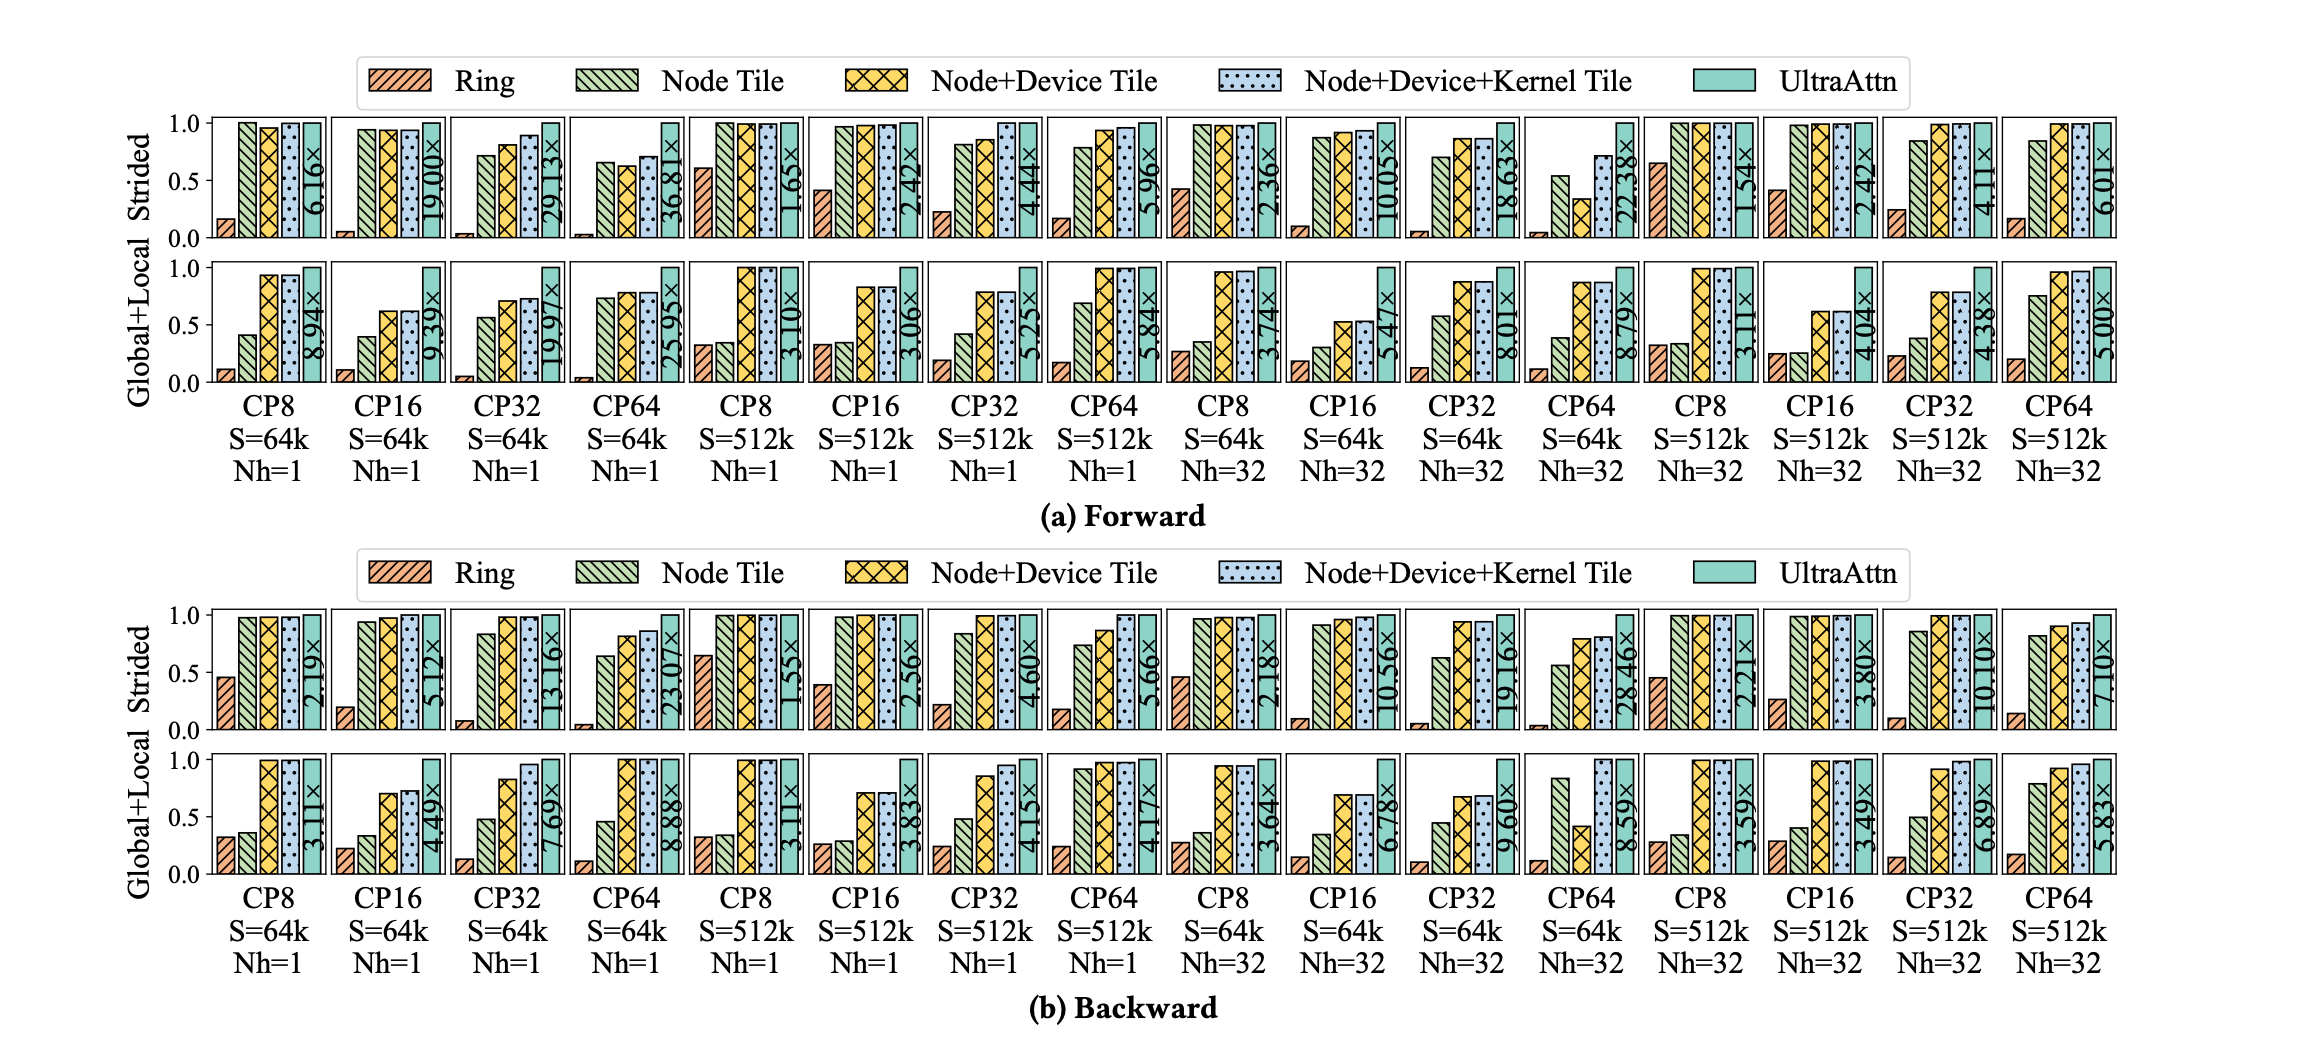
读两组前向 Strided、 的数字就能看出趋势。S=64k 时,CP 从 8 到 64,加速依次是 6.16×、19.00×、29.13×、36.81×。S=512k 时是 1.65×、2.42×、4.44×、5.96×。同一个 S 下,CP 越大,加速越大。同一个 CP 下,S 越短,加速越大。最大和最小的配置差了一个数量级。
为什么 S 短时加速更大?论文没有单独解释,下面是本文的推断。Attention 的计算量大致随 S 的平方增长,要传的 Q、K、V 只随 S 线性增长。S 缩短后,计算量比通信量降得更快,配置更偏向通信受限,而 UltraAttn 主要削减的正是通信。稀疏模式跳过了部分计算,这个倾向更明显。
Dense 训练。 Figure 8 的 Full 和 Causal 没有稀疏性,基线多了 Stripe 和 Zigzag。
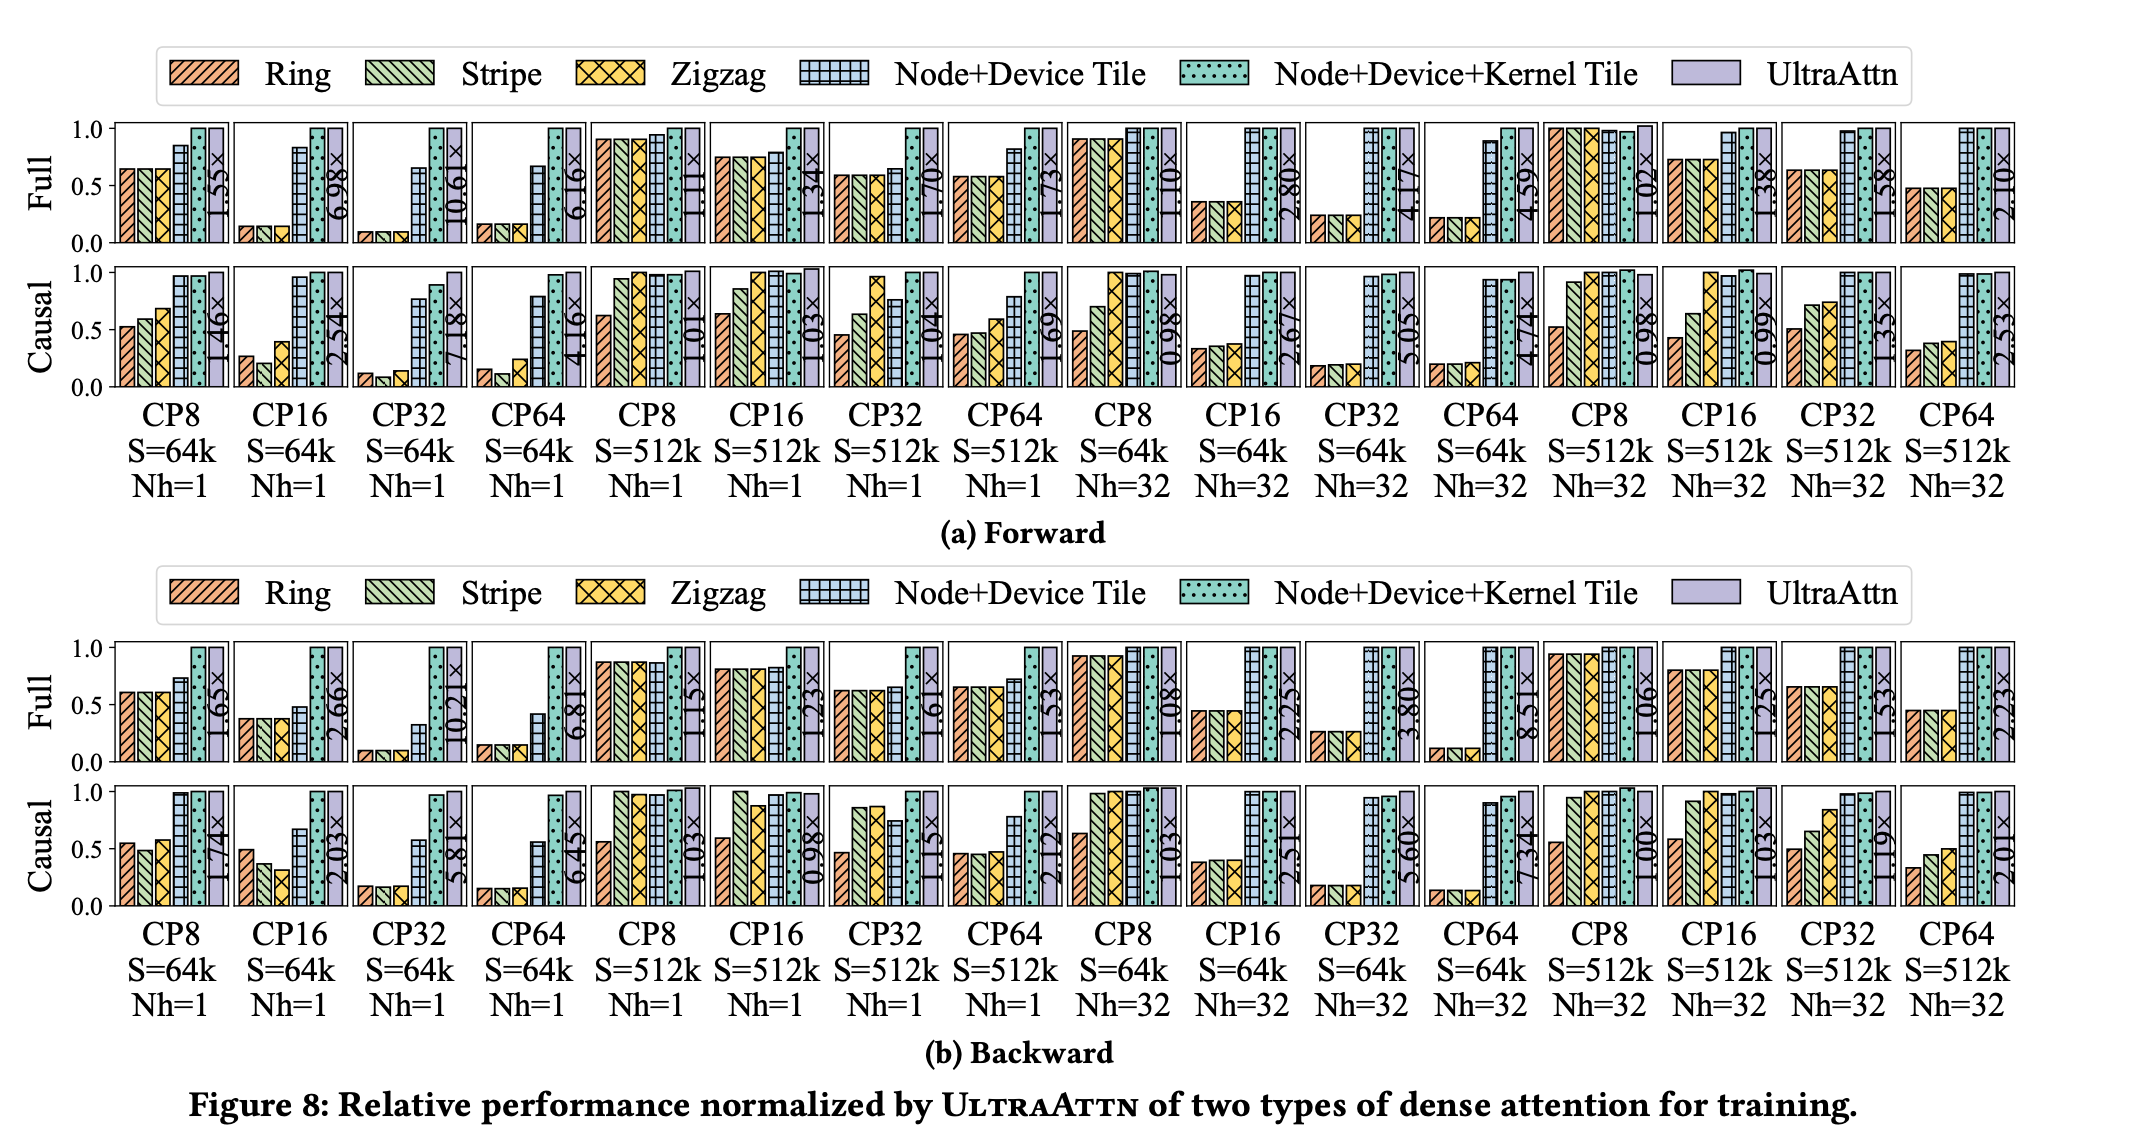
Dense 的收益波动也大。读图所得,前向 Full 在 S=64k、 时,CP 从 8 到 64 依次是 1.55×、6.98×、10.61×、6.16×,并不随 CP 单调增加。Causal 在 S=512k、 的前几个配置里,柱顶只有 1.01× 到 1.04× 左右,几乎没有收益。
块稀疏推理。 Figure 9 只有 Ring 一个基线,CP 为 2、4、8,都在一个节点内。
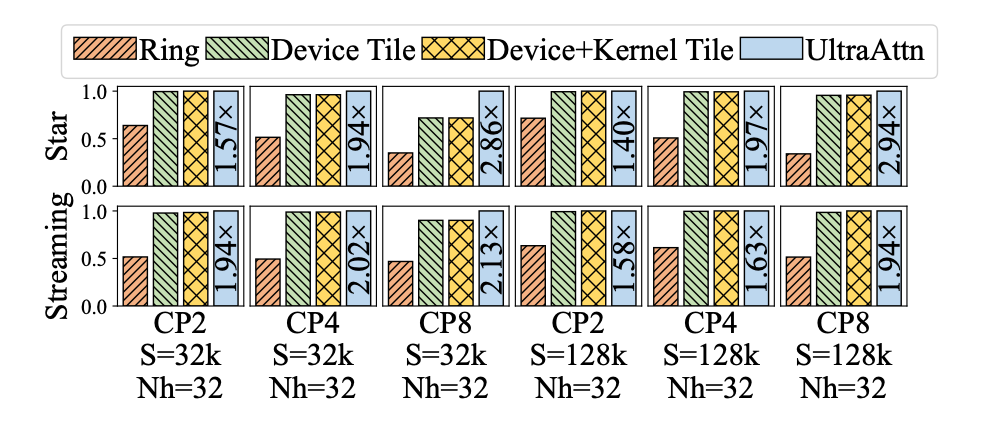
读图所得,Star 在 S=32k 时是 1.57×、1.94×、2.86×,S=128k 时是 1.40×、1.97×、2.94×。Streaming 六项在 1.58× 到 2.13× 之间。Star 和 Streaming 的六项均值约 2.11 和 1.87,与论文的 2.1× 和 1.9× 一致。
为什么稀疏收益大。 论文给了两个原因。
第一个是计算负载均衡。以 Figure 2(d) 的 Star 为例,CP=8 时最后一个 rank 要算 0.875 个块,平均每个 rank 只要 0.625 个,多出 0.875/0.625−1=40% 的负载不均衡开销。Ring 还有一个更细的问题:每一步只有部分 rank 在算注意力块,其余的在等,这在论文里叫 step 内负载不均,它进一步拉低 GPU 利用率。
第二个是通信量下降。在 Ring 里,固定上下文长度后增大 CP,每张卡的计算量成比例减少,通信量却不变,逐渐变成通信受限,所以降低通信量收益大。这也解释了为什么加速随 CP 增大而增大。
Dense 的原因多一个 Kernel 层的作用。固定 S 和 ,CP 增大会让每张卡上的注意力块变小、设备利用率下降。Kernel-Level 自适应地把小块融合起来, 时受益更多。
9.3 收益来自哪一层
Figure 7 到 9 的中间几根柱是消融:从基线出发,每次多加一层优化,直到 UltraAttn。论文 6.4 节把四层的作用总结如下。
| 层 | 在哪类场景起作用 | 论文给的原因 |
|---|---|---|
| Node-Level | CP>8,也就是需要跨节点时,常有明显加速 | 跨节点通信在关键路径上占主导,降低它收益大 |
| Device-Level | 块稀疏尤其重要;CP 限制在单节点内时收益大 | 打破 Ring 逐步执行的结构,均衡计算,并允许更灵活的通信模式 |
| Kernel-Level | Dense 场景收益最大,块稀疏也有收益 | 较稠密的分布给融合小 Kernel 更多机会;S/CP 和 越小,收益越大 |
| ILP 调度 | 多数场景与 FlexFlow 的调度持平或更好 | 在依赖复杂、计算与通信耗时相当的场景里,调度空间更大,差距更明显 |
消融是累加式的,后加的层建立在前面几层之上,所以相邻两根柱的差不能当作那一层的独立贡献。这一点是本文的说明,论文没有这样提示。
9.4 扩展性与代价
强扩展性。 Figure 10 固定模型配置,只改 CP,所以总计算量不变。训练固定 S=512K,推理固定 。纵轴是相对 MFU,也就是模型 FLOPs 的利用率,不是绝对值。
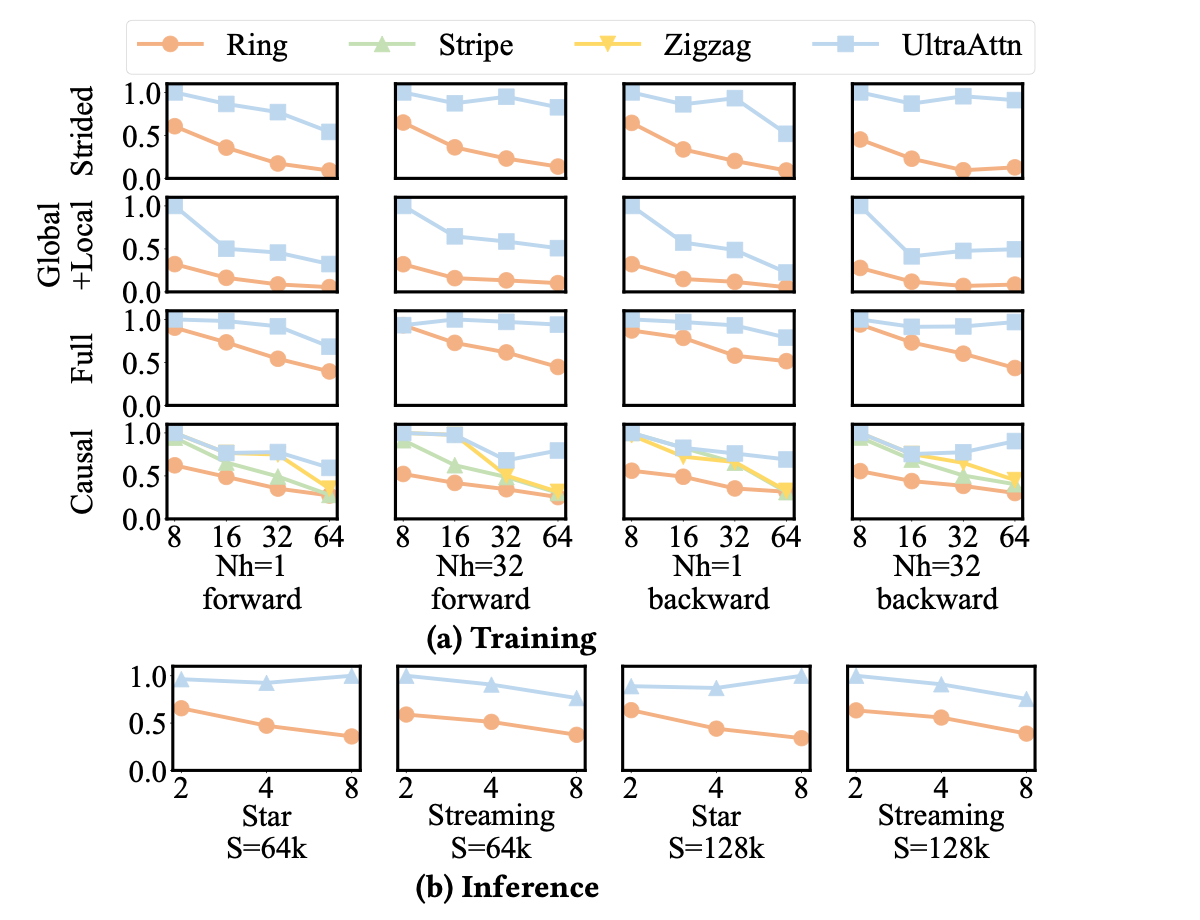
读图所得,Ring 的曲线随 CP 增大明显下降,UltraAttn 的曲线下降缓得多。论文的结论是 UltraAttn 的强扩展性始终优于基线,多数场景接近线性扩展。这张图只能看趋势,读不出具体的 MFU 数值。
预测准确度。 前面各层都在“预测的执行时间”上搜索,所以预测准不准决定搜出来的策略可不可信。第七章的 就是这样的预测值。
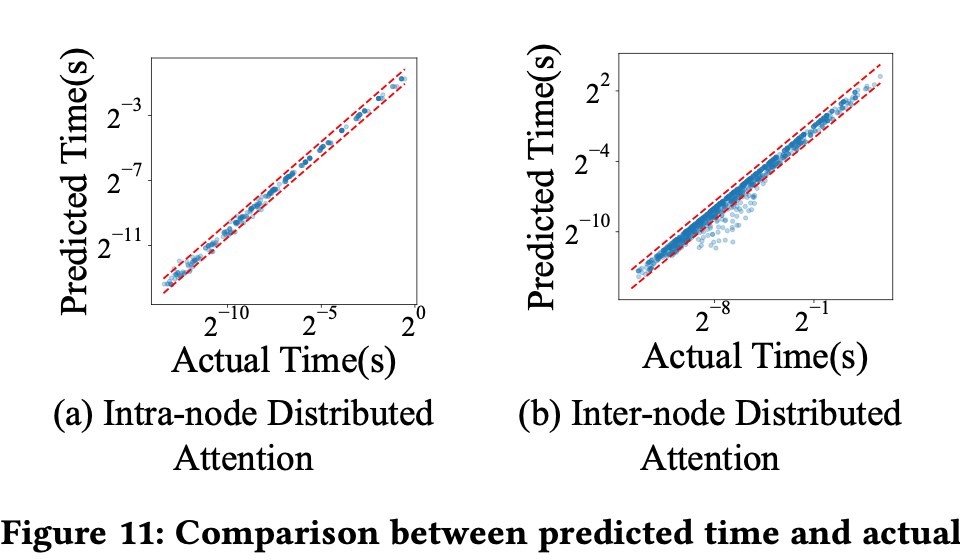
读图方式:横轴是实测时间,纵轴是预测时间,都取对数,点越靠近对角线越准,红色虚线是相对误差的边界。论文给出的数字如下。
| 节点内 | 跨节点 | |
|---|---|---|
| 误差超过阈值的案例占比 | 约 3.0% 超过 30% | 约 5.8% 超过 50% |
| 0.9932 | 0.9181 |
搜索时间。 两个 ILP 的求解时间在 Table 4 和 Table 5,单位毫秒,格里的 P 是 Partition Degree。
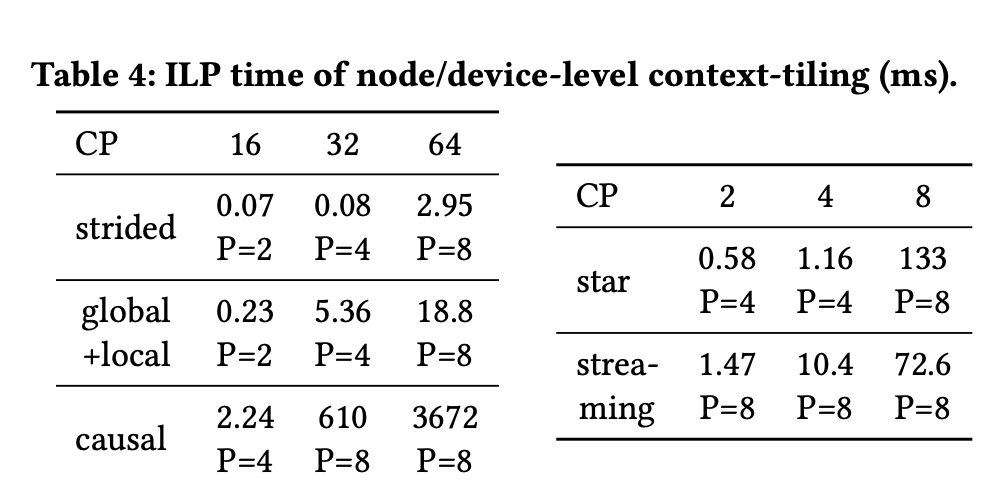
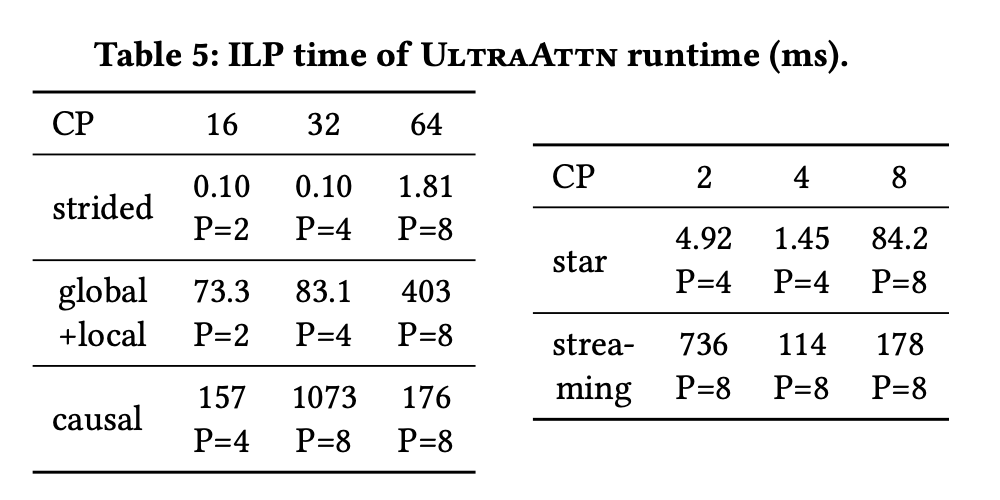
论文的结论是:Table 4 的时间随图案变密、CP 和 P 变大而增长,因为搜索空间变大。Table 5 的时间随图案变密和 变大而增长,因为这个量对应每个 GPU Stream 上平均的 Kernel 个数。Table 5 固定 S=128k 和 ,因为论文认为 ILP 时间对这两个参数不敏感。
读三个数感受量级:Causal 在 CP=64、P=8 时,Table 4 是 3672 ms,约 3.7 秒,同配置的 Strided 只有 2.95 ms。Table 5 里,同一配置的 Strided 是 1.81 ms。
Table 5 不是单调的。例如 Causal 在 CP=32、P=8 是 1073 ms,到 CP=64、P=8 反而是 176 ms。Streaming 在 CP=2 是 736 ms,高于 CP=4 的 114 ms。论文只给了总趋势,没有解释这些点,本文也不替它猜原因。