第10讲:原力灵机赛题方向解析学习笔记
发布于
来源:《第十讲 原力灵机赛题方向解析》,视频约 20 分 49 秒。核心内容是 HandPose 手部操作数据如何结构化、质量评估、向量化入库,并通过检索反哺下一轮数据采集。
1. 赛题场景:让采集数据形成闭环
原力灵机的方向面向机器人数据采集。视频介绍的 HandPose 方法,是把手部操作视频转成结构化感知结果;向量数据库则把历史采集经验变成可检索资产。
传统采集方式通常是:拍视频 → 存文件 → 继续采集。这种方式容易出现重复采集、质量不稳定、缺口只能凭感觉判断等问题。本讲提出的闭环是:
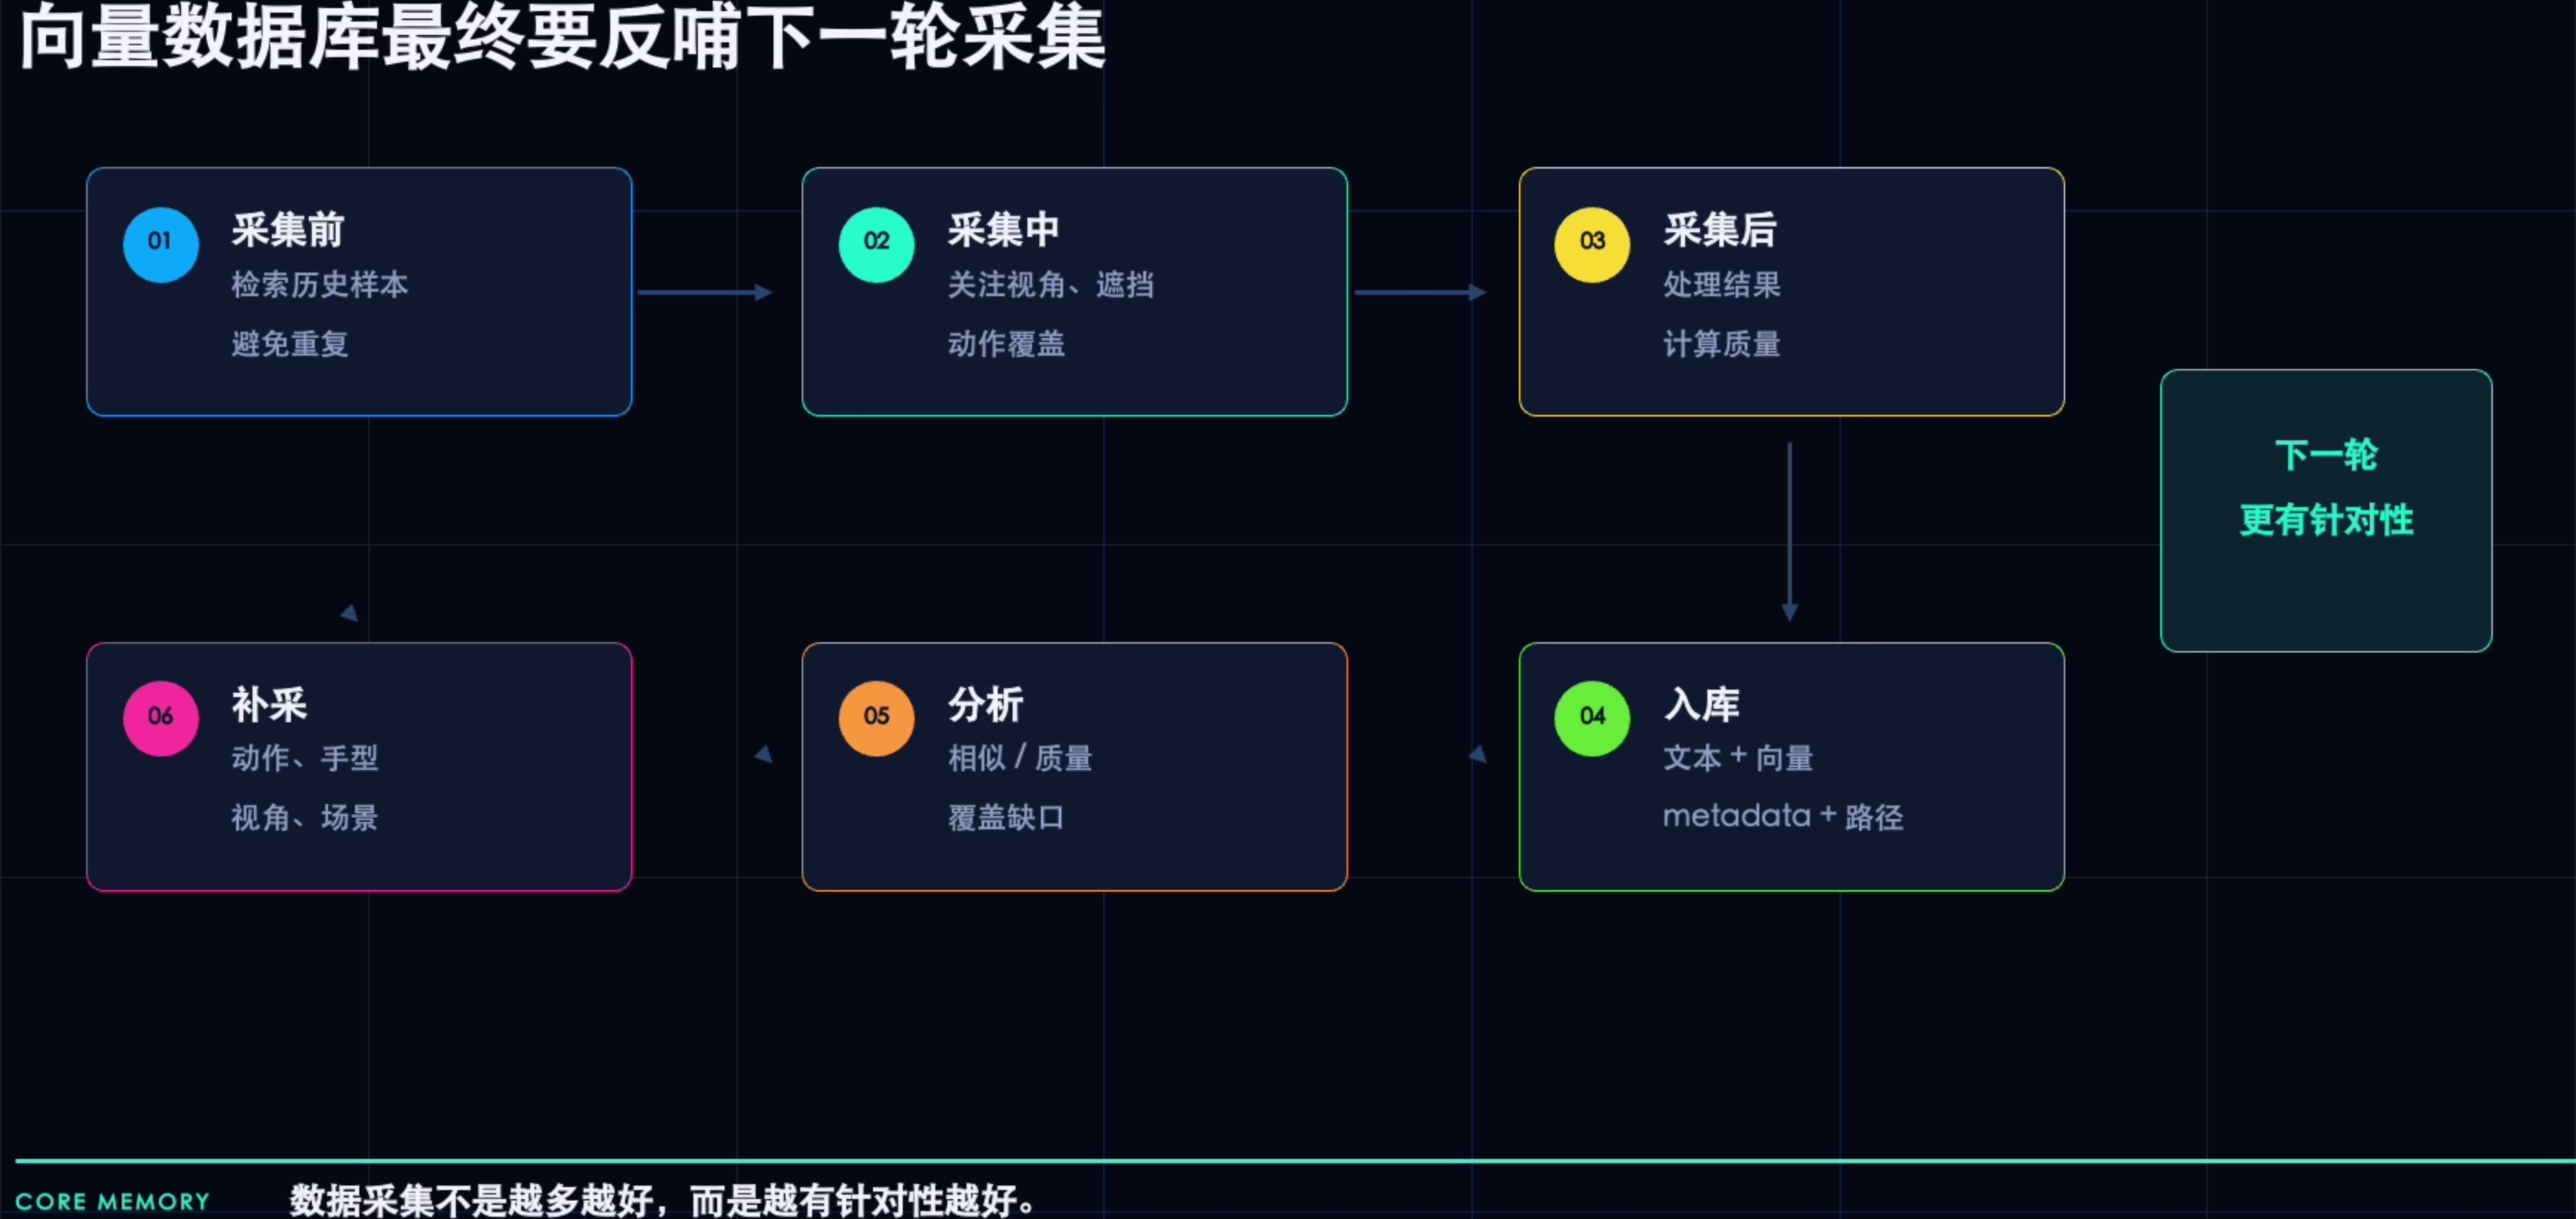
采集 → 结构化 → 质量分析 → 经验入库 → 检索分析 → 补采优化 → 下一轮采集。
历史数据参与下一轮决策,主要从四个维度反馈:重复度、质量度、覆盖度和异常度。向量数据库在这里不是单纯存文件,而是帮助判断“已经采集了什么、哪里质量不足、还缺什么、下一轮应该怎么采”。
视频前半段还介绍了原力灵机的模型、后训练框架、开发者平台和机器人操作系统等产品。这些是赛题背景,真正与题目直接相关的是 HandPose 数据处理、质量评估和向量化检索流程。
2. HandPose 数据:从文件证据到经验样本
在平台上传手部操作视频并完成处理后,会得到多个 JSON 文件。课件按职责将它们分成四类:
| 文件 | 主要内容 | 用来回答的问题 |
|---|---|---|
MANO | 手部关键点、手型、手腕变化等 | 手是怎样运动的? |
BODYPOSE | 姿态有效性和异常标记 | 动作是否稳定? |
SLAM | 相机位置、旋转和跟踪状态 | 空间和视角是否稳定? |
LABEL | 帧数、视频信息、样本元信息 | 这条数据是什么? |
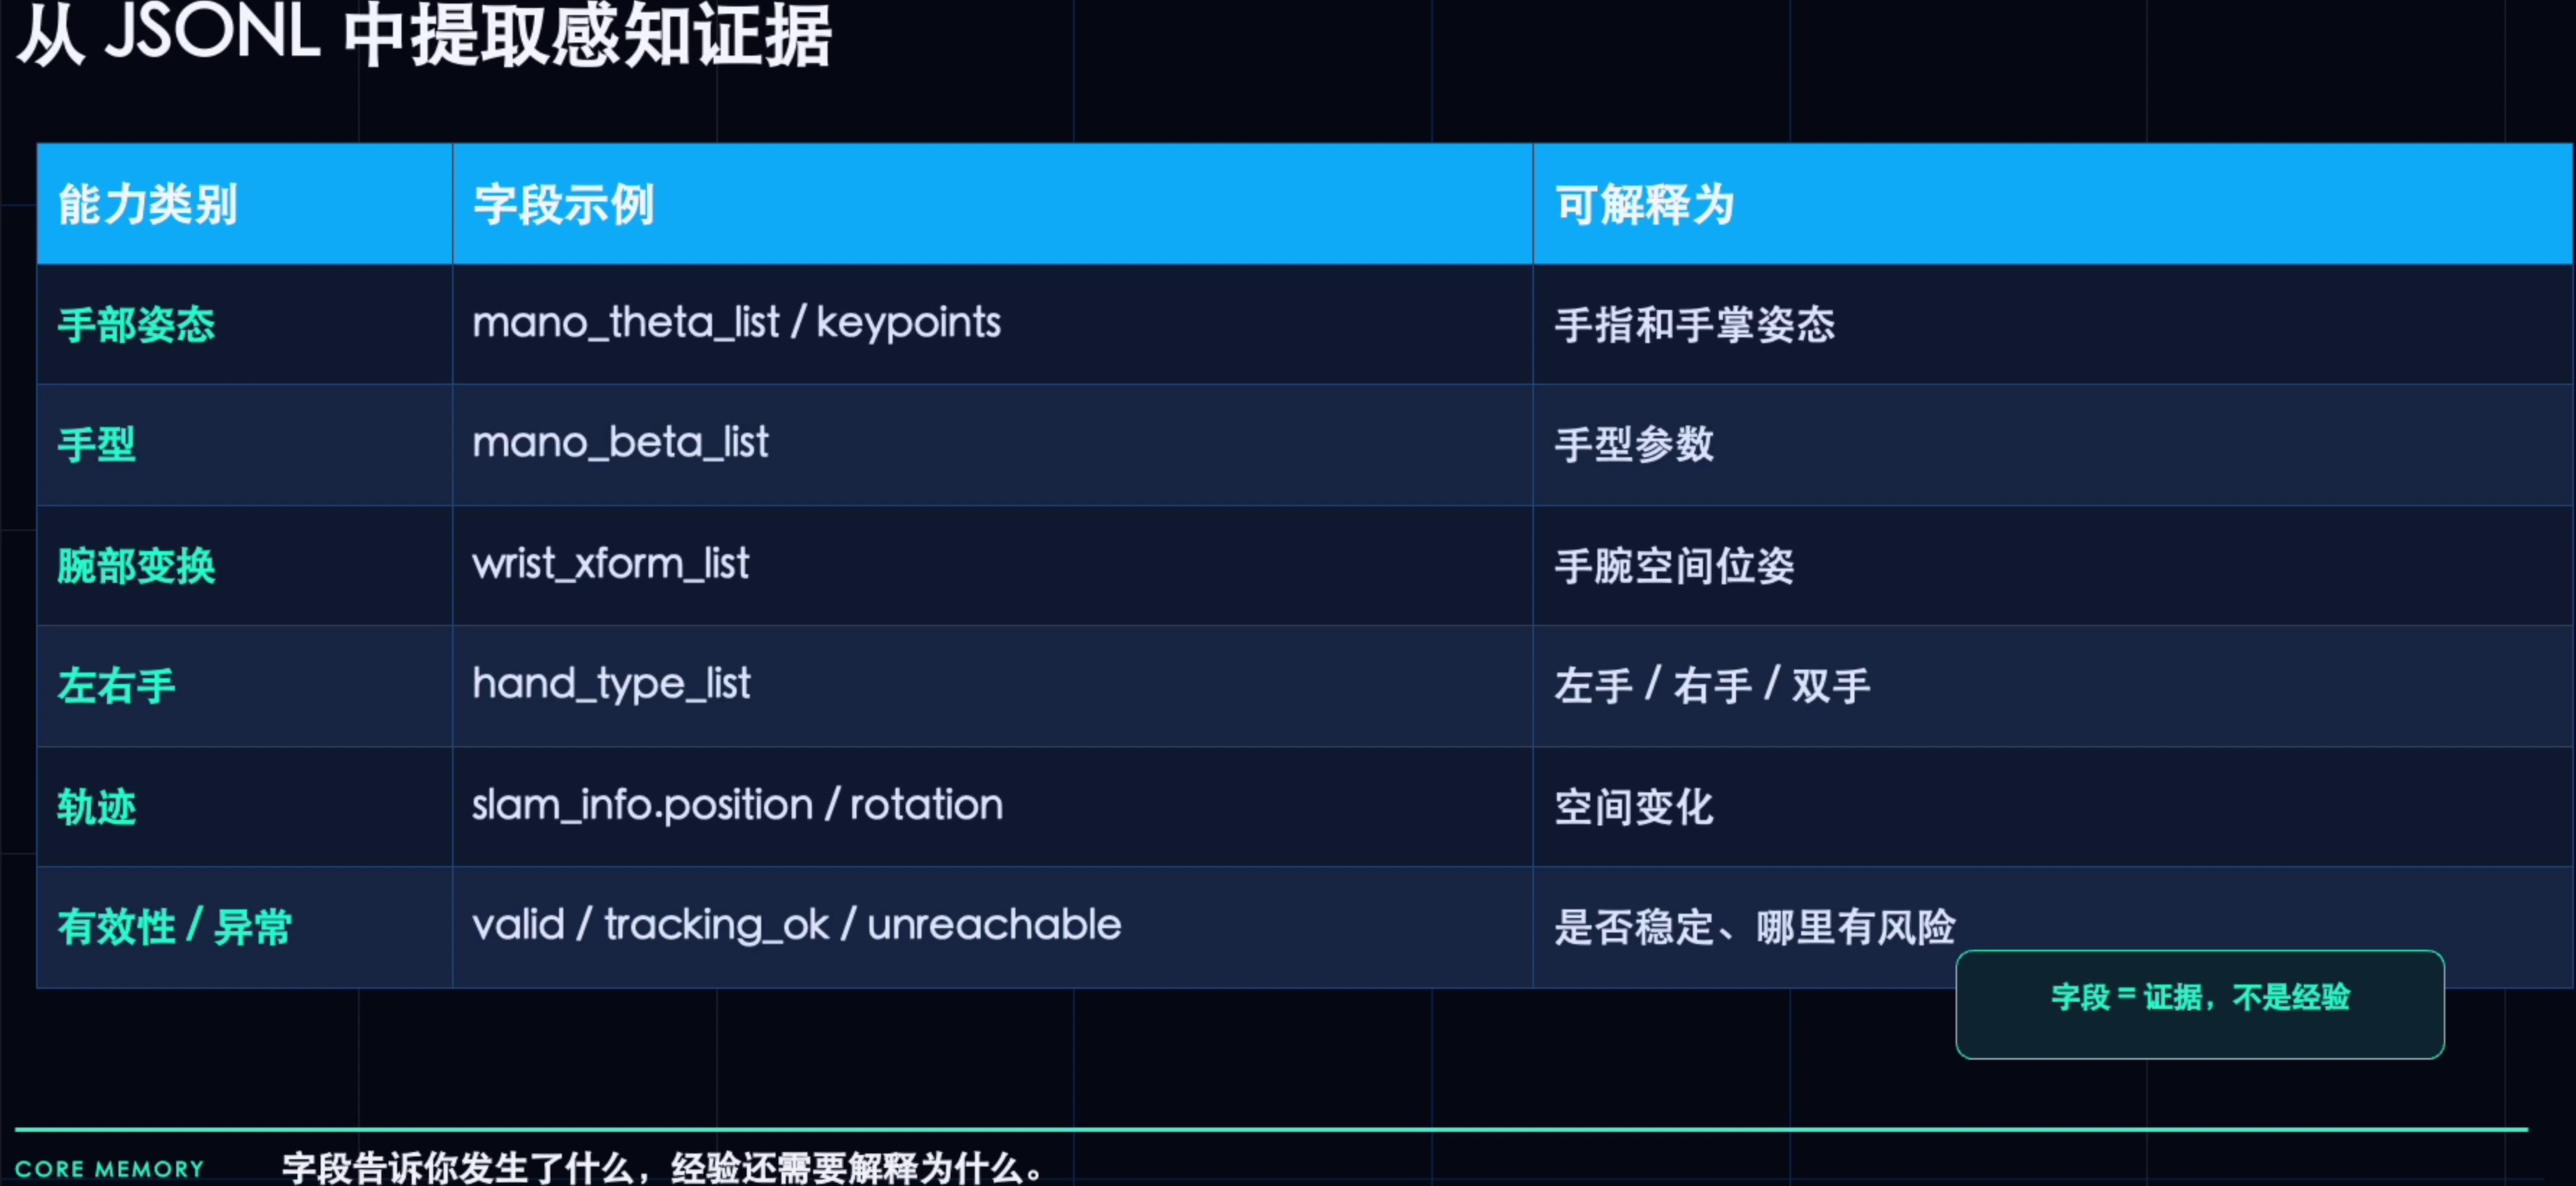
这些 JSON 字段首先是证据,还不是完整的采集经验。要形成可检索的经验样本,还需要补充任务名称、场景中的物体、动作目的、任务是否成功,以及下一轮补采建议。一个完整经验样本应把感知数据、任务语义、质量判断和原始数据引用组合起来。
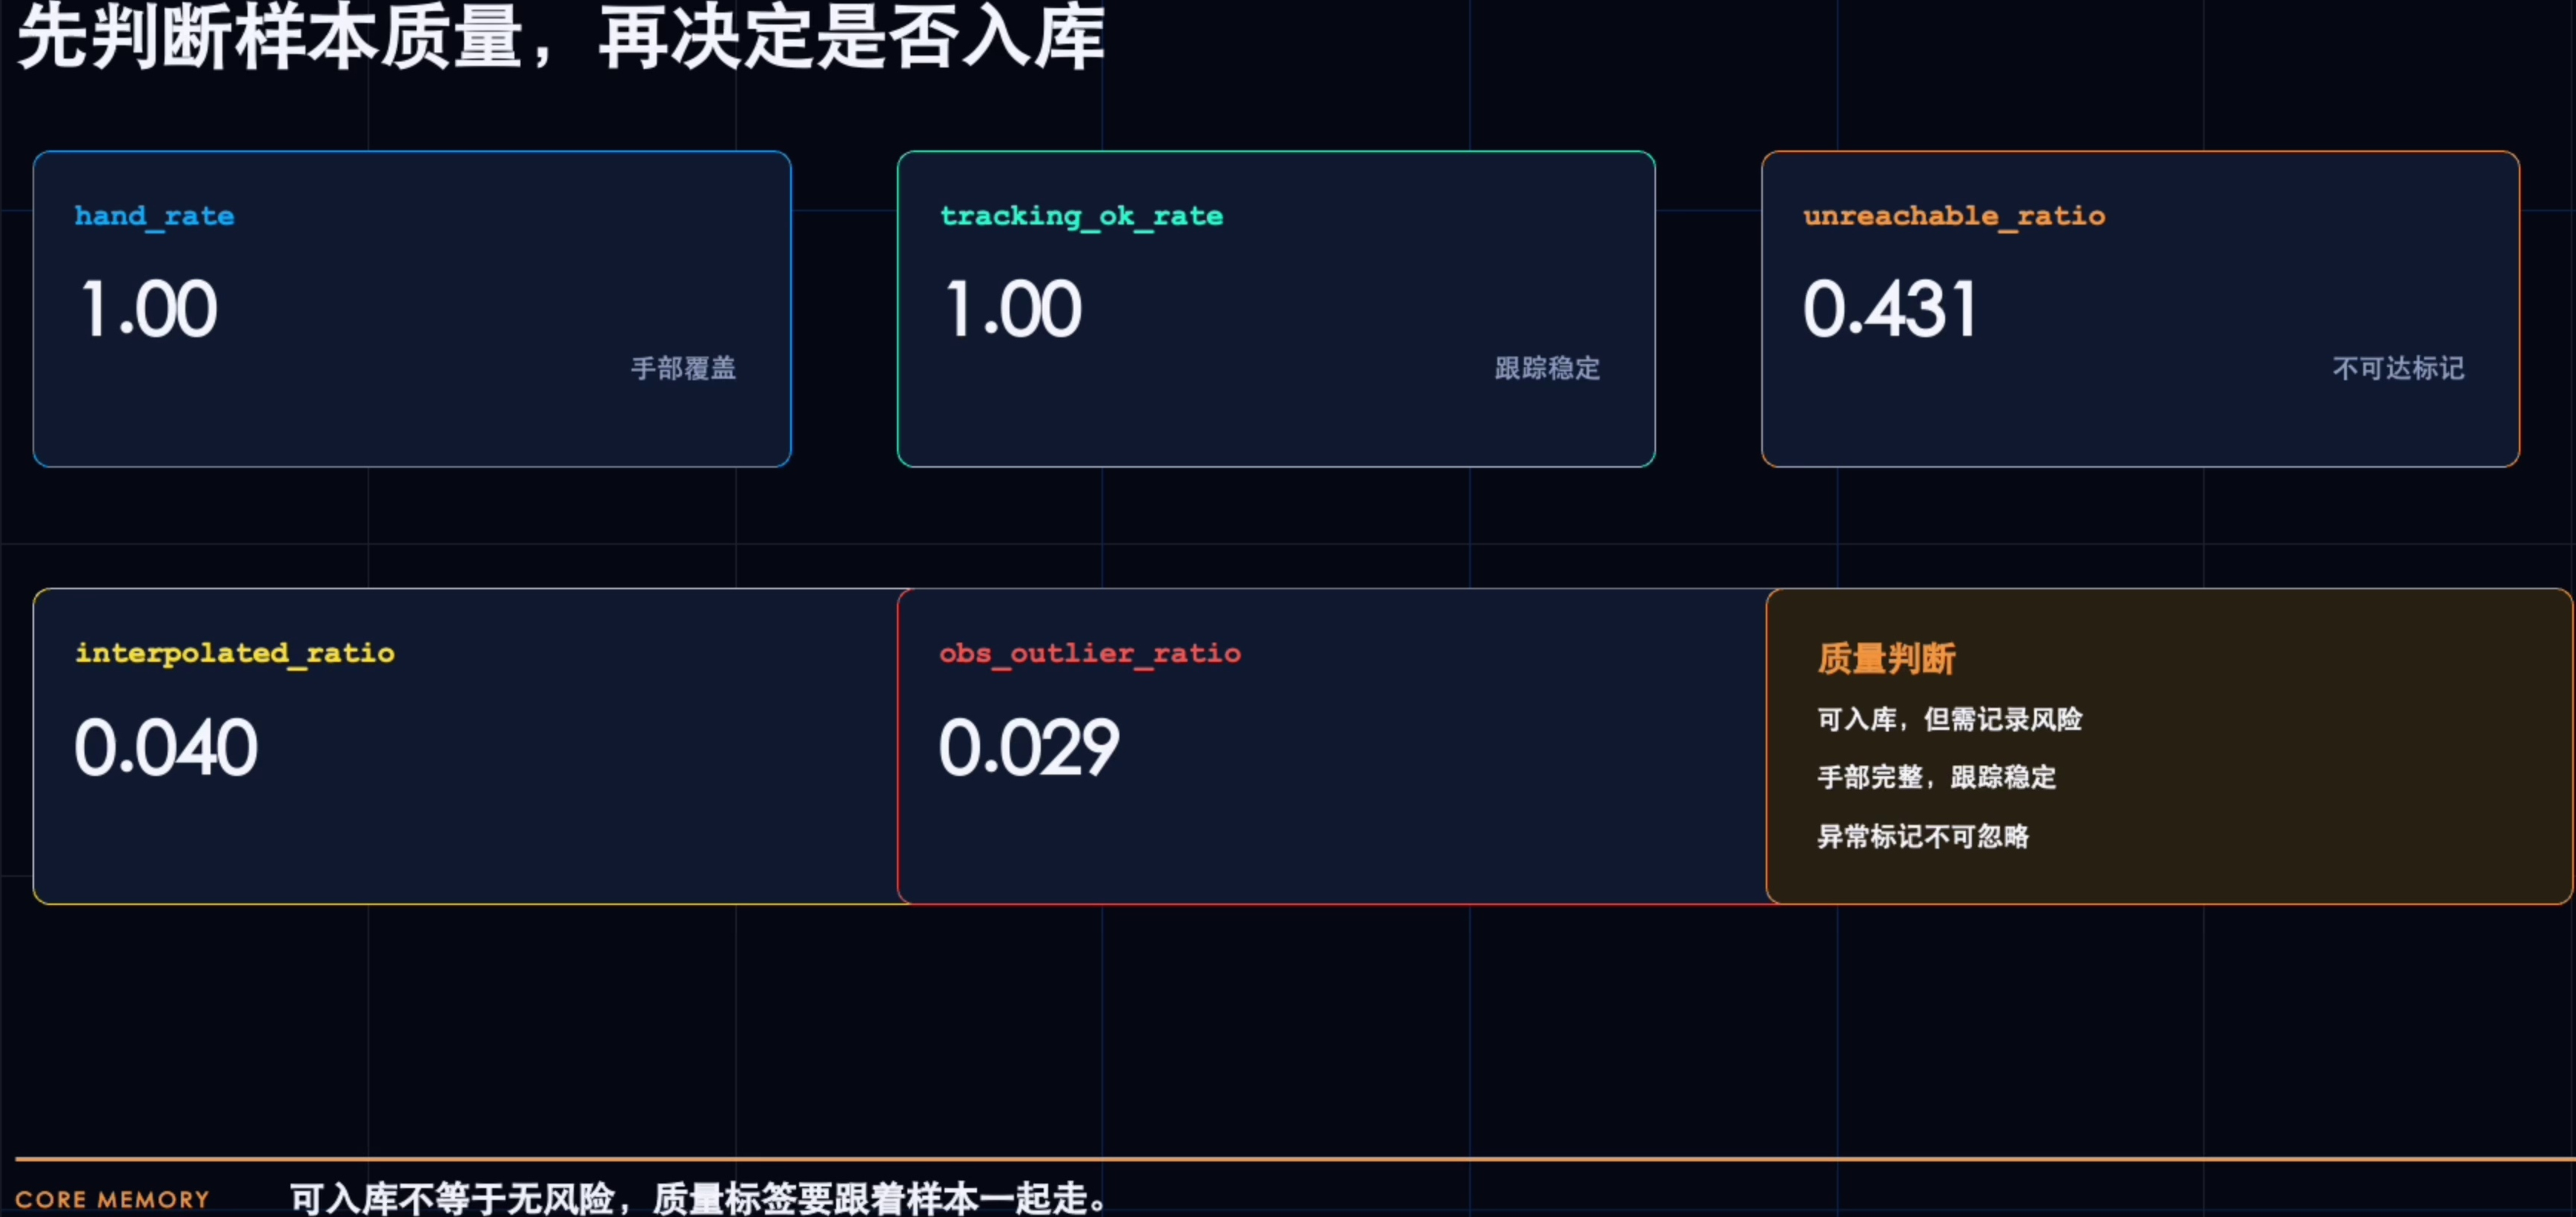
质量不能只靠人工感觉,需要落到指标上。视频举到的指标包括:
hand_rate:检测到手的帧数 ÷ 总帧数,越高越好;track_ok_rate:跟踪正常的帧数 ÷ 总帧数,越高越好;- 不可达标记比例、丢帧/差值比例、观测异常比例,通常越低越好。
可入库不等于没有风险。质量中等的样本可以入库,但必须贴上相应质量标签,供后续检索和筛选使用。
3. 向量化、检索与补采建议
原始 JSON 对开发者友好,但不容易直接检索和解释。因此需要整理成一张“经验样本卡”,至少包含:
- 样本编号、任务、场景、动作、手型等描述;
- 质量指标、异常和风险;
- 对下一轮采集的建议;
- 向量、文本、metadata 和原始文件路径。
向量化可以分两个层次:基础层是经验文本向量,记录任务、场景、动作和质量;进阶层是动作特征向量,记录手型、轨迹长度、运动幅度、持续帧数和质量指标。前者适合经验语义检索,后者更适合对动作进行比较和计算。
视频总结了向量数据库在采集场景中的三个作用:
- 相似经验检索:查找类似任务、动作或场景的历史样本;
- 质量问题检索:查找同类异常是否反复出现;
- 覆盖缺口分析:判断左手/右手、视角、复杂桌面或其他场景是否覆盖不足。
一个异常分析例子是:先发现某个质量指标偏高,检索同类历史样本,再观察问题是否集中在某个视角、物体布局、光照或操作速度,最后判断是否属于共性采集问题,并给出调整相机角度、减少遮挡、降低桌面物体密度、调整操作速度等建议。
我对本讲的理解是:向量数据库保存的核心对象不是视频文件本身,而是“可解释的经验样本”。原始文件路径用于回看证据,文本和向量用于检索,metadata 用于过滤、分组和覆盖分析。
最终闭环可以按时间顺序记忆:
- 采集前:检索历史样本,减少重复,确定需要补足的视角和动作;
- 采集中:关注遮挡、视角、动作覆盖和场景条件;
- 采集后:运行 HandPose,计算质量指标并形成经验样本;
- 入库后:做相似检索、质量检索和缺口分析;
- 补采时:根据建议调整动作、手势、手型、视角和场景,再进入下一轮。