第8讲:Dify 赛题方向解析学习笔记
发布于
来源:《第八讲 Dify 赛题方向解析》,视频约 19 分 42 秒。主线是:如何用 Dify 把模型、知识、工具和业务流程组织成可运行的 AI 应用,并理解 OceanBase 在部署中的作用。
1. Dify:从模型调用到可运行的 AI 应用
现在的 AI 应用通常不只是调用一次大模型,还会涉及企业知识、外部工具、业务流程,以及上线后的监控和维护。视频将 Dify 定位为位于大模型和业务系统之间的应用开发与运行平台,负责把这些能力组织起来。
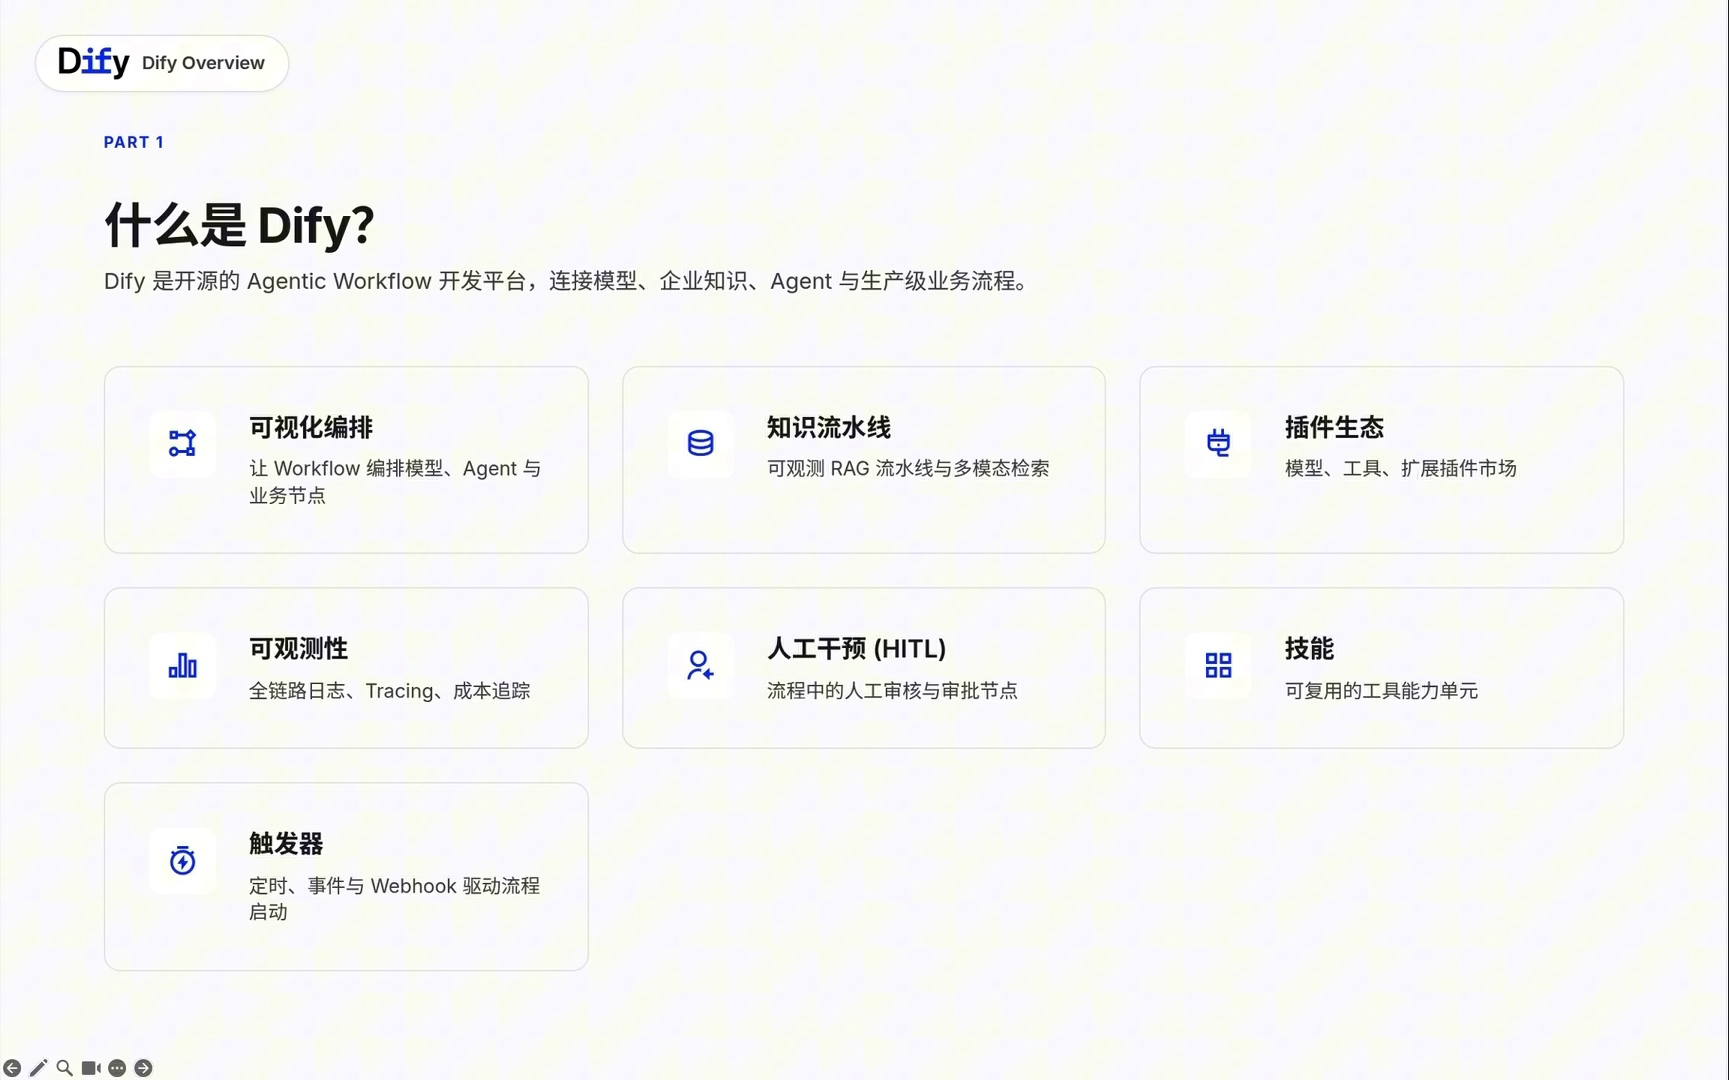
Dify 关注的不只是“能不能做出 Demo”,还包括:能不能可靠运行、能不能被团队复用、出了问题能不能定位。知识流水线负责把文档变成可检索内容;插件、Skills 和工具负责连接外部系统;Trigger 可以通过定时事件或 Webhook 自动启动流程;可观测性负责记录调用链、工具执行和成本;人工干预则用于高风险步骤的审批。
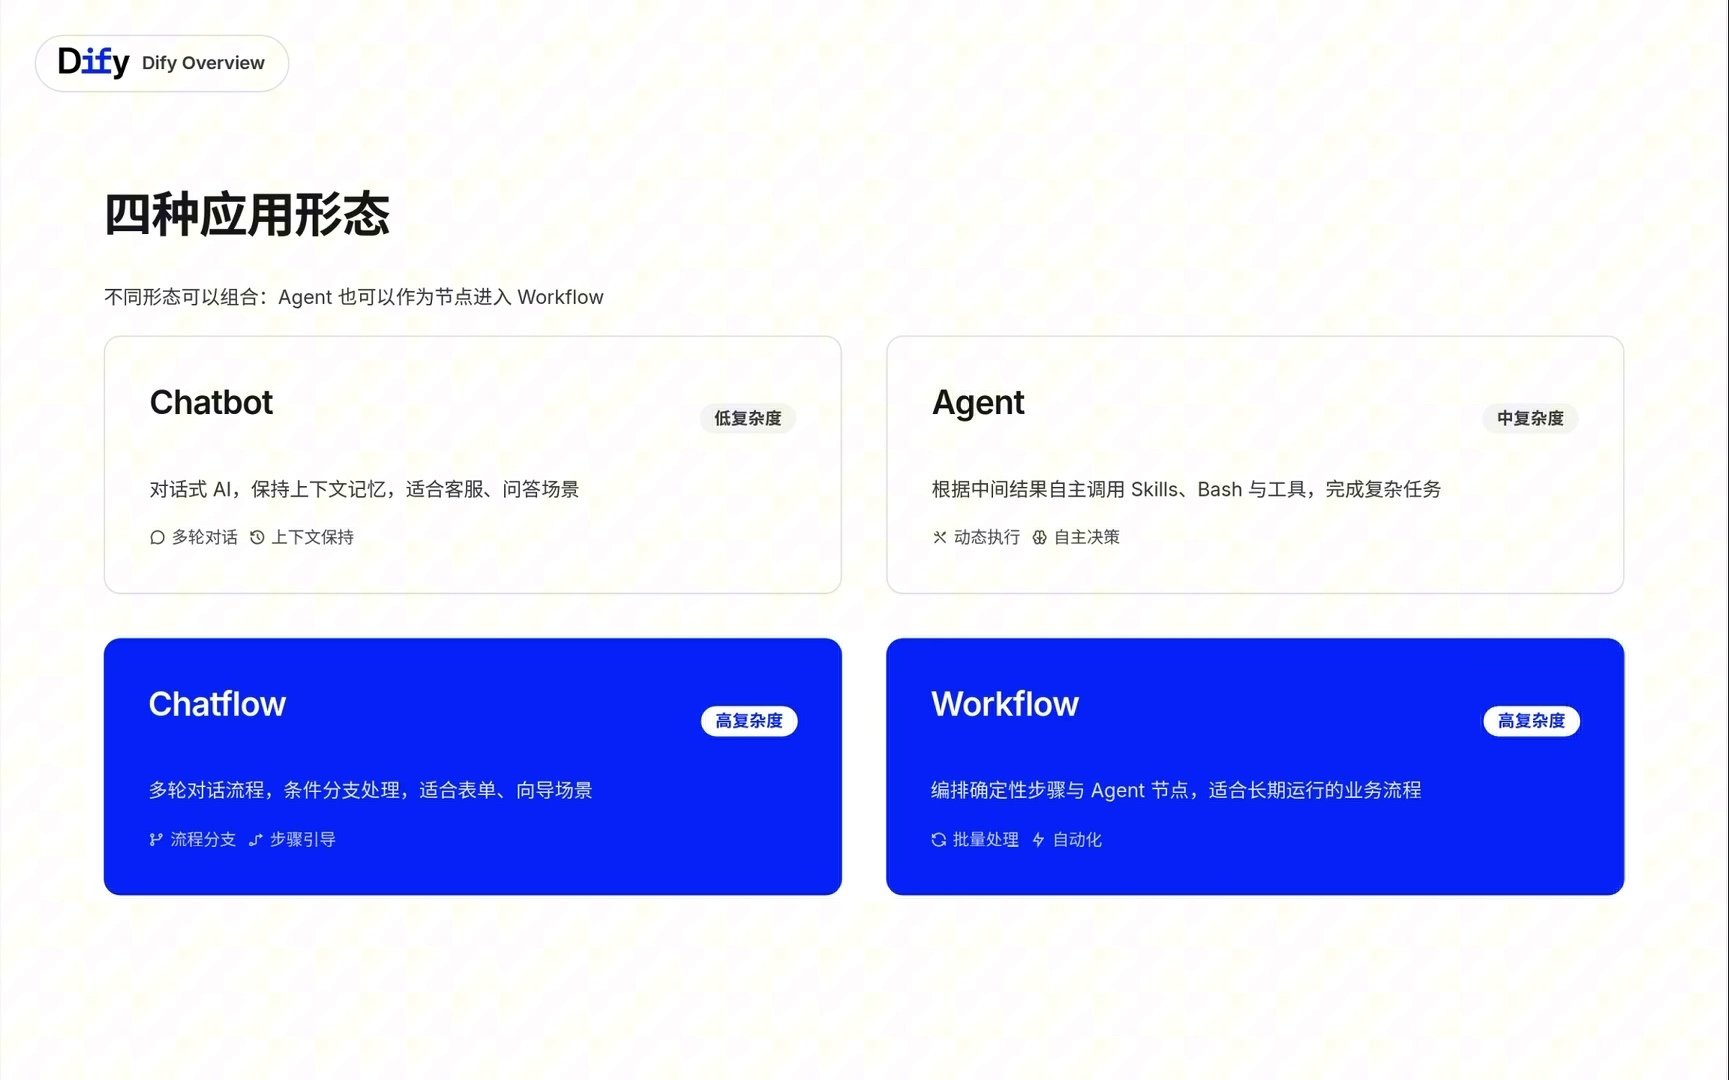
四种形态可以这样理解:
| 形态 | 适合场景 |
|---|---|
| Chatbot | 多轮问答和上下文对话。 |
| Chatflow | 对话中包含分支和固定步骤。 |
| Workflow | 输入、执行顺序和输出相对明确的完整流程。 |
| Agent | 根据中间结果动态决定下一步,适合步骤难以预先写死的复杂任务。 |
实际系统不是四选一。例如,Workflow 可以规定整体边界,再把某个复杂节点交给 Agent;Agent 也可以作为 Workflow 中的一个节点。可以用一句话概括:Agent 负责个体能力,Workflow 负责组织与调度。
2. Agent 与 Workflow:理解交给模型,边界交给代码
传统软件更强调确定性;基于大模型的应用会受到 Prompt、上下文、模型版本和检索结果影响。因此测试不能只看流程是否跑通,还要看准确率、相关性和稳定性。
视频给出的原则是:模型处理“理解和生成”,确定性节点控制边界。 例如合同审查中,条款理解和风险摘要可以交给模型,但用户权限、金额阈值和最终审批仍应由规则或人工节点控制。
一个 Workflow 通常可以拆成:定义输入和输出 → 检索知识 → 由 LLM 或 Agent 完成智能处理 → 按稳定格式汇总输出。复杂流程还可以加入条件分支、循环、工具调用、人工审核和异常处理。Code 节点适合数据转换,Template 节点适合字符串和 Prompt 构建,条件分支用于拦截无效输入,Iteration 用于批量处理列表。
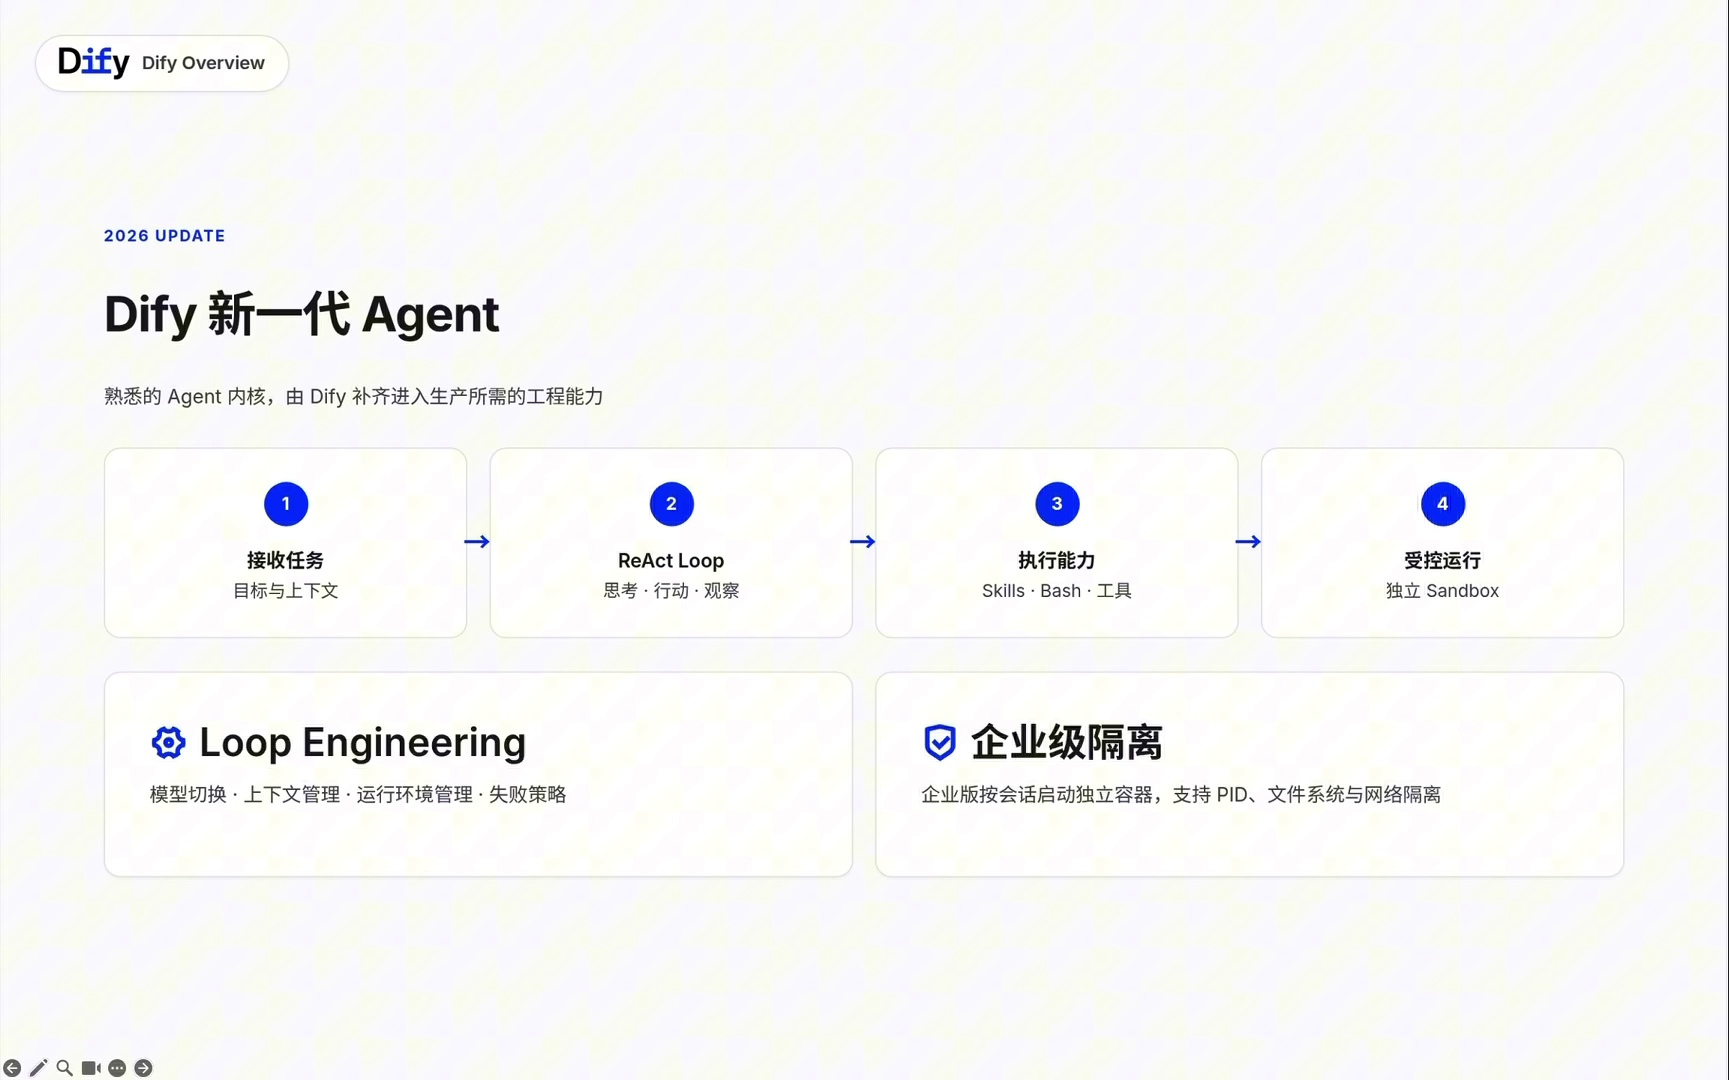
新一代 Agent 的核心是 ReAct Loop:分析任务,调用 Skills、Bash 或外部工具,观察结果,再决定下一步。真正上线时还要解决 Loop Engineering 问题:模型如何切换、上下文过重时怎么办、运行环境如何回收、失败后重试还是停止。
Agent 能力越灵活,越需要 Workflow 提供边界:何时启动、可以访问什么、失败如何处理、结果交给谁。执行工具时还要放在受控环境中,限制文件系统、网络和容器权限。
调试时要重点观察一次执行记录:输入校验花了多久,知识库召回了什么,Agent 进行了几轮,调用了哪些工具和参数,最终为什么停止。run_id 可以把 Dify 内部执行记录和外部日志关联起来,便于定位问题。
3. 知识库、部署与比赛相关准备
知识库有两条流水线: Ingest Pipeline 负责把文档解析、清洗、分块、向量化并建立索引; Query Pipeline 负责处理问题、检索候选内容并交给模型。
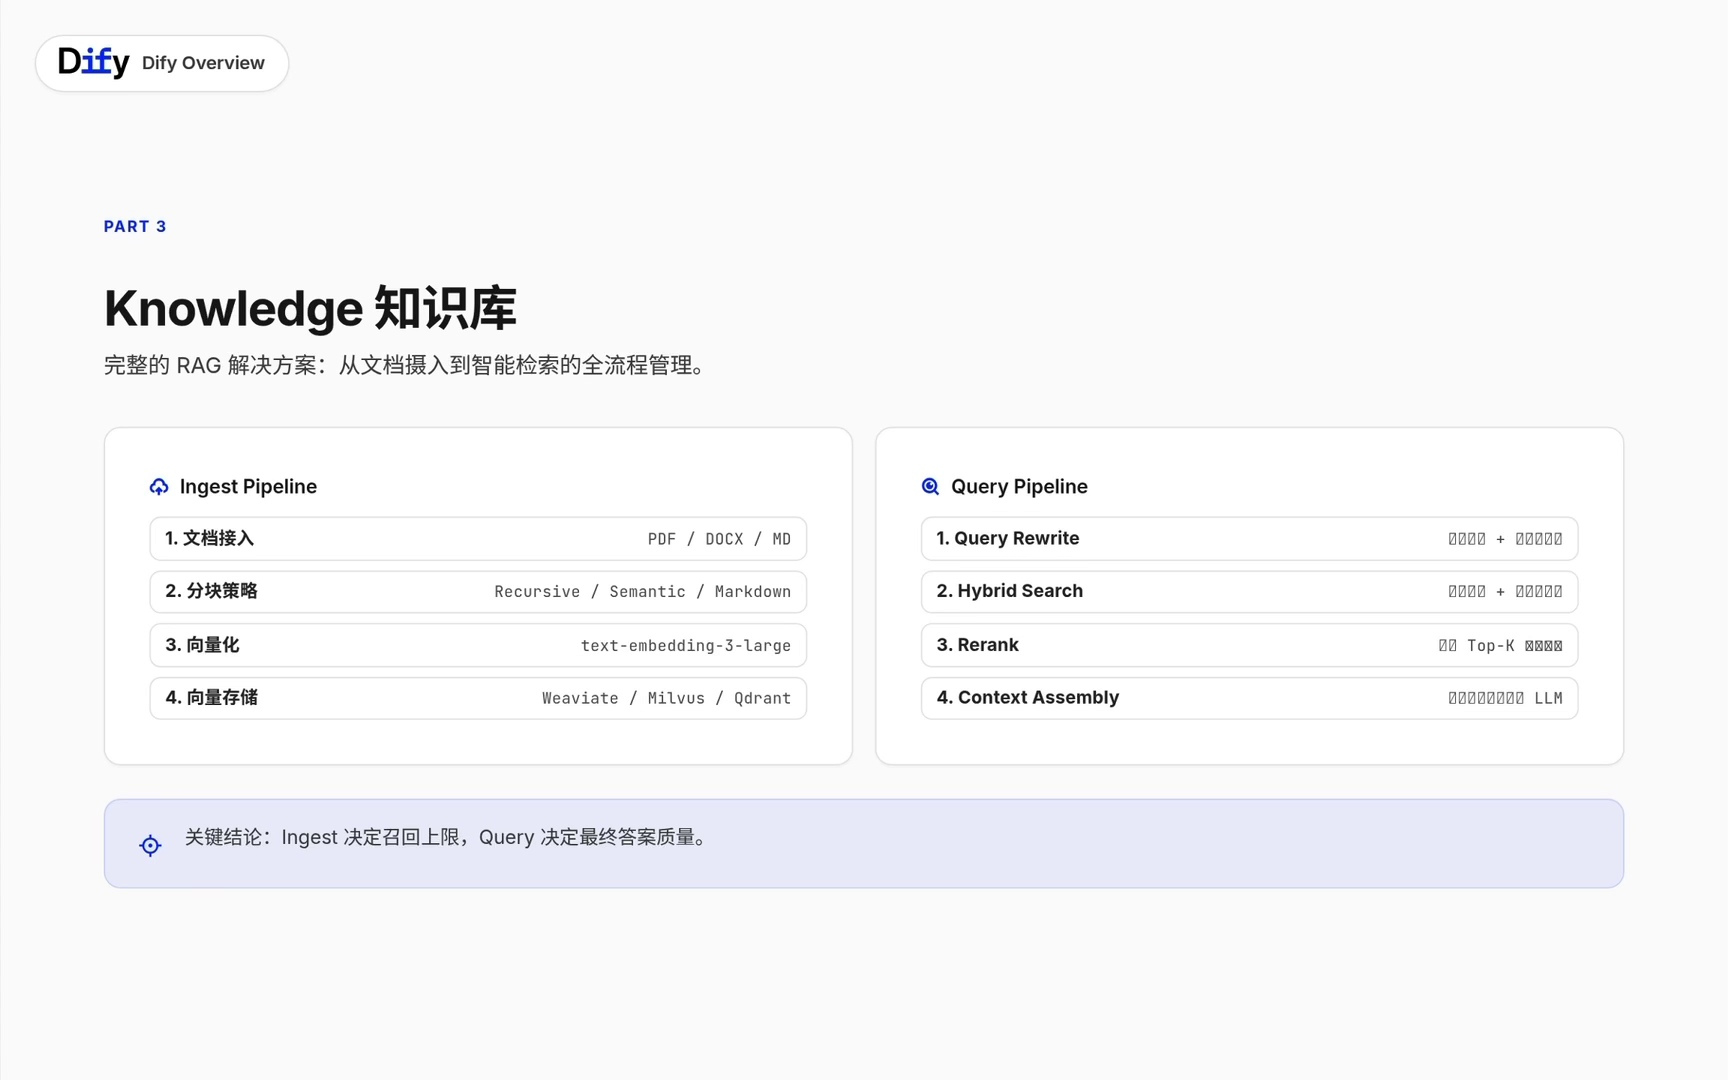
文档处理阶段如果丢失标题、表格关系或关键上下文,后面的模型无法补回,因此可以把 Ingest 理解为召回质量的上限。
检索阶段可以先做问题补全或改写,再进行语义检索和关键词检索,最后用 rerank 重新排序。
- 向量检索适合找语义相近内容,
- BM25 更适合产品型号、合同编号和精确条款;
两路召回后再重排,通常比只用一种检索更稳。TopK、TopN、分数阈值和分块大小不能直接照搬示例,需要用真实业务问题验证。涉及权限或时效时,还要把部门、版本、访问权限等元数据加入过滤条件。
分块也没有通用固定值。切得太小会拆散完整语义,切得太大又会带入无关内容。普通文档可以从 Recursive 策略开始,Markdown 可按标题层级切分,代码尽量保持函数边界,表格不要把表头和数据拆开。
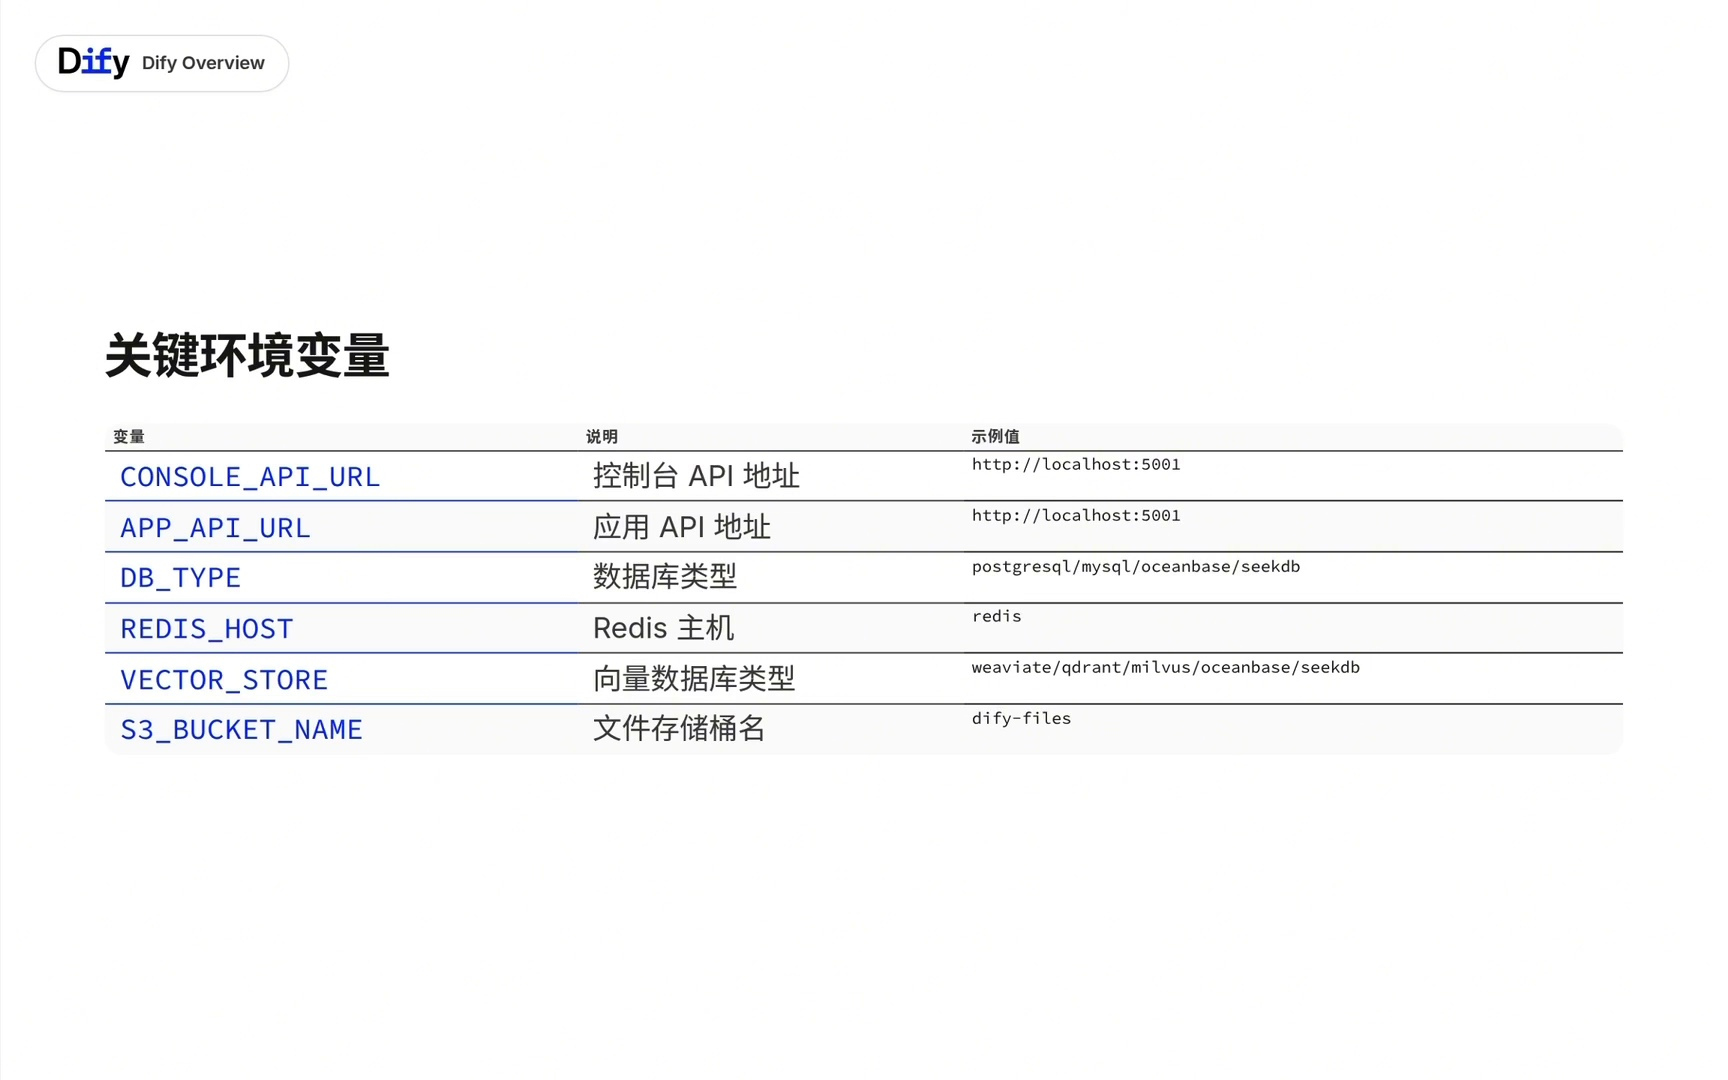
部署上,视频演示了 Git Clone 源码、进入 Docker 目录、复制配置文件,再执行 Docker Compose 启动。Dify 不是单容器应用,通常还会涉及 API、Web、Worker、Agent Backend、数据库、Redis、对象存储、向量存储、Action Backend 和 Sandbox。遇到问题时,应按容器查看日志,而不是只看页面是否能打开。
生产架构中,各组件职责不同:关系数据库保存应用状态,Redis 负责缓存和队列,对象存储保存文件,向量数据库保存知识索引,Sandbox 承载 Agent 的受控执行。视频强调,具体数据库支持要结合实际 Dify 版本和配置验证,不能只看环境变量名称。
本讲最后给出的实践顺序是:先做一个最小 Workflow,再接入知识库或工具,然后通过 API Trigger 或 Agent 连接真实业务,最后补充评估、可观测性、安全和高可用。对参赛准备来说,最值得先练的是一条可解释的 Workflow、一套能验证召回质量的知识库,以及一次完整的执行日志排查。