第7讲:File SQL for AI Agent学习笔记
发布于
来源:《第七讲 File SQL for AI Agent》,视频约 18 分 23 秒。核心内容是让数据库直接认识并查询外部文件,减少 Agent 为了读取文件而反复建表、导入和清理数据的工程负担。
1. 为什么需要 File SQL
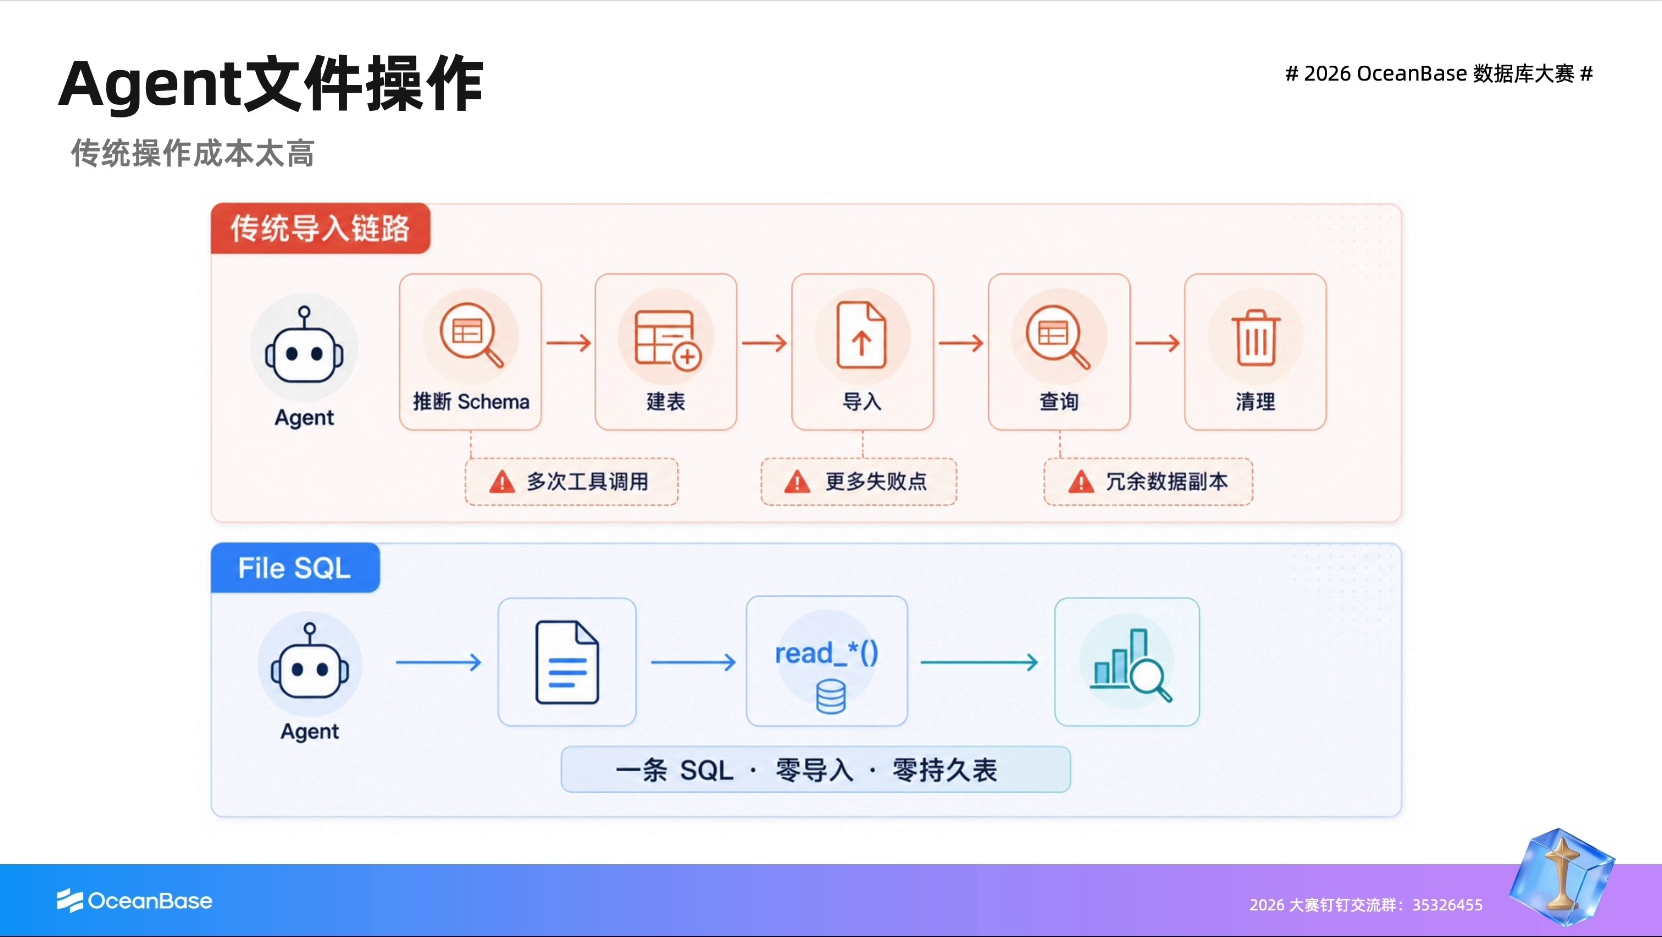
传统流程通常是:推断 Schema → 建表 → INSERT 或批量导入 → 查询 → 清理临时数据。对 Agent 来说,这条链路会带来几个问题:多次重试可能重复插入,导入过程增加失败点,文件变化后数据库表容易成为过期副本,文件导入还会拖慢需要快速响应的任务。
File SQL 的思路是:文件仍在原位置,数据库通过 SQL 直接读取它。不必先把文件导入持久表,可以在查询时形成临时关系。这样更适合 Agent 的探索式任务:发现文件、理解结构、查询和加工,最后按需导出结果。
视频介绍了三类实现路径:
- 嵌入式分析引擎直接读文件
- 把文件注册到 Catalog
- 以及共享存储治理。
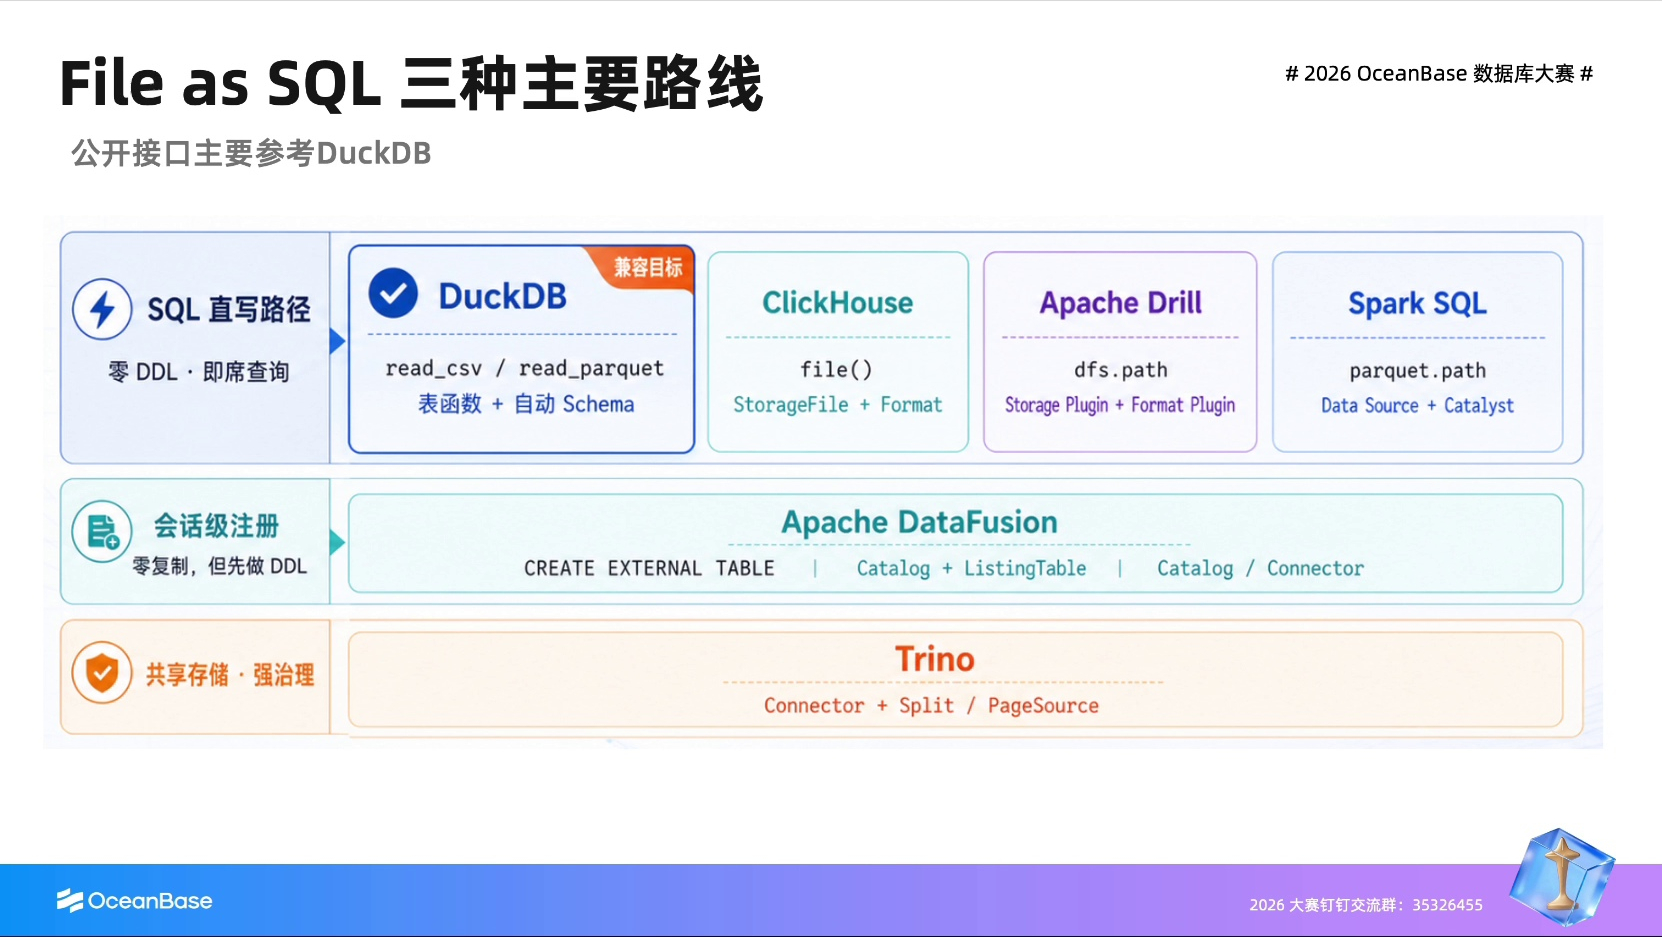
课程重点参考 DuckDB 的 File SQL 体验,但执行引擎并不依赖 DuckDB,而是希望在 seekdb 中实现相应的解析、优化和执行能力。
2. File SQL 的查询流程与实现边界
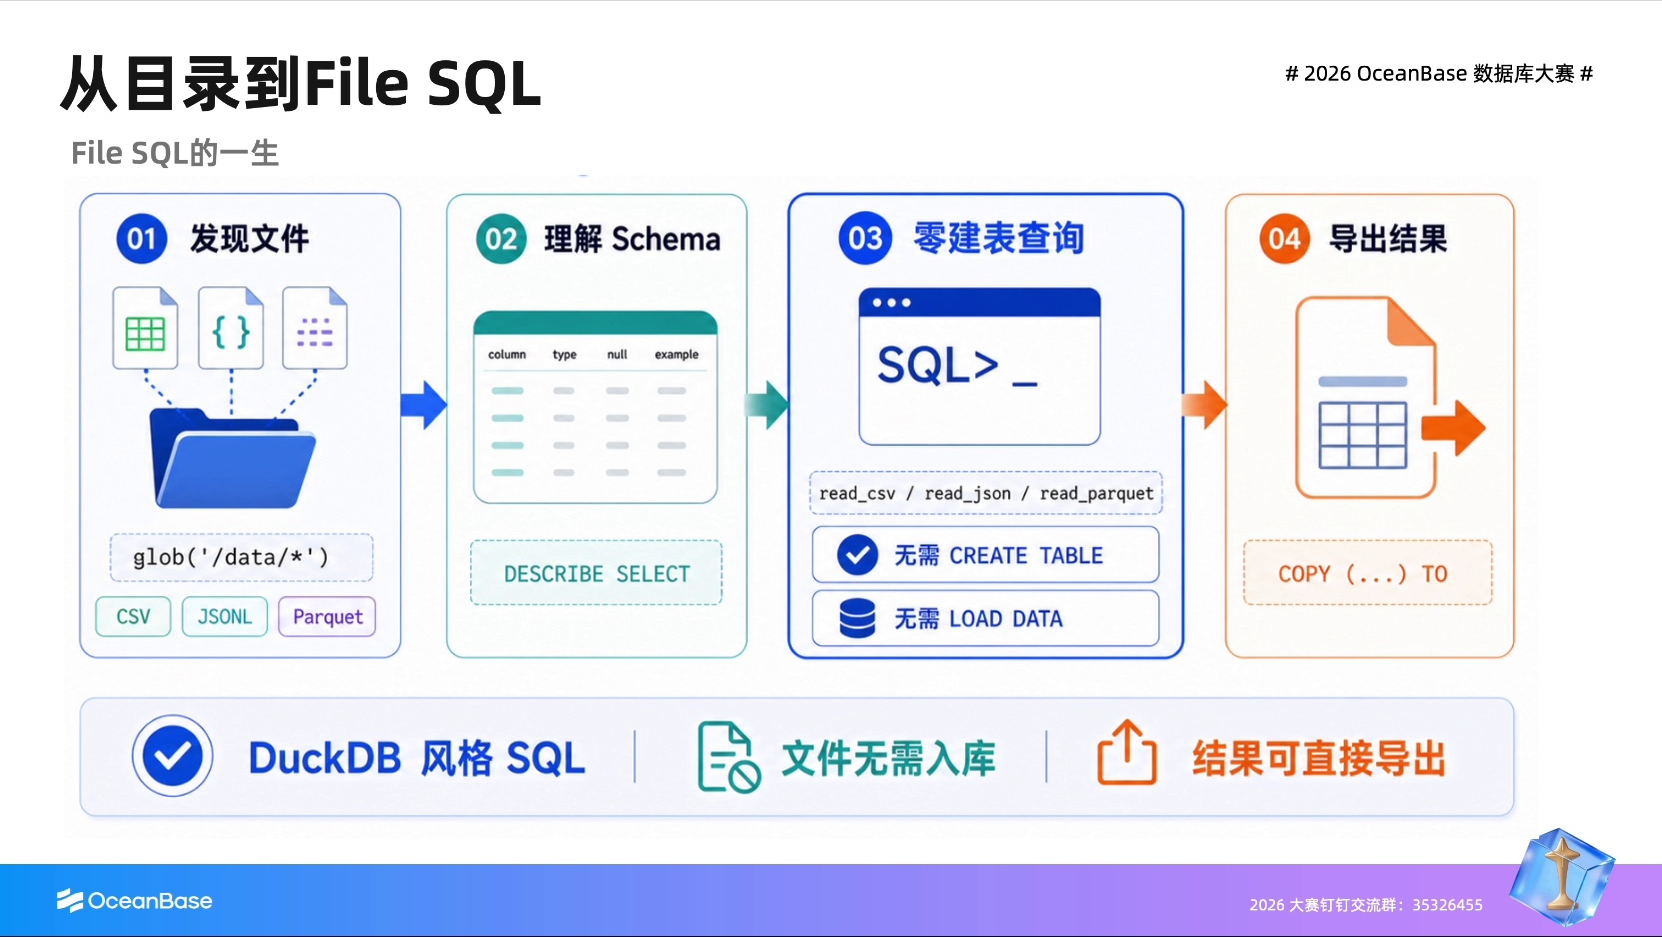
DuckDB 风格的文件查询可以按格式提供函数,例如 read_csv、read_json、read_parquet;还可以使用文件发现、描述结构、查询、连接、聚合,以及把结果导出为文件的能力。典型流程可以记成:
发现文件 → 推断 Schema → 读取文件 → 执行过滤/聚合/连接 → 导出结果。
几个边界需要记住:
- 文件格式是公开接口的一部分,不同格式对应不同读取函数;格式、分隔符等不符合函数约定时不能假定可以读取。
- 文件访问必须有安全边界,目录需要经过数据库允许,不能借助 SQL 越界访问任意路径;导入导出的安全控制与
LOAD DATA的安全参数有类似考虑。 - Schema 推断发生在执行前的准备阶段,不等于一次导入;文件也不会长期注册成普通数据库对象。
- 支持范围从单文件的类型推断、
WHERE、ORDER BY、LIMIT、聚合,到多文件的JOIN;课程列举的重点格式是 CSV、JSON 和 Parquet。复杂多文件场景是否纳入最终测试,以题目和测试用例为准。
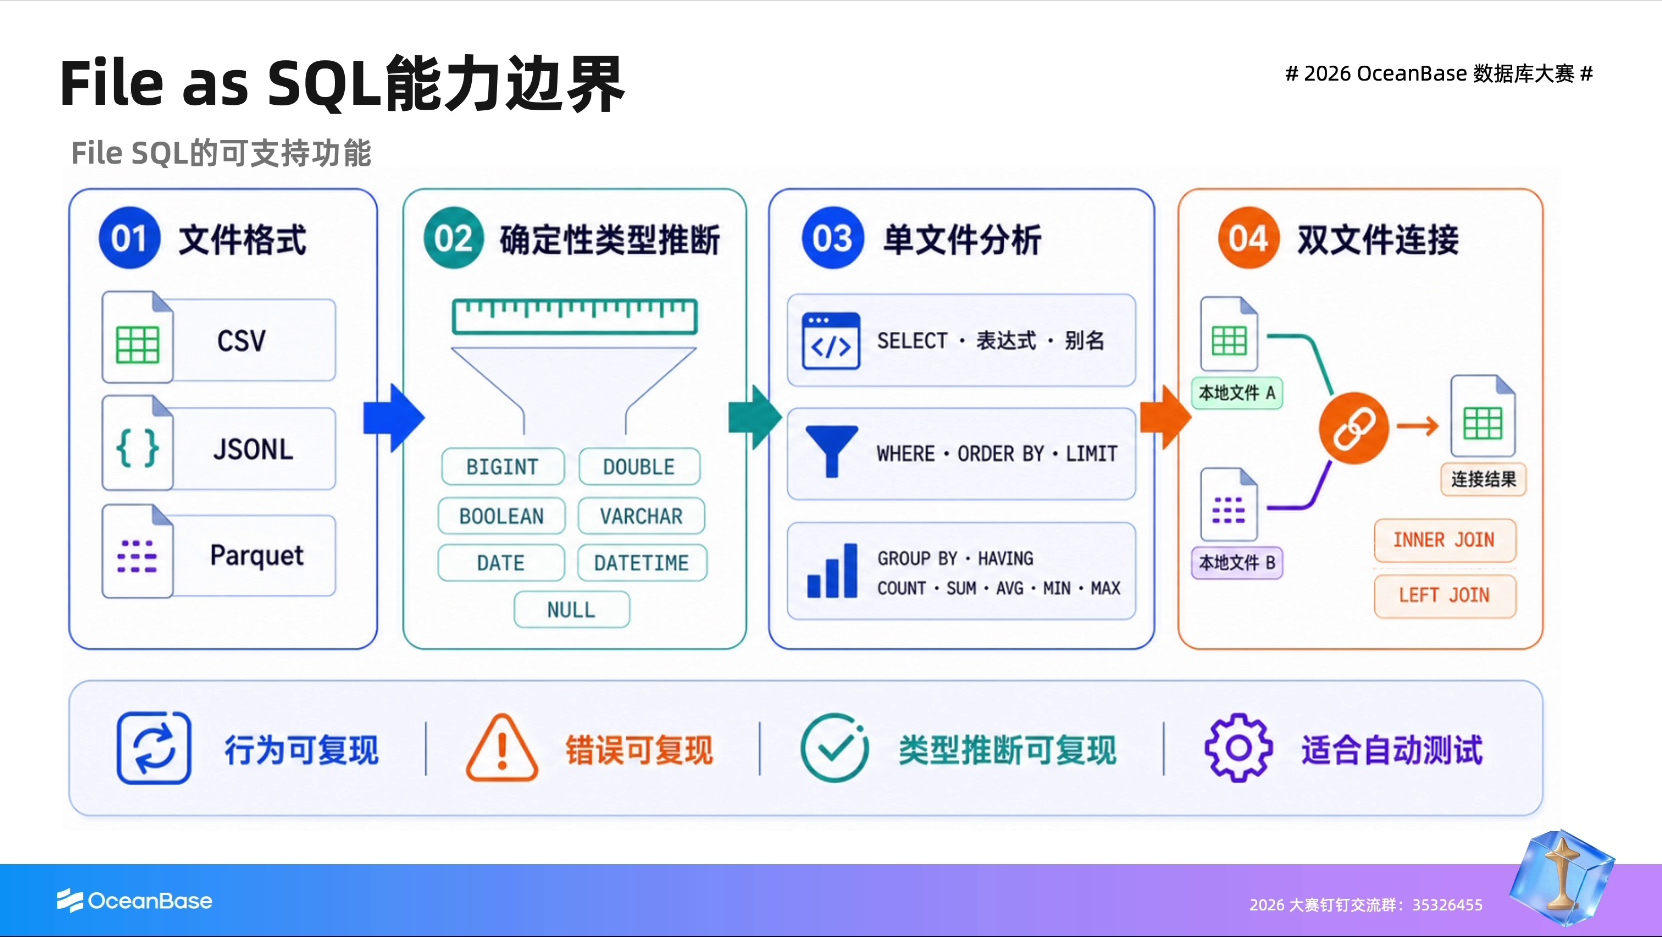
课件把这条能力链具体收敛为四个层次,也构成了 File SQL 在本讲中的能力边界:
- 文件格式:支持 CSV、JSONL 和 Parquet,并为不同格式提供对应的读取函数。
- 确定性类型推断:从文件内容推断
BIGINT、DOUBLE、BOOLEAN、VARCHAR、DATE、DATETIME和NULL等类型。同一个文件反复读取时,推断结果应保持稳定。 - 单文件分析:支持
SELECT、表达式、别名、WHERE、ORDER BY、LIMIT、GROUP BY、HAVING,以及COUNT、SUM、AVG、MIN、MAX等聚合。 - 双文件连接:支持本地文件之间的
INNER JOIN和LEFT JOIN,把两个文件的结果组合起来。
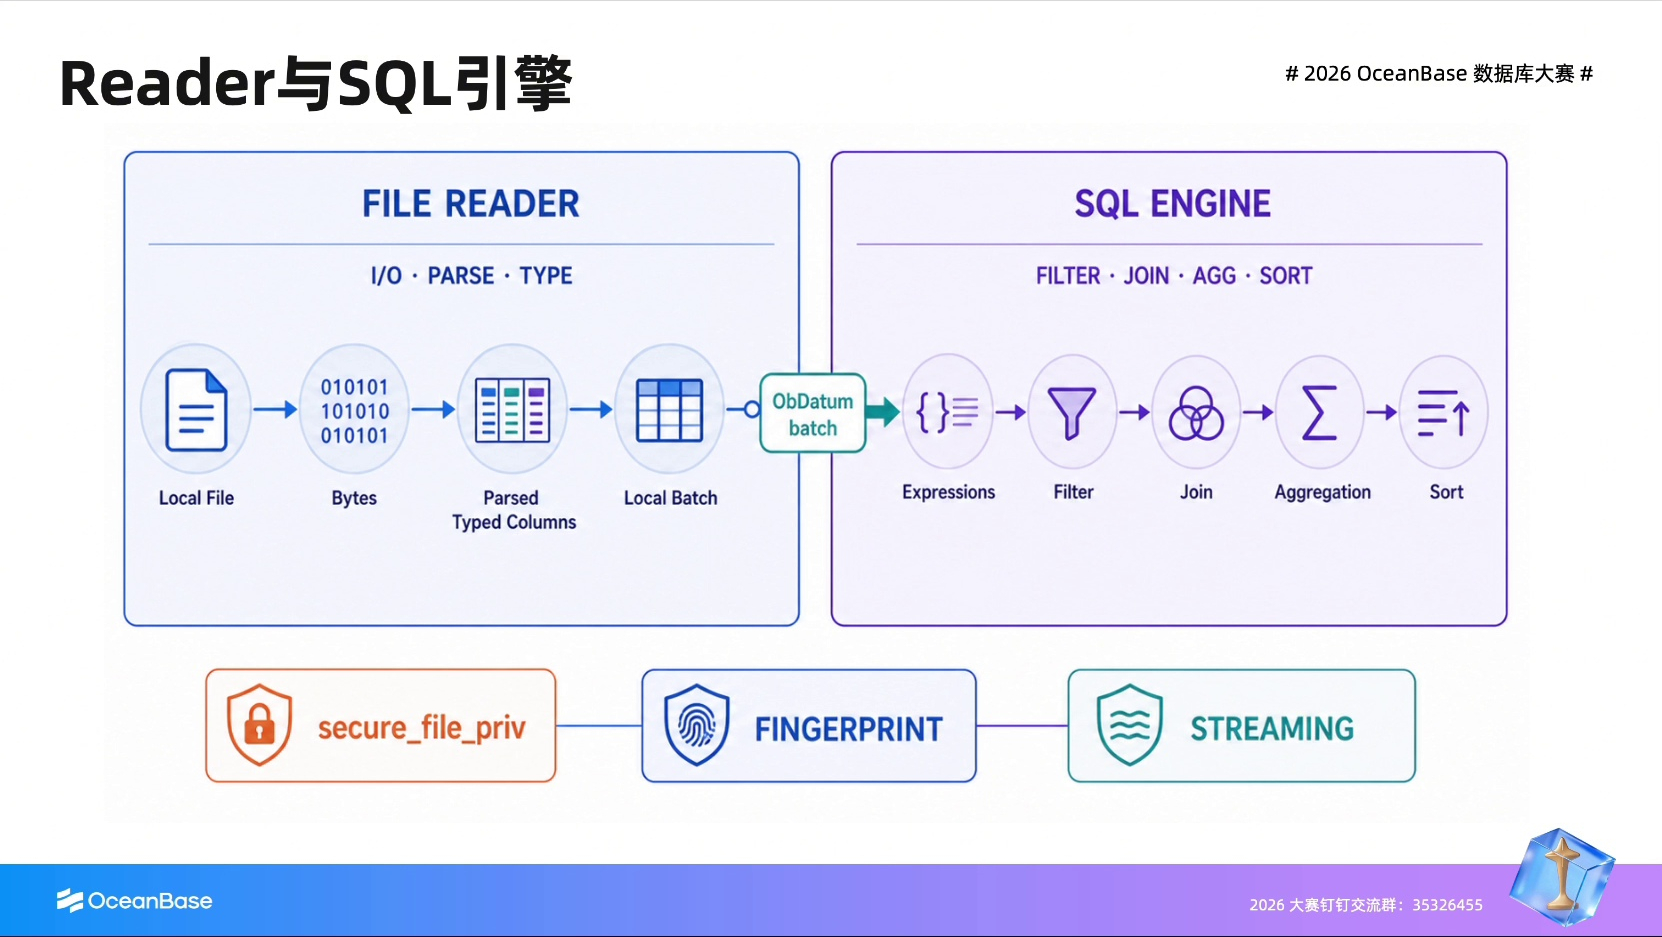
有了这组能力边界,再看它在数据库内部如何落地就更清楚了:SQL 先被解析为文件扫描算子,再根据 CSV、JSON、Parquet 等格式分派到相应的物理读取器。读取器负责文件 I/O、解析和类型转换,把文件字节流变成列值;过滤、聚合、排序和连接等关系运算,则交回数据库已有的执行引擎。这样既能复用数据库已有的表达式、算子和优化器,也不需要在数据库旁边嵌入一个完整的外部数据库。
视频还强调了几个实现关注点:
- 目录白名单和路径校验要在解析准备阶段进行,真正打开文件时也要再次防护;
- 读取器与关系执行引擎之间保持清晰边界;
- 大文件需要流式读取,避免一次性加载到内存;
- 文件指纹可用于发现文件变化。
3. 这道比赛题要完成什么
讲者把本题定义为一个 Feature 题:目标是把 File SQL 作为 seekdb 的数据库能力实现出来,而且 Agent 确实需要这种“无需先导入即可使用文件”的能力。重点不是单纯写出几个能运行的函数,而是形成一条完整、可维护、可验证的功能链路。
建议按下面的顺序拆解:
- 需求分析:明确支持的文件格式、函数语法、Schema 推断规则和安全边界。
- 架构设计:分别设计 Parser、Resolver、Optimizer、File Scan 物理算子和各格式 Reader。
- 逐步实现:先让基础读取和类型转换可用,再接入过滤、聚合、排序、连接和导出。
- 质量保障:关注功能正确性,同时不破坏已有功能;还要考虑安全性、可用性、性能和可维护性。
- 持续验证:用单元测试覆盖解析、类型推断和 Reader,用 MySQL Test 做 SQL 到端到端链路测试。
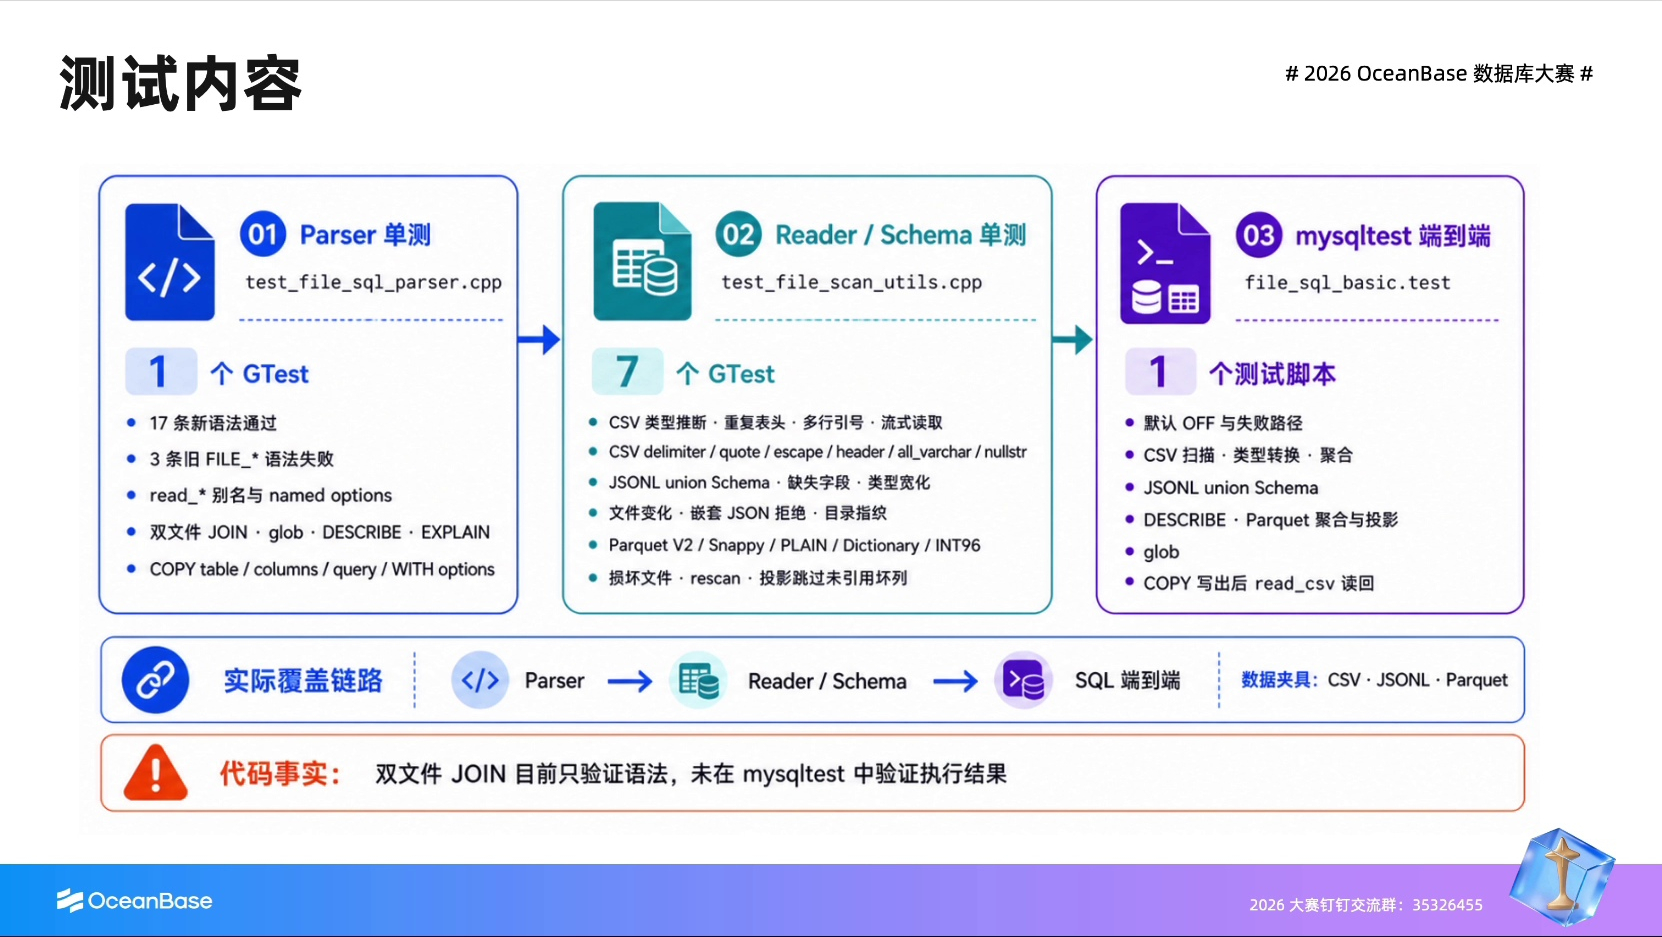
视频提到的测试覆盖包括:Parser、Schema、SQL 端到端,以及 CSV、JSON、Parquet 文件类型。当前讲解还提到远端会执行相应测试;具体用例、测试范围和最终题面应以比赛后续发布内容为准。
这讲最需要记住的是:File SQL 的价值在于消除“文件—临时表—清理”的重复搬运,同时把安全、类型、执行计划和测试一起做完整。 如果只实现一个 read_csv 能返回数据,却没有路径保护、Schema 处理、错误边界和测试覆盖,功能链路仍然是不完整的。