第4讲:阶跃星辰赛题方向解析学习笔记
发布于
学习资料:OceanBase《2026 从 0 到 1 数据库实践教程》第四讲
主讲人:王泽林(OceanBase 开源研发专家)
记录日期:2026 年 9 月 7 日
以下按视频与课件整理,尚未实现赛题;要求与产品介绍均按课程当时的说明记录。
1. 阶跃星辰的定位与本题方向
课程介绍,阶跃星辰关注智能终端与端云协同:端侧处理高频、低延迟和涉及隐私的任务,云端承担复杂推理与长链路任务。产品分为 Pro、Flash、Edge 等系列,并覆盖音频、图像、视频和 GUI 等多模态能力。其中 Step Edge 面向手机、车机等终端场景。
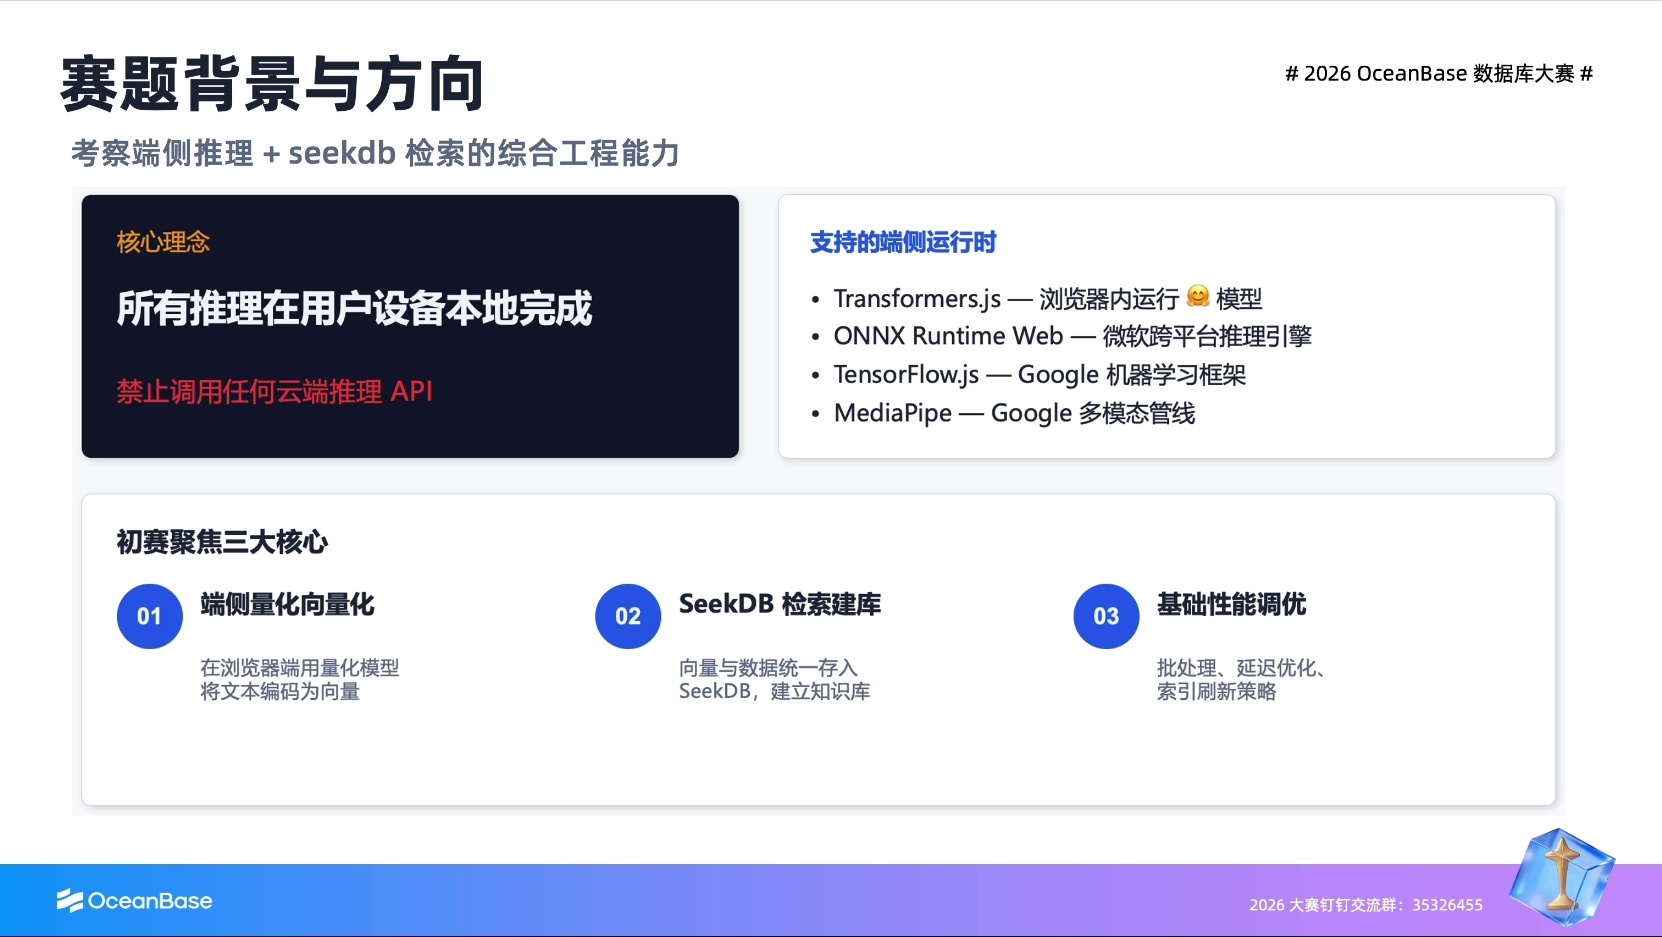
本次合作题目落在端侧应用:做一个浏览器端“端侧向量化+seekdb 语义检索”的迷你知识库。 核心是把模型推理、数据存储和检索流程真正跑通,并完成基础性能优化。
虽然产品介绍包含端云协同,本题要求推理在用户设备本地完成,禁止调用云端推理 API。模型可以自行选择公开可获取的开源模型,并在文档中声明来源;题目没有限定必须使用阶跃星辰的模型。
2. 需要实现的知识库与任务要求
从导入到检索的完整流程
用户导入文本资料(可选包含图片)
    → 浏览器加载量化 Embedding 模型,在本地生成向量
    → 将向量、原文和元数据写入 seekdb
    → 通过 seekdb 完成向量+全文混合检索
    → 展示检索结果
这里 Embedding 的作用是把文本编码为向量,seekdb 则负责数据与索引管理、检索。我的理解是,本题重点在于知识库的导入和检索流程,课程没有将大模型生成回答列为必交功能。
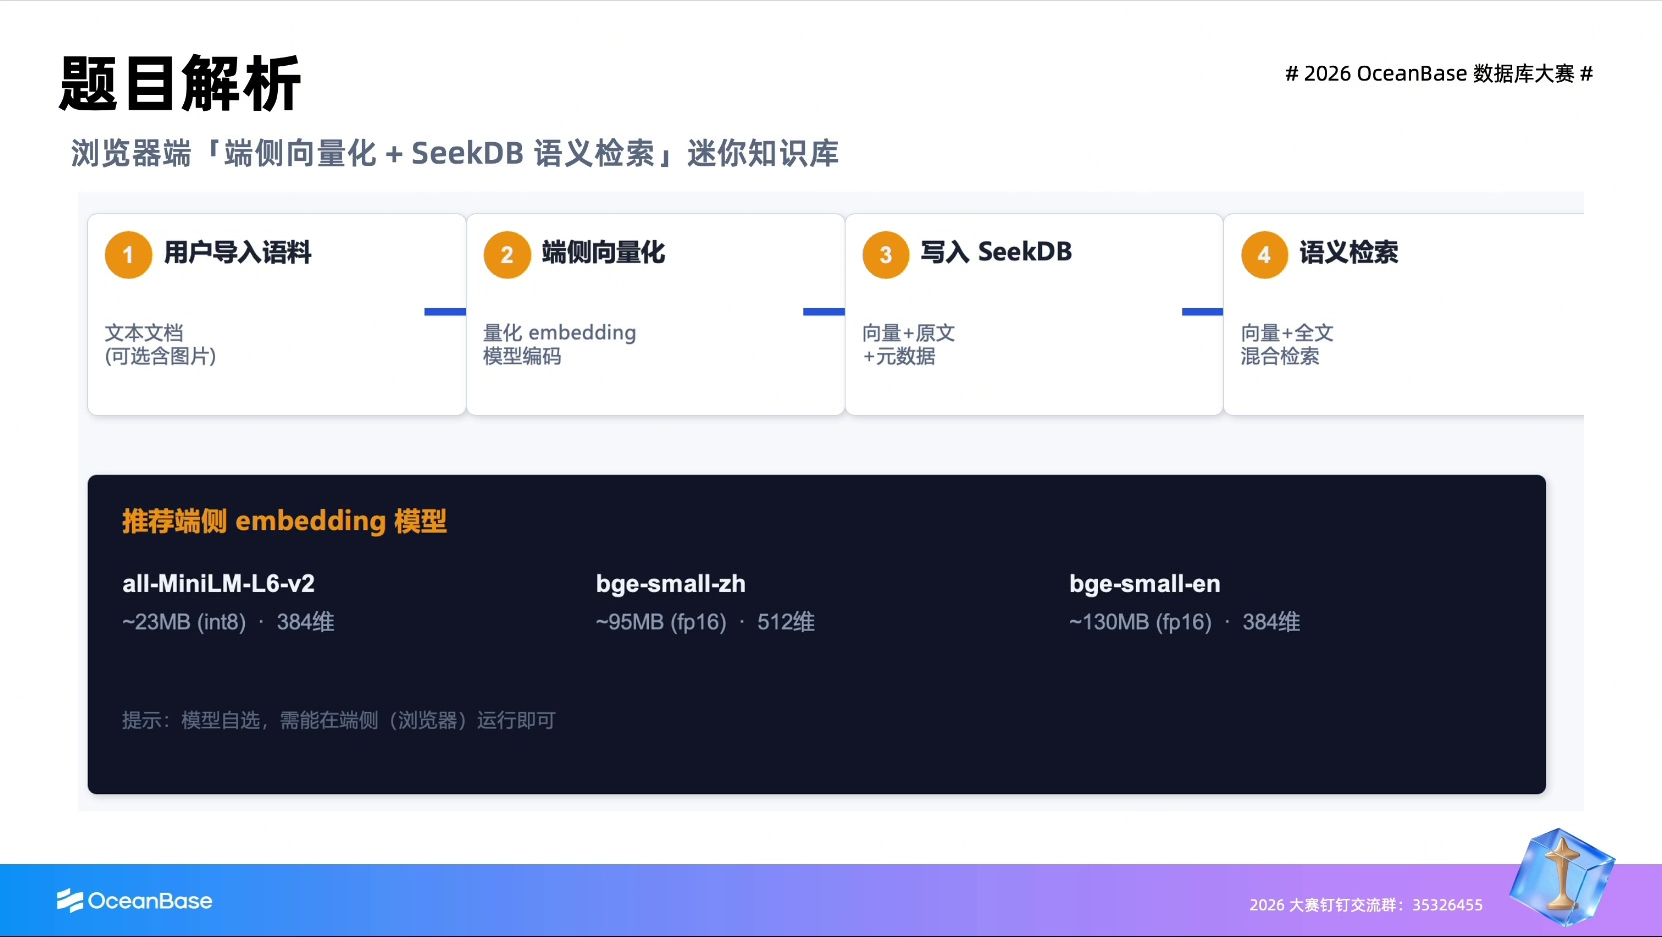
课件列出的参考模型包括 all-MiniLM-L6-v2、bge-small-zh、bge-small-en。它们是选型参考,实际采用的模型需要能在浏览器端运行。
核心实现要求
| 部分 | 需要完成的内容 |
|---|---|
| 端侧推理 | 使用 Transformers.js、ONNX Runtime Web 等端侧运行时;模型在客户端加载并执行,文本在浏览器本地编码为向量 |
| 模型量化 | 按课件要求采用 int8 或 fp16 方案,在技术说明中给出量化前后的体积压缩比与精度变化 |
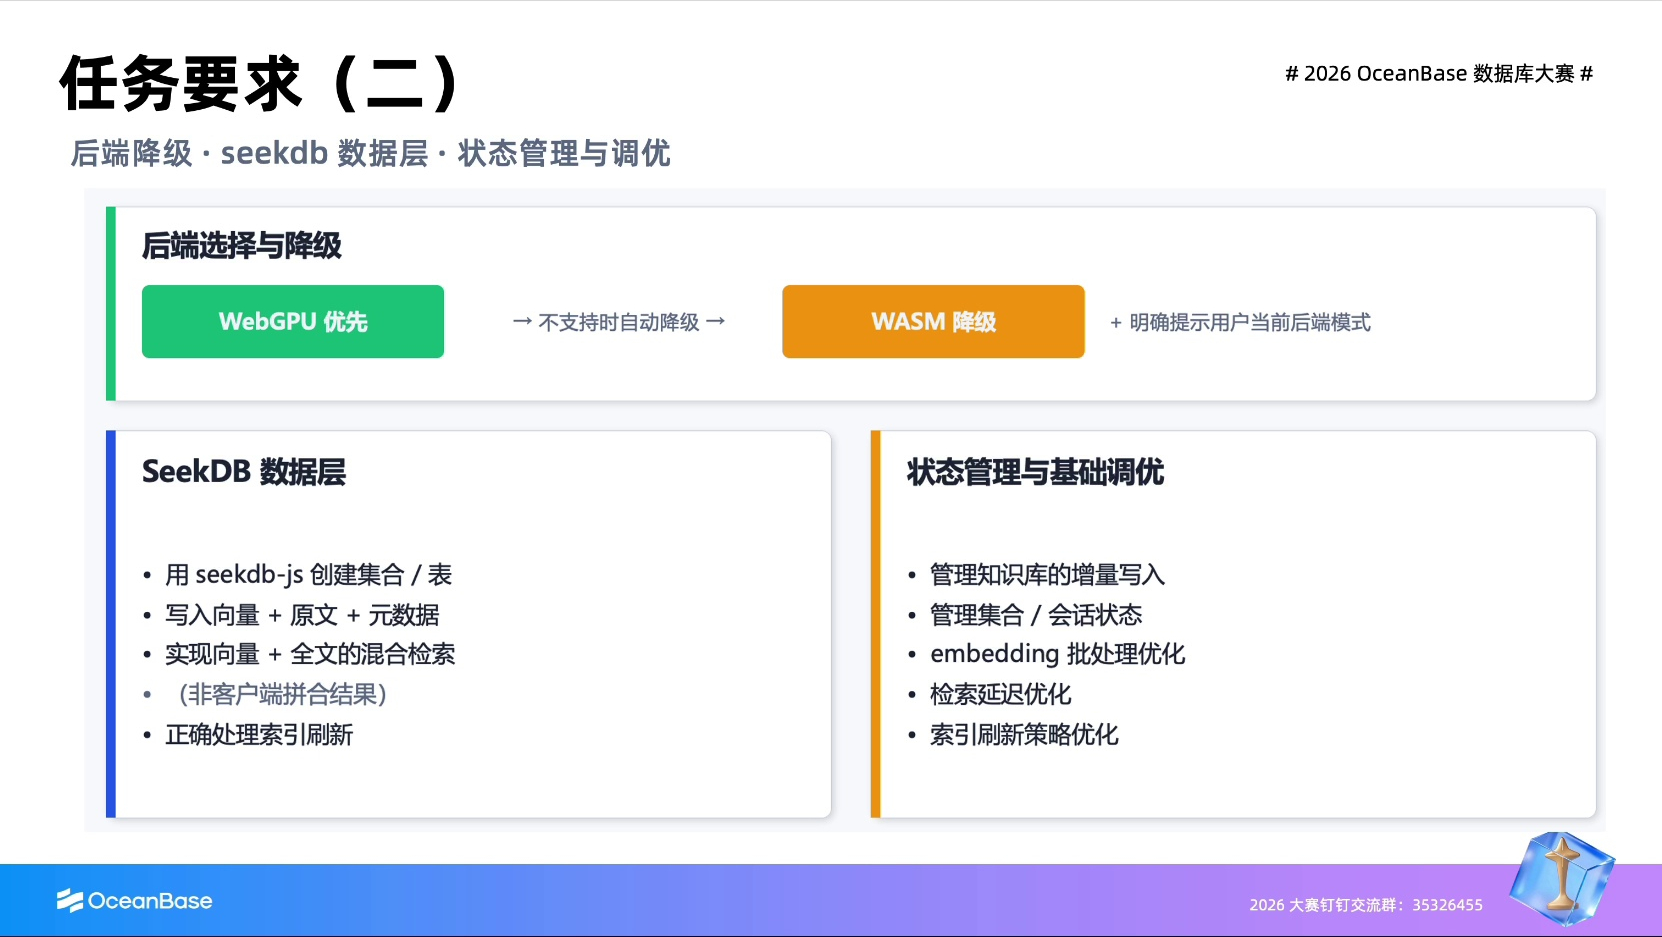
| 运行后端 | 优先使用 WebGPU;不可用时自动降级到 WASM,并向用户显示当前运行模式 |
| seekdb 数据层 | 使用 seekdb-js 创建集合/表,写入向量、原文和元数据,建立并正确刷新索引 |
| 混合检索 | 由 seekdb 完成向量+全文混合检索,课件明确要求不能只是客户端拼合结果 |
| 状态与调优 | 管理知识库增量导入、集合/会话状态,优化 Embedding 批处理、检索延迟和索引刷新策略 |
这里的 WebGPU/WASM 是浏览器内的推理执行后端。降级后仍在本地执行,不是把请求转交给云端。
量化效果需要用自己的模型文件和实验结果说明。课件中的体积压缩示意可作参考,不能直接当作自己项目已经达到的结果。
通用规则与容易遗漏的边界
课程列出六条通用规则:端侧运行、必须使用 seekdb、模型开源、可运行交付、浏览器兼容,以及禁止预计算回放或伪装端侧实际走远程推理。
其中需要特别记住:
- 存储与检索必须经过 seekdb,课件允许嵌入式或本地 server 形态;推理在浏览器内完成,不代表数据库也必须在浏览器里运行。
- 支持主流现代浏览器,课件点名 Chrome/Edge,并要求处理 WebGPU 不可用的情况。
- 不能用提前算好的结果代替现场推理,也不能把远程推理包装成本地执行。
- 增量导入、索引刷新和状态管理都属于题目内容,不能只演示一次静态查询。
讲者还提到,评测时会提供一份较大的语料库。本讲未给出具体规模、分值或延迟验收阈值。
3. 技术方案与交付清单
课程给出的参考技术栈
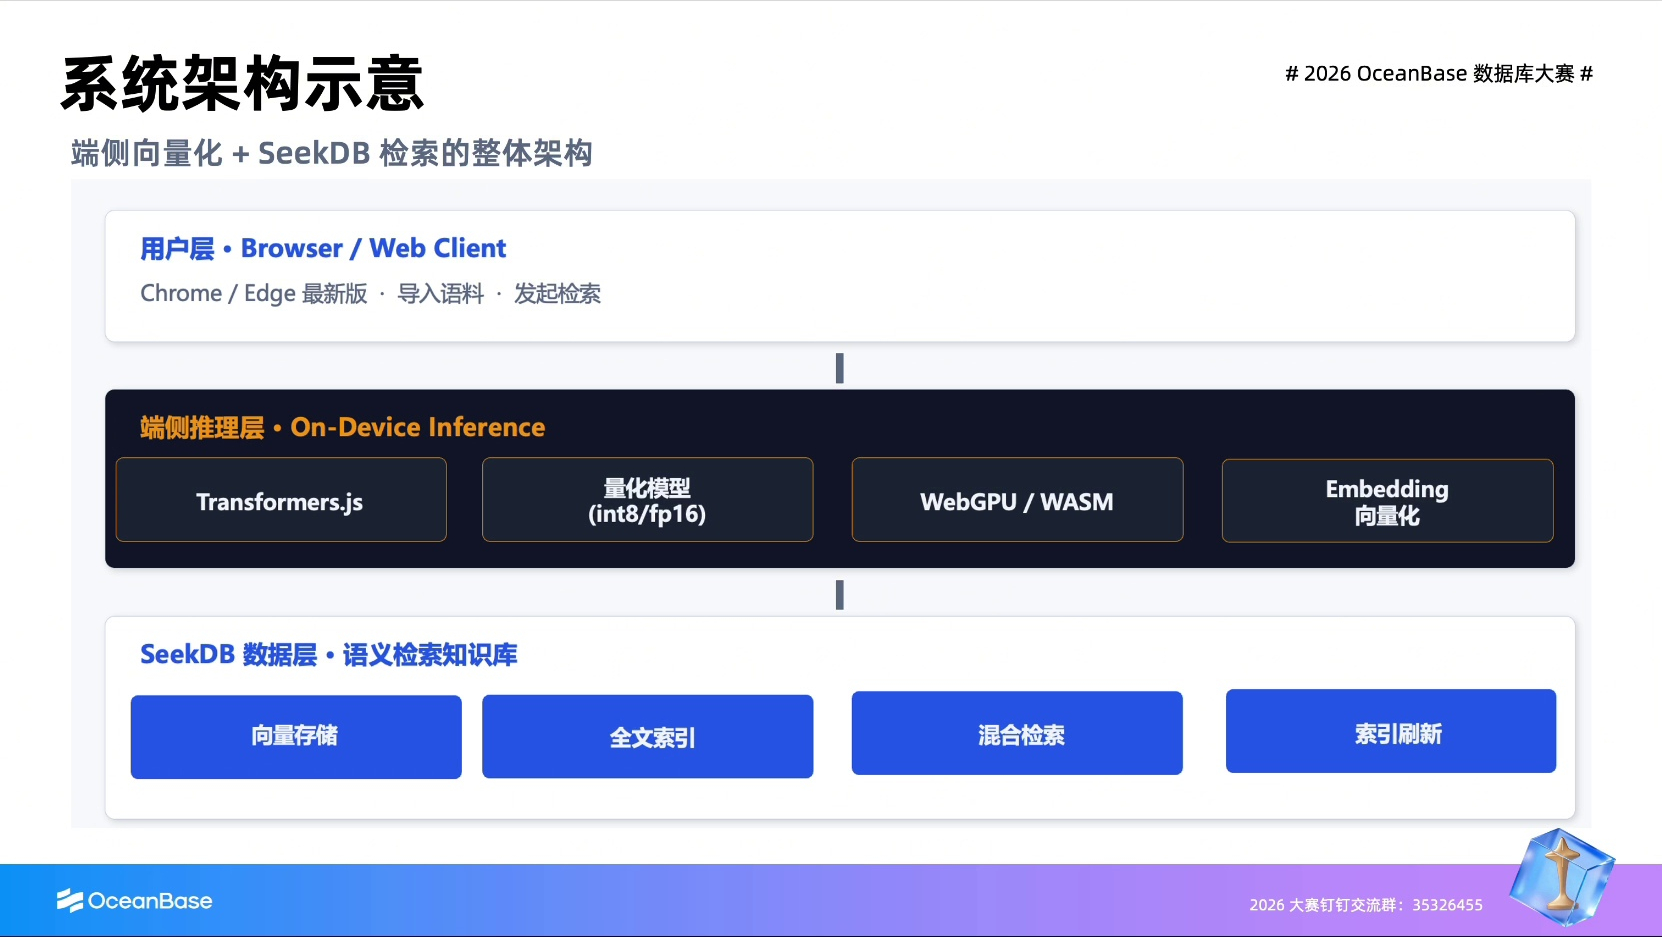
整体可以分为三层:浏览器负责导入与交互,端侧运行时负责向量化,seekdb 负责知识库存储与检索。
| 层次 | 课程中的参考选择 |
|---|---|
| 模型运行时 | Transformers.js、ONNX Runtime Web;背景介绍还列出 TensorFlow.js、MediaPipe |
| 推理执行 | WebGPU 优先,WASM 降级 |
| 模型资源 | Hugging Face 上的开源模型,例如 Xenova 提供的 ONNX 模型 |
| 数据库 | seekdb,配合 seekdb-js,以嵌入式或本地服务方式接入 |
课件给出的资料入口:seekdb 文档、seekdb-js 仓库、Xenova 模型资源。这里记录入口供后续查看,本次没有验证依赖版本或运行这些示例。
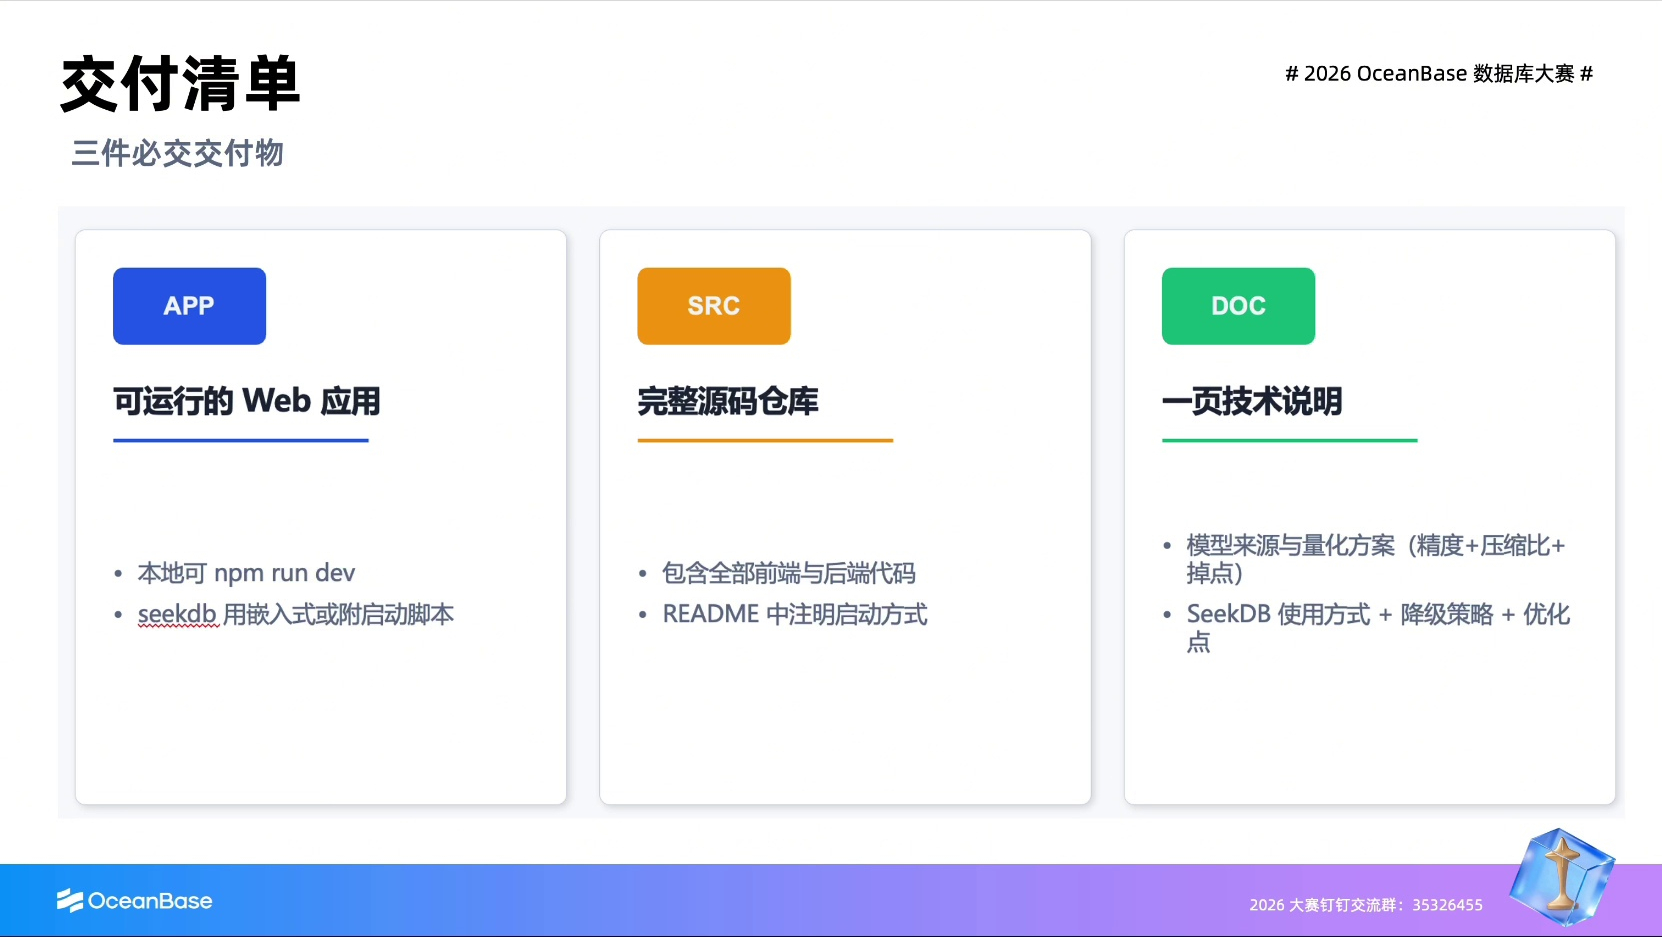
三件必交付物
| 交付物 | 具体内容 |
|---|---|
| 可运行的 Web 应用 | 本地能通过 npm run dev 启动;seekdb 使用嵌入式,或附带本地服务启动脚本 |
| 完整源码仓库 | 包含全部前端、后端代码,README 写清启动方式 |
| 一页技术说明 | 说明模型来源与量化方案、seekdb 使用方式、降级策略和优化点 |
一页技术说明需要覆盖四方面:
- 模型与量化:模型名称、来源、int8/fp16 方案、体积压缩比和效果变化。
- seekdb 使用:集合或表的字段与索引设计,向量+全文混合检索方式。
- 运行与降级:WebGPU 选择策略、WASM 降级触发条件及界面提示。
- 状态与优化:增量写入、会话状态、批处理、检索延迟与索引刷新。
这道题考察的是一个可运行、可解释的端侧检索应用:既要证明向量在本地生成,也要让 seekdb 实际承担存储和混合检索,并说明模型压缩、兼容性和性能方面的工程取舍。