第3讲:向量数据库与 RAG学习笔记
发布于
学习资料:OceanBase《2026 从 0 到 1 数据库实践教程》第三讲《向量数据库与 RAG》
主讲人:远智(张易),主要负责 OceanBase 多模相关工作
记录日期:2026 年 9 月 7 日
本文按课程内容整理,性能数据为课件结果,尚未自行复现;功能状态按讲者录制时的说明记录。
1. 向量索引与量化:兼顾检索效率和存储成本
课程先介绍了 OceanBase 的两类向量索引:HNSW 和 IVF。它们决定向量如何组织、查询时如何寻找候选;量化则用于压缩向量表示,降低内存等资源开销。
| 方法 | 课程中的特点与定位 |
|---|---|
| HNSW | 基于图组织向量,搜索涉及较多随机访问;课程主要用于内存中的检索,在性能与召回率之间取得平衡 |
| IVF | 基于聚类组织向量,数据局部性较好;课程将其与磁盘存储、分布式能力结合,用于更大规模的数据 |
课程给出的方案是:百万级向量采用 HNSW+量化;更大规模则结合 磁盘+IVF+量化+分布式。这是课程介绍的方案划分,实际选择还要结合数据与资源条件。
量化部分以原始索引占用 100 GB 为例:
| 方案 | 课件示例占用 |
|---|---|
| 原始向量索引 | 100 GB |
| SQ(标量量化) | 25~35 GB |
| BQ(二值量化) | 约 5 GB |
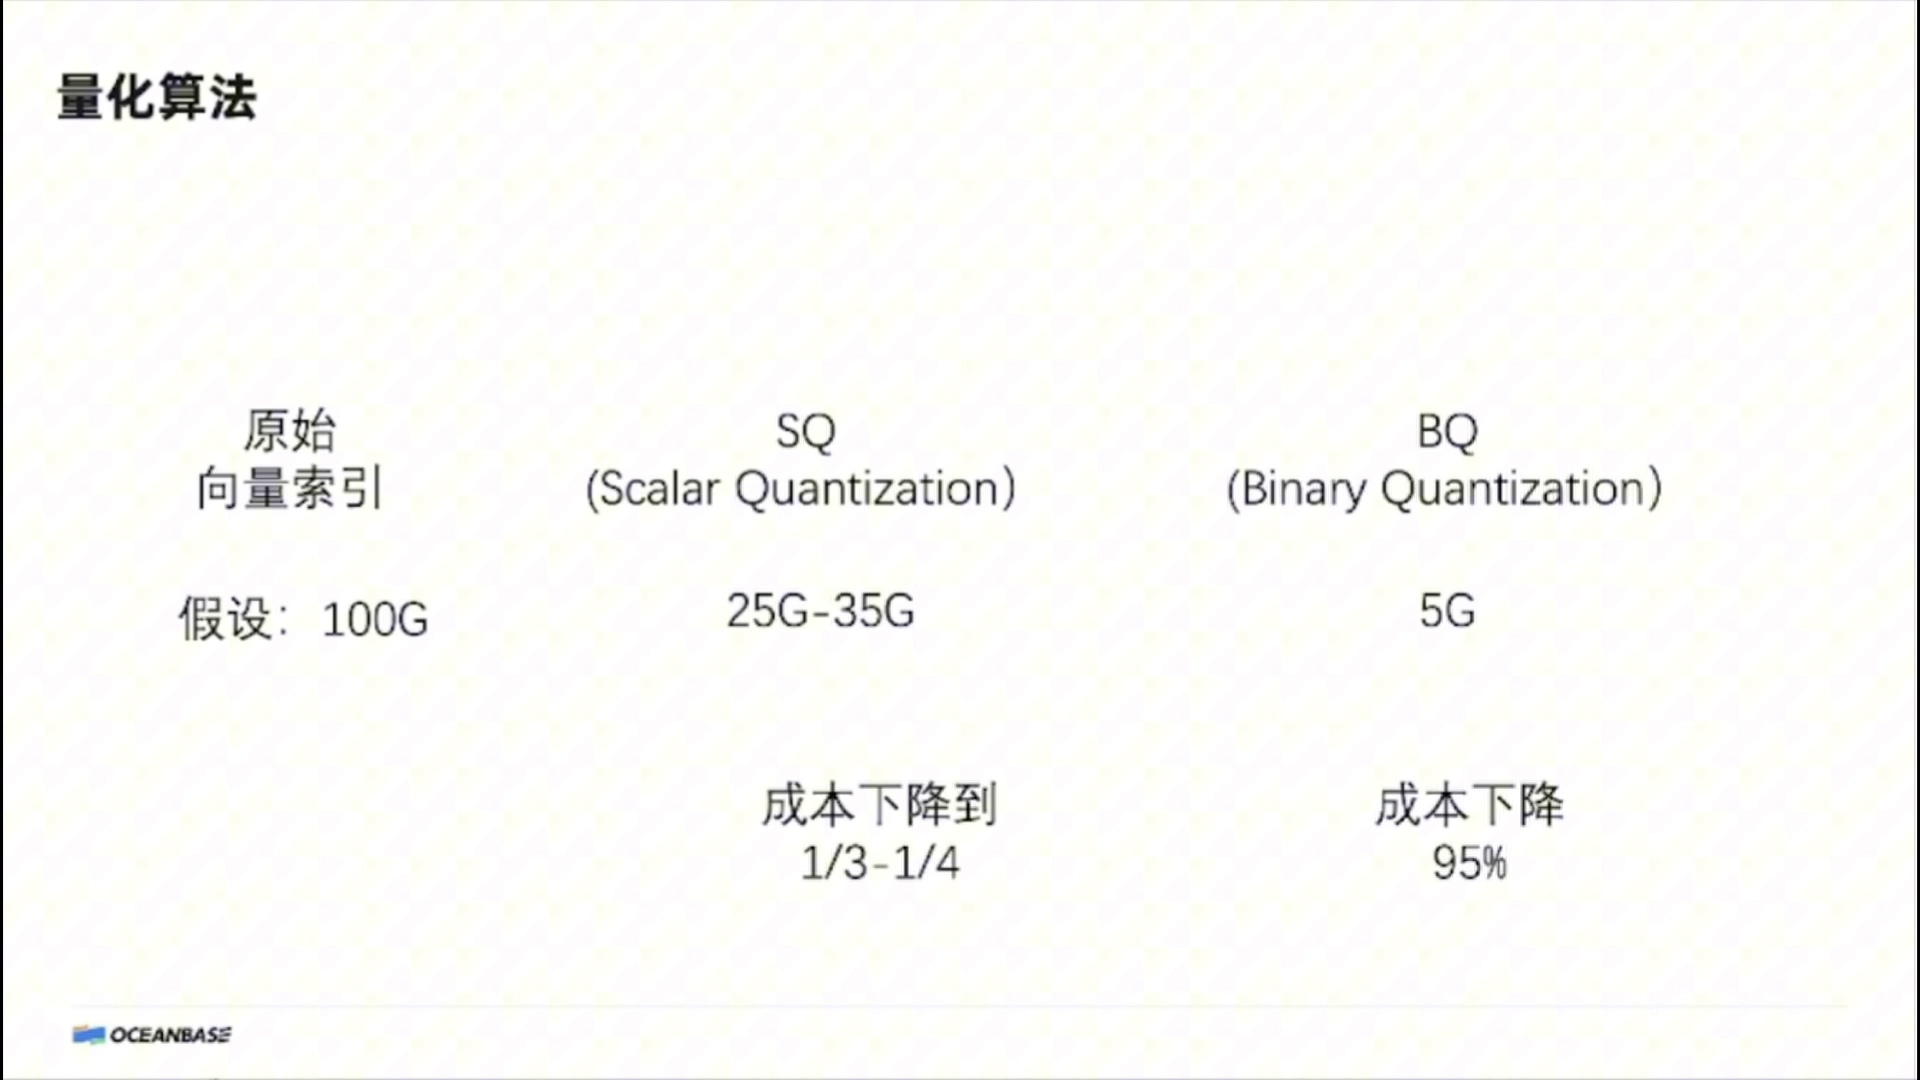
我的理解是,索引组织与量化解决的是不同层面的问题,可以组合使用。上面的数字用于说明课程方案的压缩效果,并非所有数据都能达到同样比例。
2. 性能展示:区分向量计算库与向量数据库
课程把性能分成两层:向量计算库主要负责索引和检索计算;向量数据库还需要提供数据管理、容灾和高可用等能力。因此,计算库的成绩与整个数据库的查询表现需要分开看。
| 测试 | 课程展示的内容 |
|---|---|
| ANN Benchmark | OceanBase 使用的 VSAG 向量库,在 GIST 960 维数据集上的召回率与查询吞吐对比;课件标注较原榜首提升约 80% |
| VectorDB Bench | 比较 OceanBase、Milvus 和 pgvector,在相同召回率目标下,观察不同并发度对应的 QPS |
VectorDB Bench 课件给出的条件是 22 核、174 GB 内存,768 维、100 万条数据,召回率 90%。图中横轴是并发度,纵轴是 QPS(每秒处理的查询数量);这组结果中,OceanBase 在较高并发下表现出明显的吞吐优势。
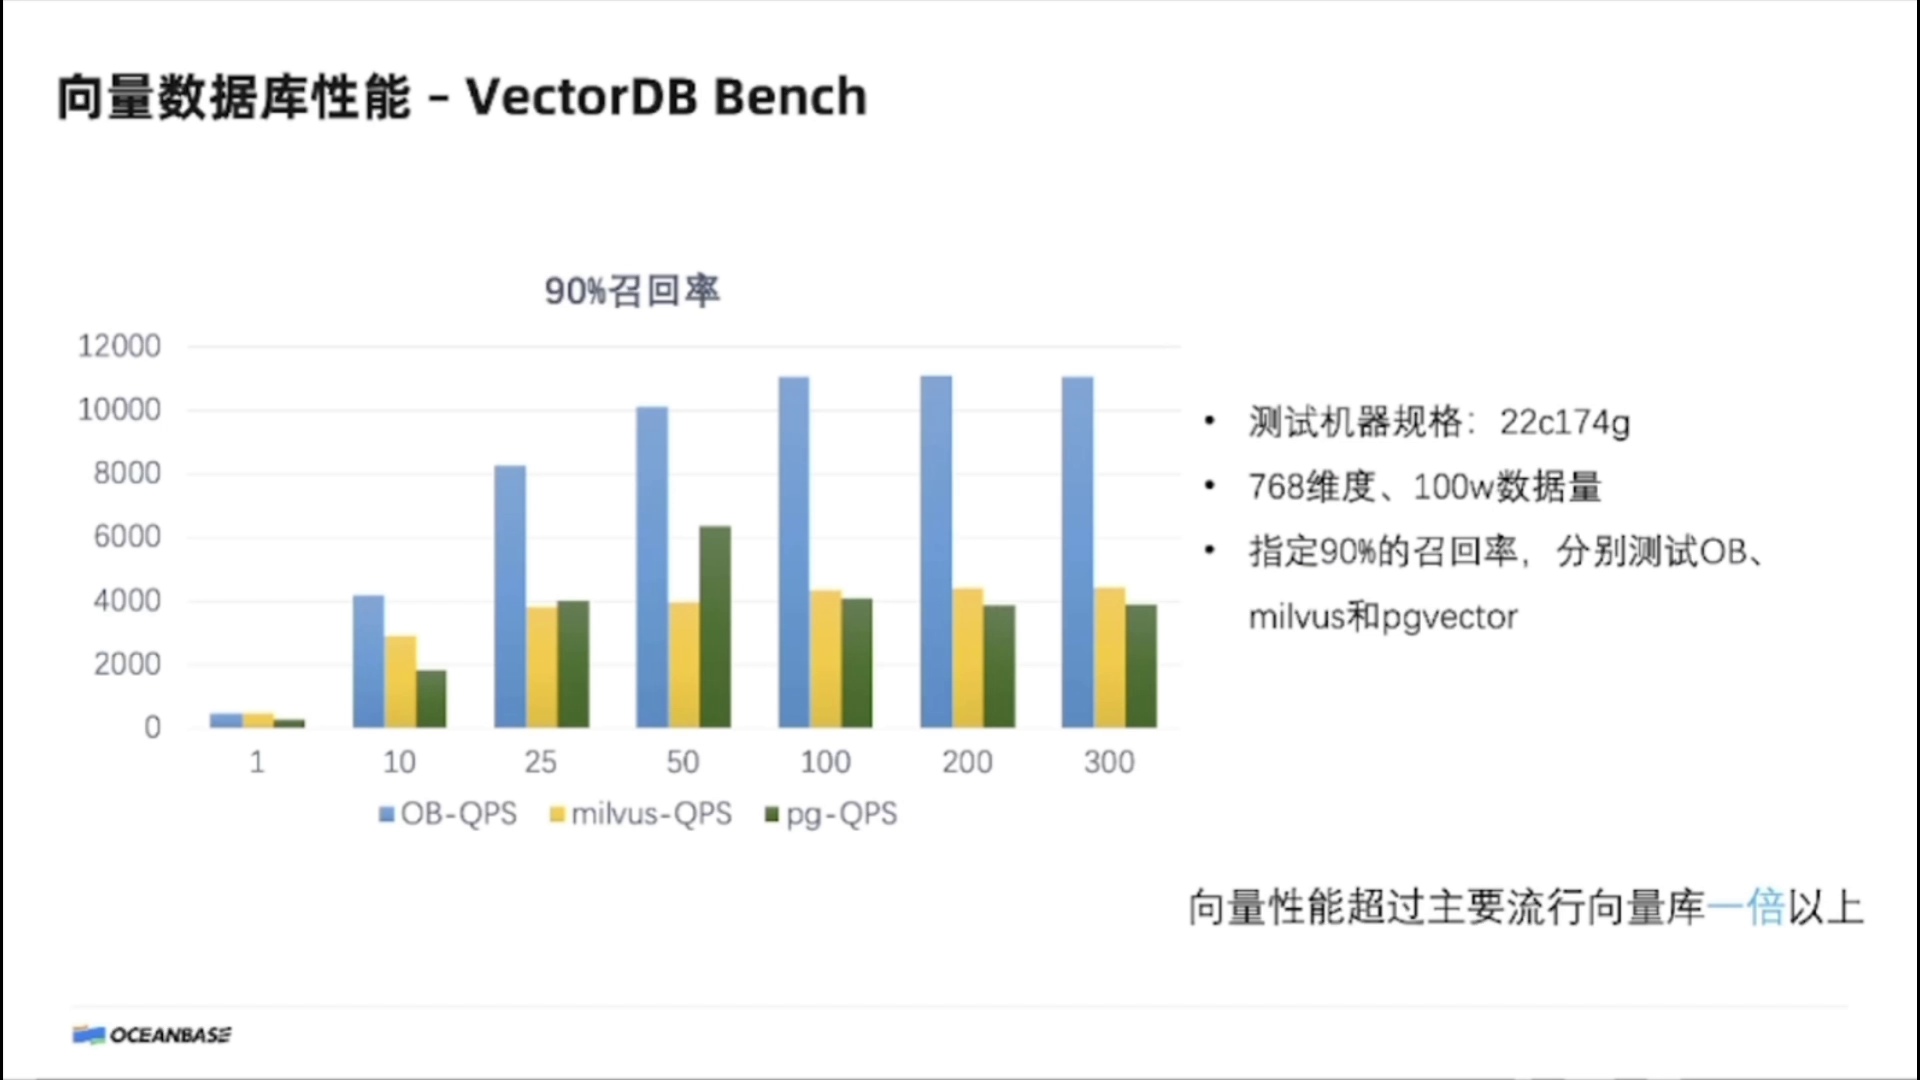
这里需要同时看召回率和速度:把召回率目标固定后再比较吞吐,结果才更有参考意义。这些是课程给出的特定测试结果,不代表当前排行榜或所有业务场景的表现。
3. RAG 中的混合检索与 OceanBase 的整合方向
向量、全文与重排
课程在 RAG 部分强调了三个环节:
- 向量检索:从语义相似性寻找相关内容。
- 全文检索:从关键词匹配补充召回。
- Rerank(重排):对召回的候选重新排序,得到最终结果。
标量检索:对传统结构化数据(如数字、字符串、布尔值、日期等单值或离散值)进行的精确或范围查询。
讲者介绍,向量与全文两路召回,再进行重排,是客户中较成熟的一种使用方式。OceanBase 的全文能力包括中英文分词、自然语言和布尔查询模式,以及增量数据更新。课程中的全文性能对比显示,它在部分高频词、大结果集和布尔查询场景中有优势,小结果集则不一定更快。
多种查询为什么需要放在一起
课程用找咖啡店的例子说明混合检索:希望店铺在 500 米内、平均消费不超过 10 美元、评分不低于 4.5,并且不需要排队。
距离对应空间查询,消费与评分对应标量过滤;“不需要排队”则可以通过评论内容的语义检索寻找线索。多个条件共同构成一次业务查询。
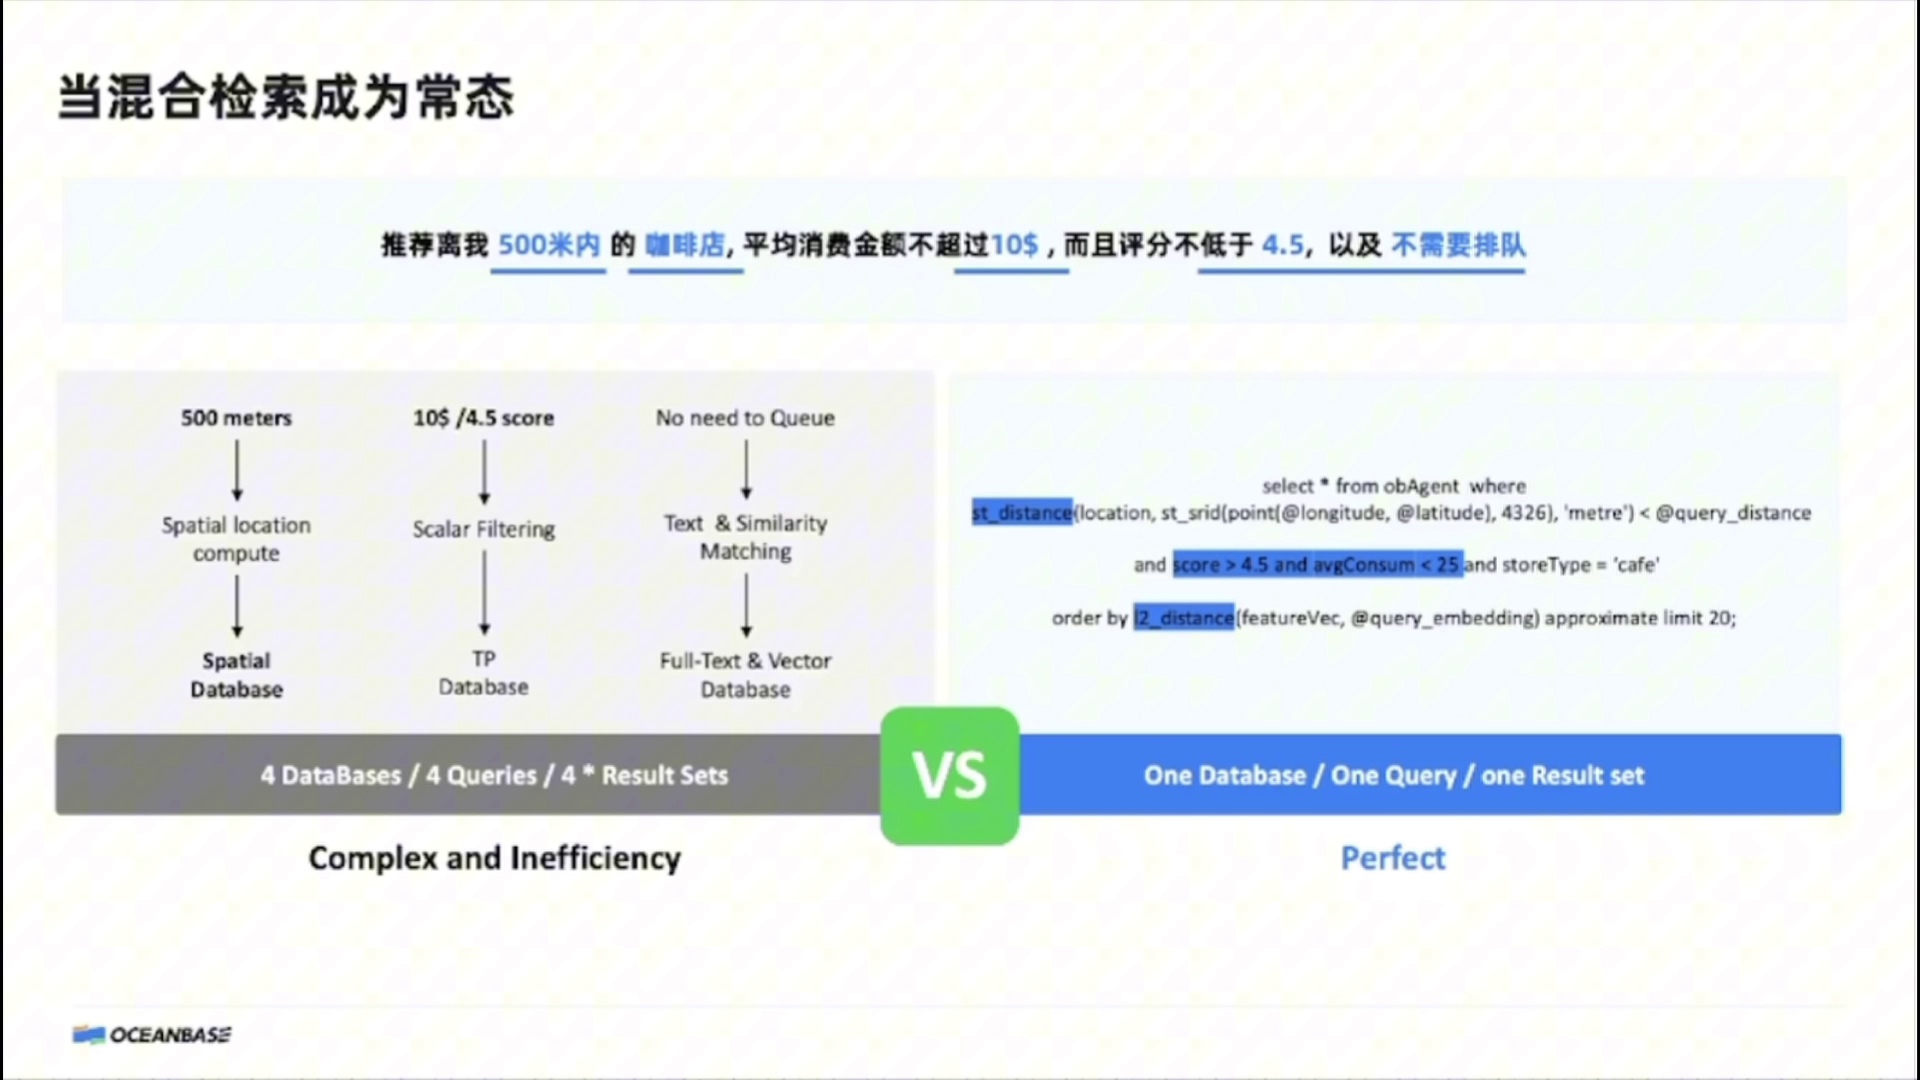
如果数据分散在不同系统中,应用需要分别查询,再过滤、合并结果。OceanBase 的一体化多模能力希望把这些工作尽量放在同一数据库内,减少应用侧的拼接逻辑。
课件中的当前能力与正在实现的方案
这一部分需要区分“数据库具备多种检索能力”与“所有检索、重排都能在一条 SQL 中完成”。
| 录制时的当前方式 | 课件中正在实现的方向 |
|---|---|
| 应用调用 Embedding 模型,生成向量并写入数据行,再创建向量索引 | 数据库托管模型或接收模型服务入口,在内部生成向量并维护索引 |
| 向量与标量可以混合查询;全文检索另行调用 | 将向量、标量和全文整合进一条 SQL |
| 上层应用对多路召回结果进行重排 | 将 Rerank 也整合到数据库内部 |
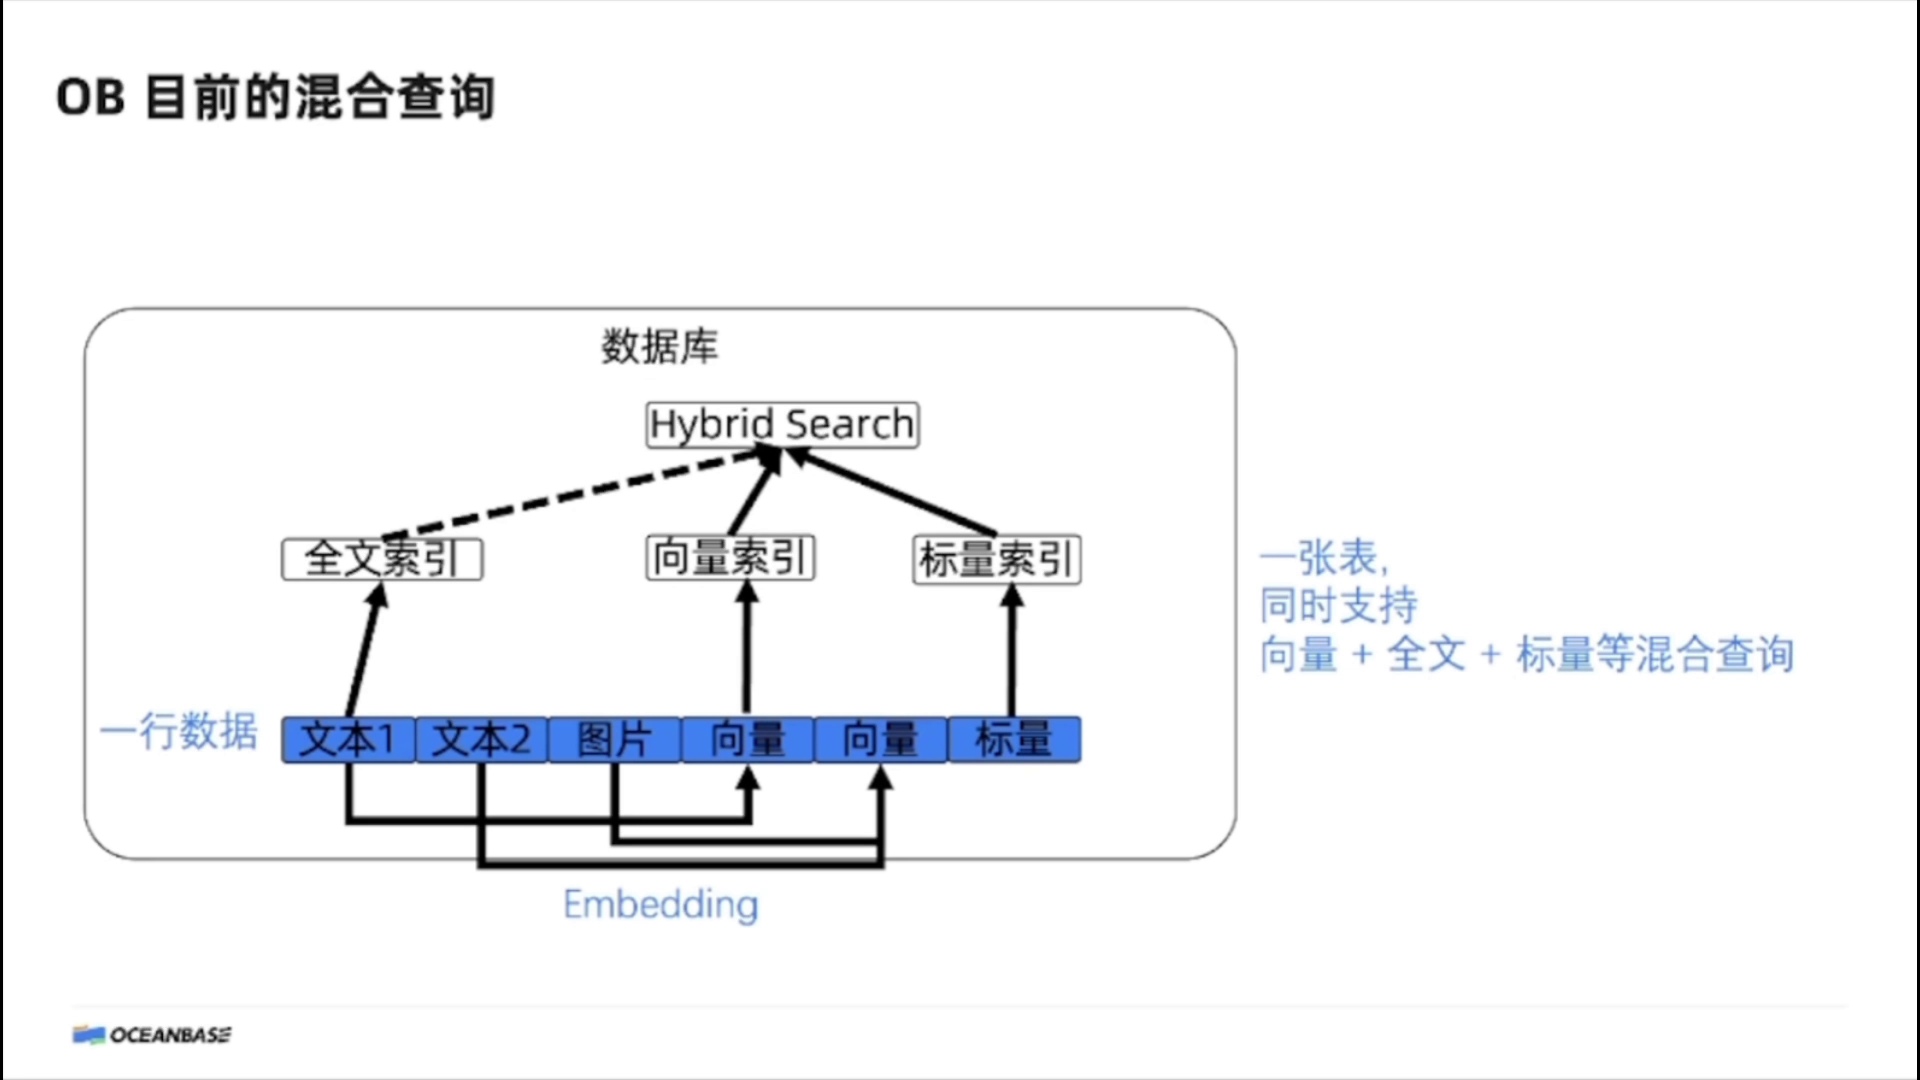
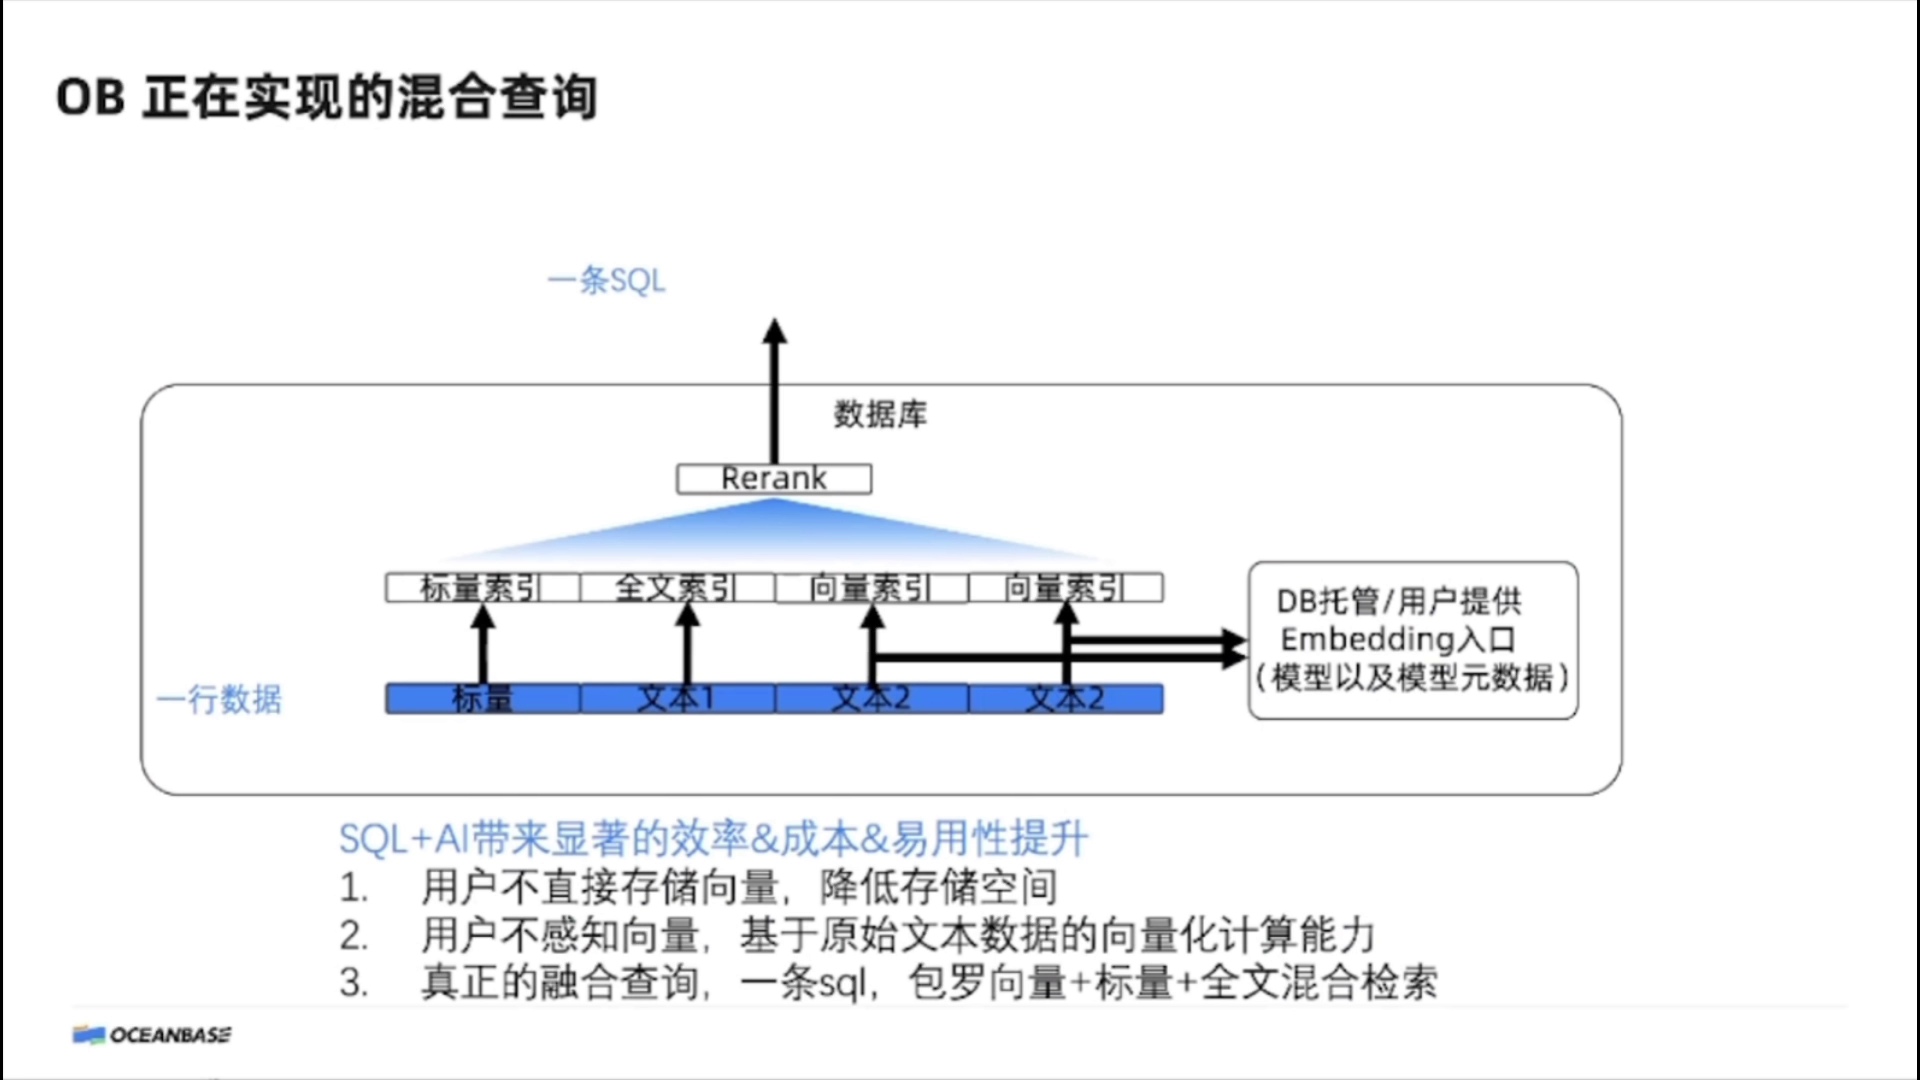
讲者提到,写入与查询如果使用了不一致的 Embedding 模型,可能导致召回效果很差。由数据库统一管理模型入口和向量生成流程,可以减少应用侧配置与调用出错的机会。
我的理解是,这个方向希望让用户更多地面向原始文本和 SQL 操作,由数据库负责向量生成、索引和多路检索。用户不再直接维护向量字段,并不意味着底层不需要向量计算。
课程最后简要介绍了生态对接,包括 Dify、LangChain、LlamaIndex、DB-GPT、Alibaba Spring AI、FastGPT、CAMEL AI 等。其中 Dify 部分提到向量数据库对接和 MySQL 协议适配。这一讲主要介绍能力与方向,没有展开具体接入操作或逐题讲解比赛要求。