第5讲:SQL 与 AI 函数的设计与执行学习笔记
发布于
学习资料:OceanBase《2026 从 0 到 1 数据库实践教程》第五讲
主讲人:王泽林(OceanBase 开源研发专家)
记录日期:2026 年 9 月 7 日
按课程讲解与课件整理;函数行为为课程所述实现,SQL 示例尚未自行运行。
1. AI SQL 函数:在 SQL 中使用模型能力
这一讲的核心是让数据库通过 SQL 表达式调用模型,把数据库中的文本、检索结果等数据直接用于向量化、重排或生成,减少应用侧对数据与模型调用的组织工作。
| 函数 | 用途 | 课程展示的返回结果 |
|---|---|---|
AI_EMBED | 将文本转换为向量 | 序列化的向量数组,返回类型为 VARCHAR |
AI_RERANK | 按查询与候选内容的相关性重新排序 | JSON 形式的重排结果 |
AI_COMPLETE | 根据 Prompt 和上下文生成文本 | LONGTEXT 文本 |
我的理解是,SQL 负责选择和组织数据,模型负责完成相应的 AI 计算。这里介绍的执行路径会通过 HTTP 调用外部模型服务,并非数据库自身在内部完成模型推理。
使用前先注册模型与端点
课件示例通过 DBMS_AI_SERVICE.CREATE_AI_MODEL 注册逻辑模型,再通过 CREATE_AI_MODEL_ENDPOINT 配置对应的服务端点:
- 模型配置:逻辑名称、任务类型以及服务侧模型名称,例如
dense_embedding、rerank、completion。 - 端点配置:关联的逻辑模型、服务 URL、Provider 和访问凭证。
函数调用使用逻辑模型名称,由数据库找到具体服务。配置完成后,课程中的三个调用示例可以整理为:
SELECT AI_EMBED('ob_embed', '老虎');

SELECT AI_RERANK(
  'ob_rerank', 'Apple',
  '["apple","banana","fruit","vegetable"]'
);

SELECT AI_COMPLETE('ob_complete', '1+1=?');
这些片段依赖事先创建的模型与端点,主要用于理解调用方式。
2. 从 SQL 表达式到模型结果
共同的执行过程
应用发起 SQL
    → SQL 引擎解析表达式、检查参数
    → 校验模型类型与访问权限,解析服务端点
    → Provider 适配器构造认证信息与请求体
    → HTTP 客户端调用模型服务
    → 解析并校验响应,返回 SQL 结果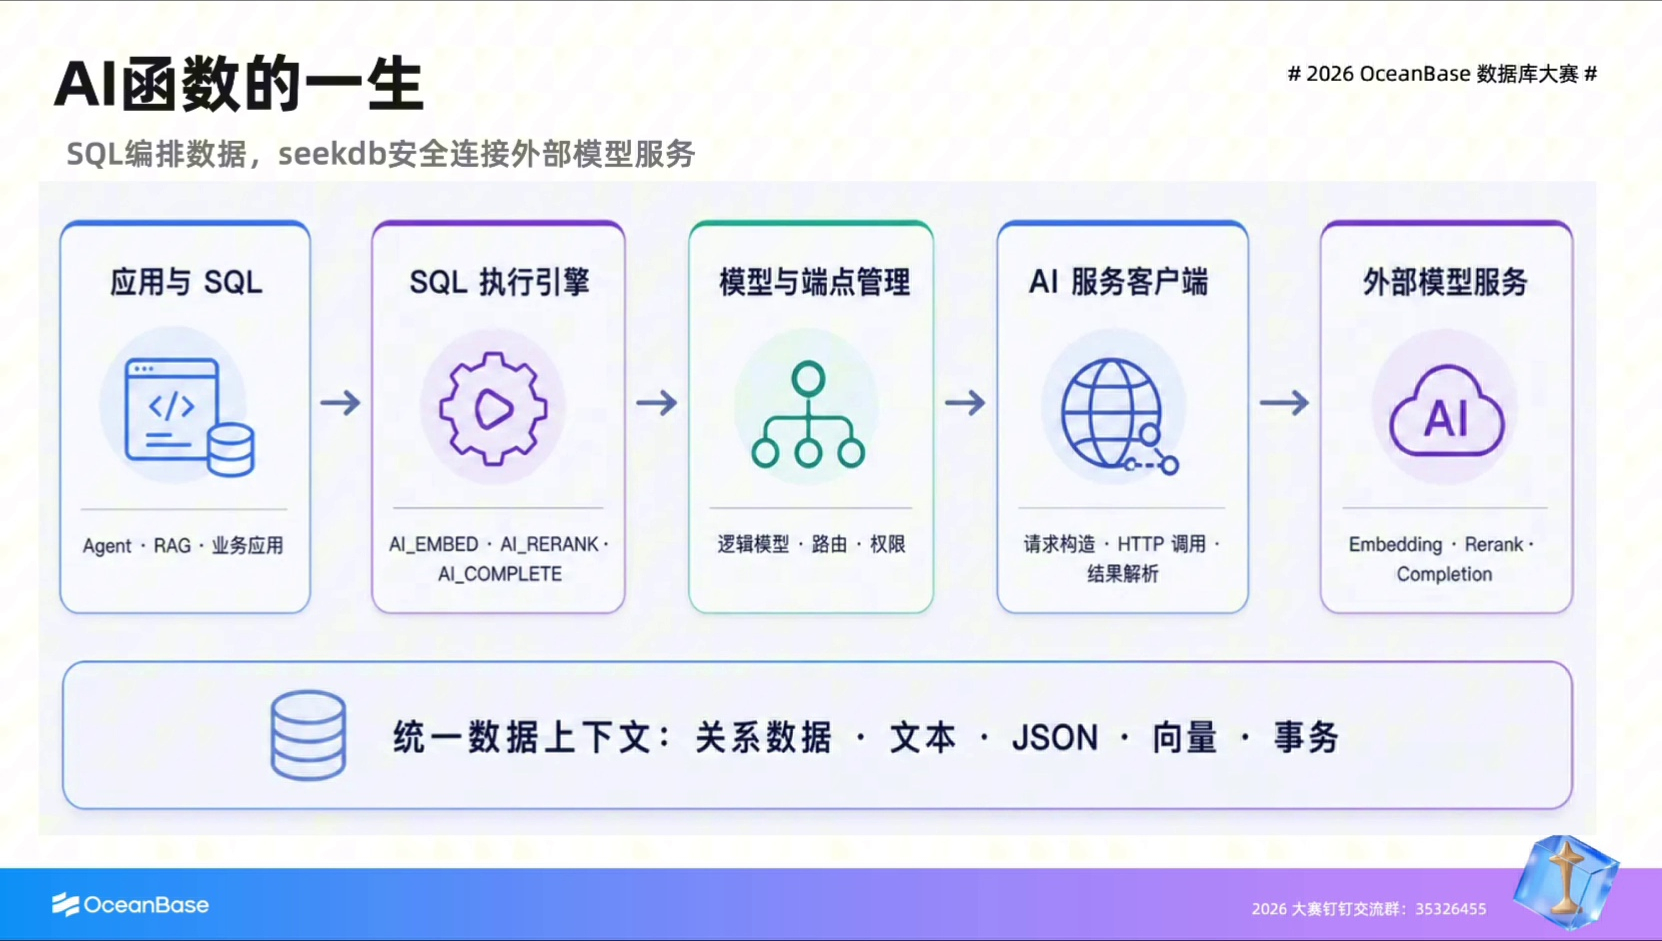
不同 Provider 的请求字段、响应结构可能不同。适配器负责屏蔽这些差异,让上层保持相同的函数接口。课程举例包括 OpenAI-compatible、DashScope 等协议,以及 SiliconFlow 等服务。
模型响应也不能直接作为最终结果使用,还要完成数量、维度或结构校验;涉及批量请求时,需要把响应重新对应到原来的 SQL 行,避免结果错位。
AI_EMBED:文本转换为向量
调用形式为 AI_EMBED(model, content [, dimension])。先检查参数、非空条件和维度,再校验模型是否属于 dense_embedding 类型,以及用户是否具有模型访问权限。
课件对比了两种协议:OpenAI-compatible 使用 input,从 data[].embedding 读取结果;DashScope 使用 input.texts,从 output.embeddings[].embedding 读取结果。最终检查返回数量、按需检查维度,再序列化为向量数组。
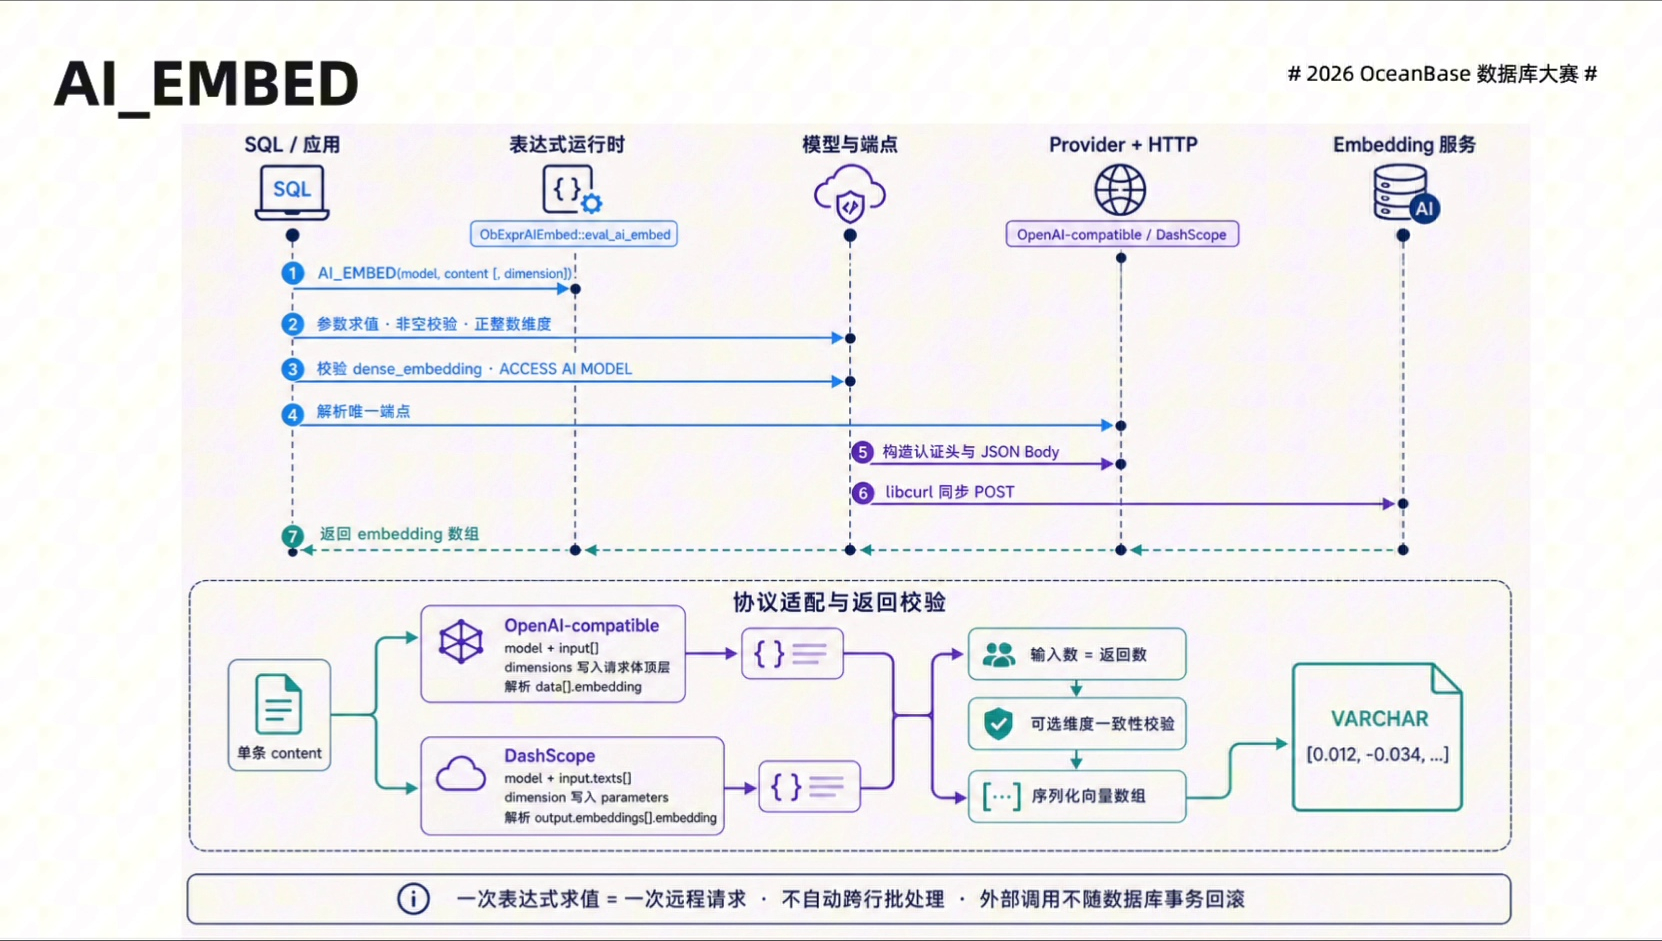
课程展示的这条路径是一次表达式求值发起一次远程请求,不自动跨 SQL 行合并批处理。 这也是后面讨论批量执行优化的出发点。
AI_RERANK:对召回候选重新排序
调用形式为 AI_RERANK(model, query, documents [, doc_key])。它适合放在向量或全文召回之后,对几十到几百条候选进行重排,而不是直接对整张表逐条打分。
课件区分了两条输入路径:
| 输入 | 处理方式 |
|---|---|
| 字符串数组 | 每 20 条顺序分批请求;把批内 index 加上批次偏移,恢复到原候选位置,再按 relevance_score 全局归并 |
对象数组+doc_key | 抽取指定文本字段,全部候选一次请求;保留原对象并添加 _model_score,返回 JSON |
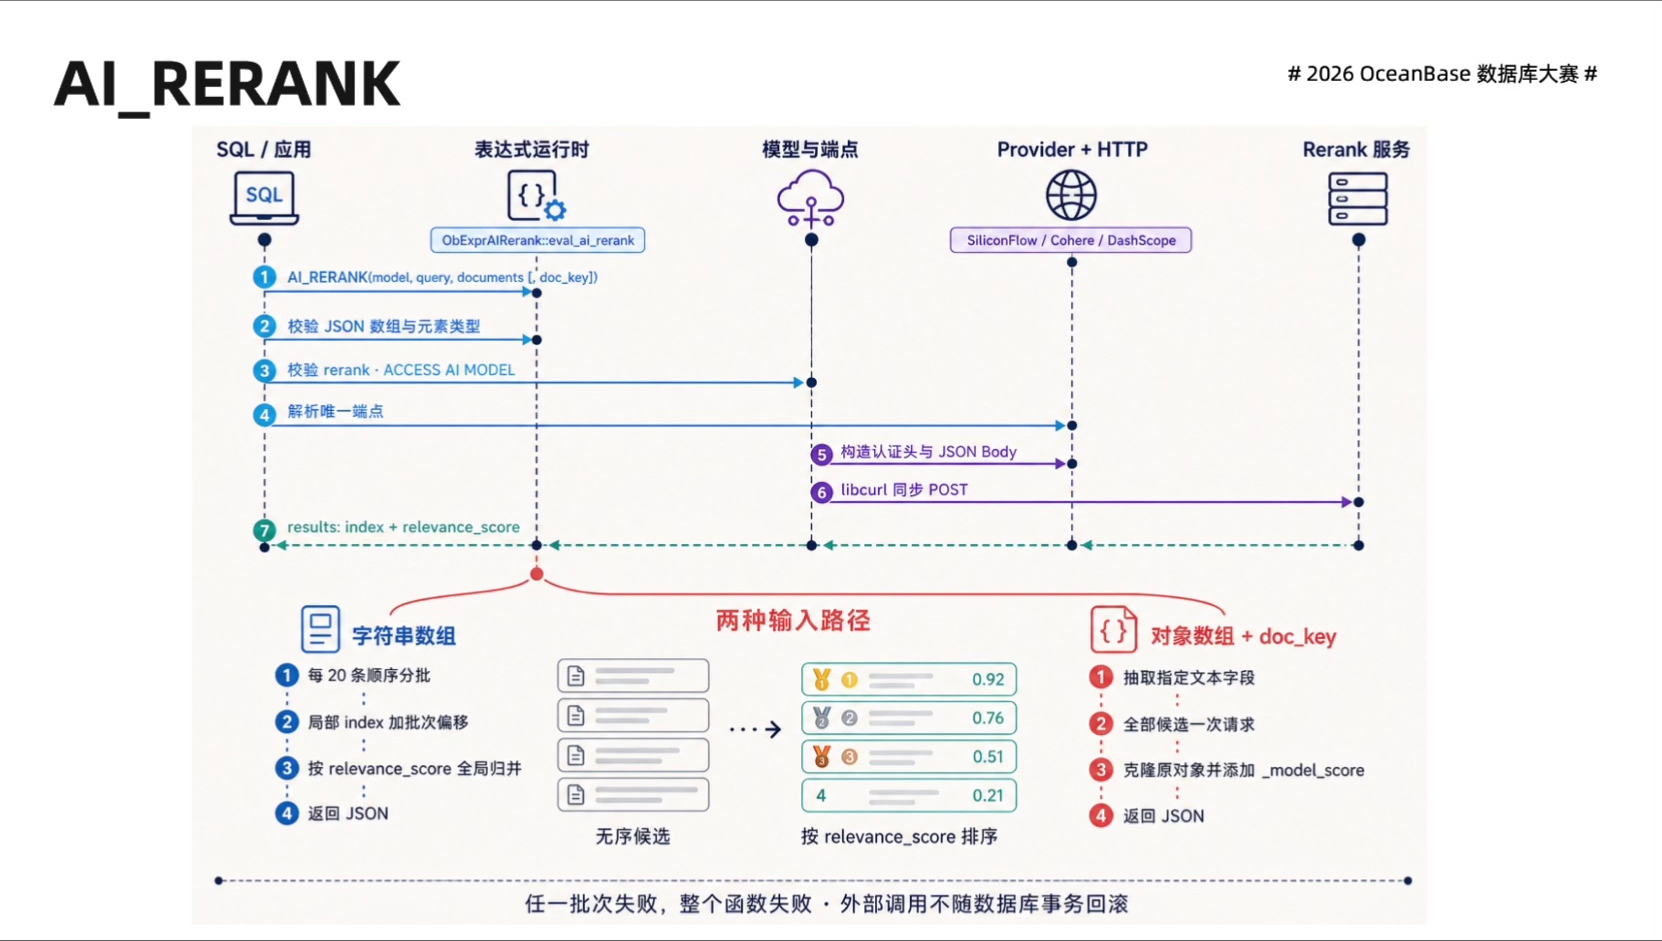
这里的下标映射很重要:分批返回的第 0 条不一定是原数组的第 0 条。课件还说明,任一批次失败,整个函数失败。
AI_EMBED 与 AI_RERANK 课件都提醒:外部调用不随数据库事务回滚。 数据库回滚不能撤销已经发生的模型请求;设计失败处理与重试时,需要考虑已发出的调用。
AI_COMPLETE:组织 Prompt 并返回生成文本
调用形式为 AI_COMPLETE(model, prompt [, config])。Prompt 可以是普通字符串,也可以来自 AI_PROMPT 的模板与参数展开;课程展示的路径最终构造单条 user message,再根据 Provider 协议发送请求。
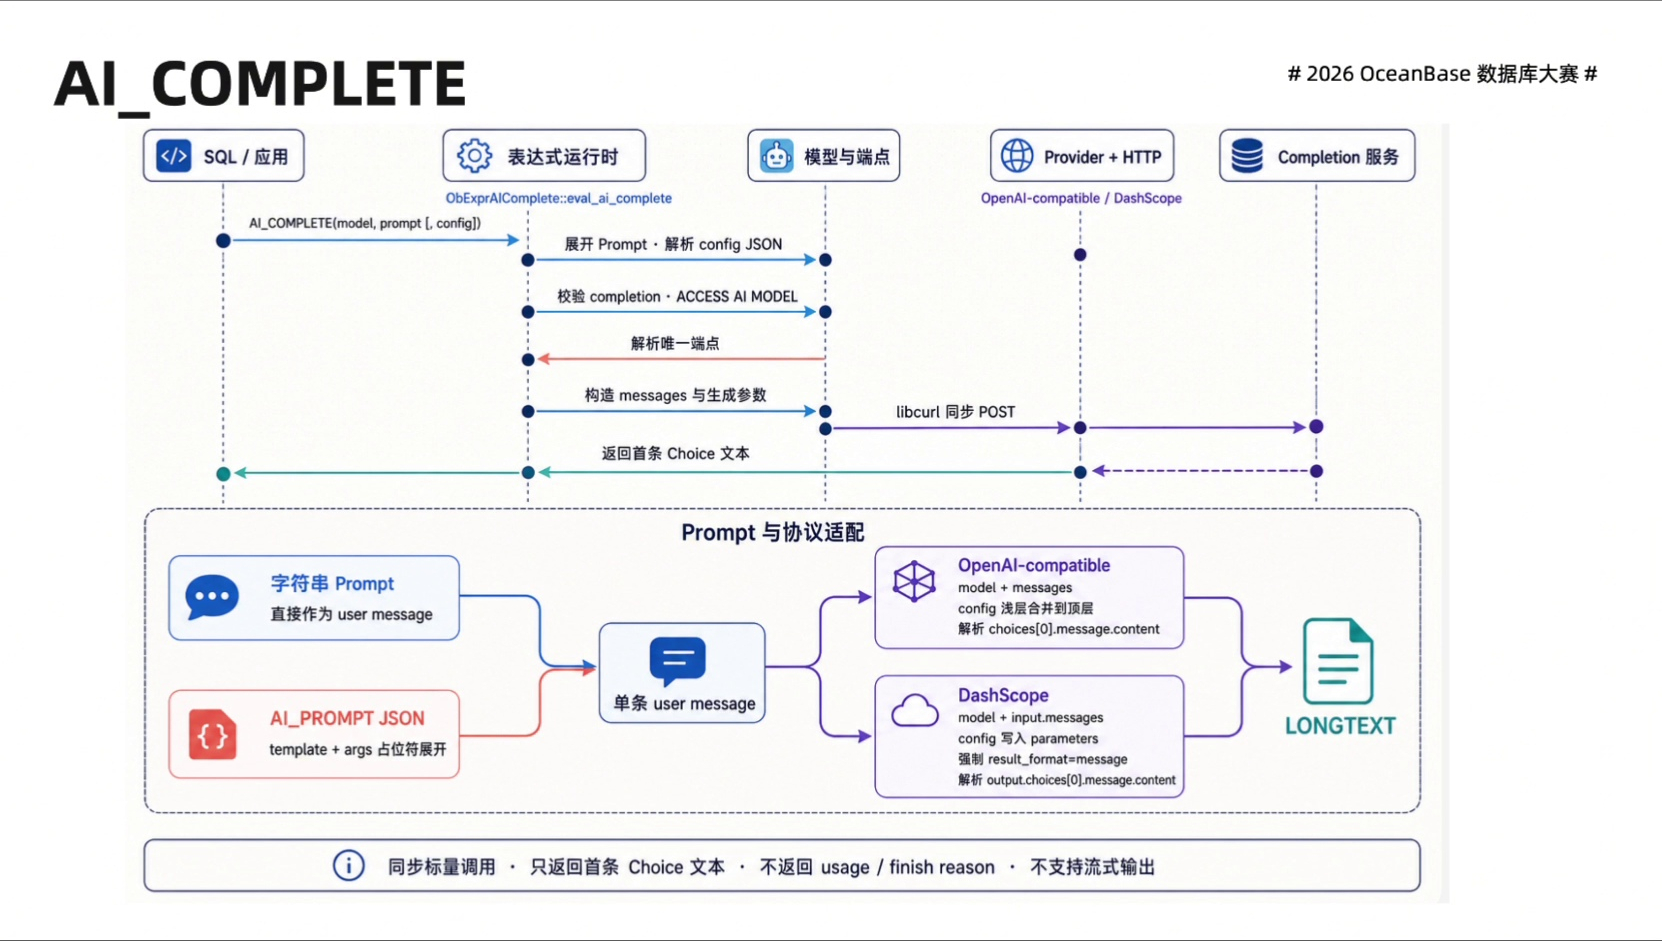
课程中的实现是同步标量调用,返回首条 Choice 的文本,不返回 usage、finish reason,也不支持流式输出。因此,它适合摘要、数据抽取、分类和基于已有证据的单次回答;多轮对话、工具调用等完整应用流程,仍更适合由上层应用调度。
3. AI 函数的比赛出题方向
讲者把这部分题目类比为在已有实现上补齐或增强能力的“填空题”。准备时,需要先理解现有调用链,再定位要修改的是输入处理、协议适配、结果解析还是执行方式。
课程介绍 AI 函数相关方向大约有六个题目、分为三个梯次;由于录制时尚未公布具体题面,课件只保留概括性的增强方向:
| 层次 | 课件列出的方向 |
|---|---|
| 基础能力 | 输入与模板、数据表示、请求与响应 |
| 协议与正确性 | 协议扩展、结果正确性,以及错误的正确处理 |
| 执行效率 | 批量执行,把单次调用改进为更高效的执行方式 |
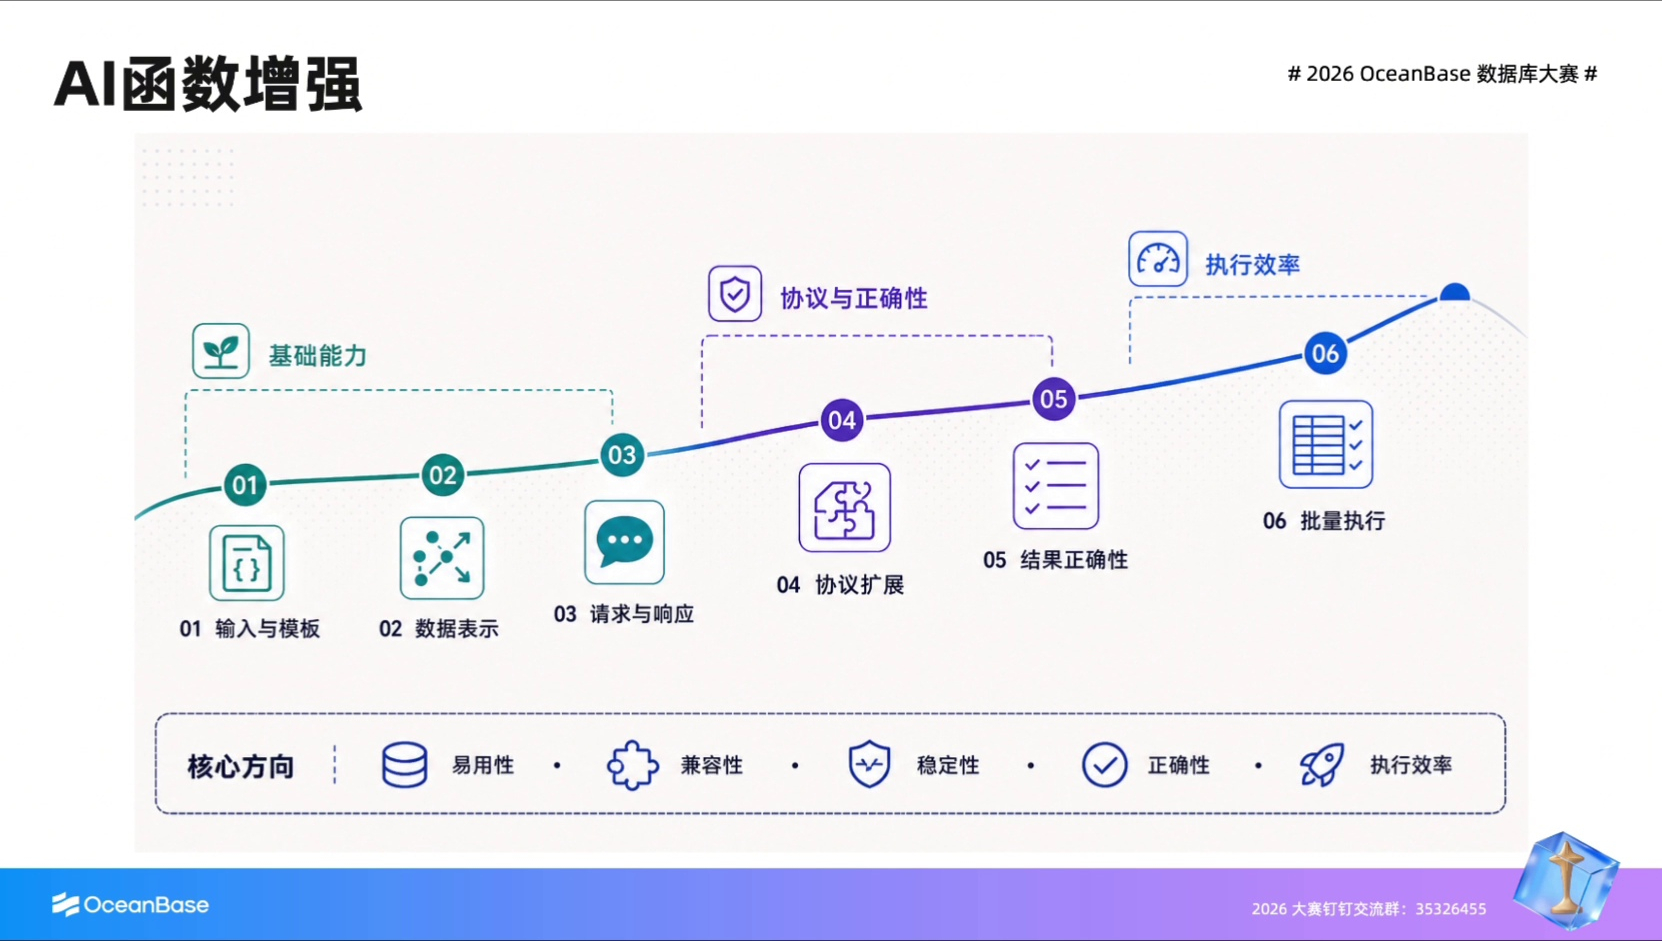
这些方向对应易用性、兼容性、稳定性、正确性和执行效率。我的理解是,优化不能只看模型是否返回了内容,还要确认结果与输入正确对应、错误能够明确传递,以及批量处理没有改变结果含义。
本讲没有给出正式题目编号、分值和完整验收条件。“大约六题”和三个梯次是讲者当时的介绍,不能据此自行补出具体题目。